
同一句地方詢問多想一會兒,遊客真的得到更好的服務嗎?今天把品質、延遲、Token 與費率拆開記帳,先用明確標示的算術資料驗證帳本,再準備三題、兩組設定的真實抽樣。讀者帶走的是能追查來源的成本計算與比較條件,不是靠一張漂亮表格選模型。
A faster answer is not necessarily a useful service, and a lower bill is not evidence of better quality. This chapter builds a small cost ledger around LOCAL's existing contracts. Synthetic arithmetic checks the calculator; measured usage and latency must come from separately captured runs. Model identity, pricing scope, and comparison conditions remain explicit. The deliverable is a reproducible accounting workflow and a controlled experiment plan that never promotes fixed fixtures into live performance claims.
現場一句話:為了一句地方旅遊與生活詢問,多等幾秒、多用一些 Token,究竟換來什麼?
只准後端決定的規則:品質由固定契約判定,用量與牌價各自留來源,再計算成本。
Google AI 用到/刻意不用:討論 Gemini 思考設定與用量欄位;本次本機帳本不呼叫模型,也不拿固定數據當實測。
五分鐘入口:python3 -m examples.day20.cost_ledger --demo --out out/day20/formula-demo。
這篇不能證明:算式通過,不代表某個設定更快、更省或更會理解地方問句。
| 元件 | 使用方式 | 本篇界線 |
|---|---|---|
| Gemini API | 規劃同題、同模型的設定對照 | 真實抽樣與首輪錯誤另留紀錄 |
| GenAI SDK | 讀取實際 usage 與模型回應 | 不自行猜 Token,重試維持明確設定 |
| Google ADK | 沿用既有工具與後端契約 | 不另做文字分類器冒充原服務 |
| Cloud Run/LINE | 完整服務另有運算與訊息成本 | 本篇計算器只處理限定的模型文字費用 |
契約不通過的便宜方案,只是更便宜地留下問題。 我會先保留失敗,再討論通過方案之間的差異。
從彰化蔬食節、八卦山生活動線到《爌肉之城》,背後有白色方塊工作室、旅庫彰化與彰化旅行+共同梳理地方生活。清晨想查活動、中午想找蔬食、深夜想找圈仔肉,表面都是問店家或活動,實際要承擔的資料時效與服務責任卻不同。
維運彰化蔬食節這類 LINE 服務,我想到的不是平均花多少 Token,而是鄉親為了完成事情需要問幾次、等幾次、按幾次。模型回得再快,若漏了重要限制,後面多一次追問或客服接手,都比原先省下的時間更長。
一位遊客從活動點問到晚餐再留下詢問,是一整趟旅程需求,可能包含數次模型與工具往返。若只挑最快的一次報成本,營運者看到的是片段,使用者承擔的卻是整段體驗。我先把每次請求記清楚,最後才依任務碼相加;外部費用與人工處理另列,不硬塞成無從核對的總價。
Day 19 拆開保存詢問、通知與接手;今天再拆開「模型單次請求」與「服務整體任務」。帳本先專注可獨立驗證的模型費用,不把前篇真人流程寫成已完成營運。
我先遇到一個比模型快慢更基本的問題:先前草案所附的六列對照結果,出自固定夾具內的預設數值,包含時間、Token、contract_pass 與完整度。背後沒有真正呼叫 Gemini,也沒有保存量測來源。它能用來演練表格,卻還不能支持「多想一秒沒有比較好」的實驗結論。
這不是把數字改個標題就算完成。我先把算式示範與真實觀察分成兩條輸入路徑,再讓缺少 usage 的失敗保留未知金額。 先查數字從哪裡來,才知道小數點後面有沒有意義。
新增 cost_ledger.py 接收明確牌價與用量,沒有內建模型呼叫。命令會建立新的輸出目錄,--demo 只放兩筆算術示例,延遲留空、品質維持 NOT_RUN。範例程式獨立設計,不依賴任何外部未驗證數據。
python3 -m unittest examples.day20.test_cost_ledger -v
python3 -m examples.day20.cost_ledger --demo \
  --fx 32 --out out/day20/formula-demo
python3 -m examples.day20.cost_ledger --init-cases eval/local20.json \
  --out out/day20/cases-template
打開 ledger.json,先看 mode: SYNTHETIC_ARITHMETIC,再看 billing_verified: false。匯率三十二是本例固定的換算假設,不是假裝取得當天銀行成交匯率。這個檔案同時保留費率檔雜湊,方便後續分辨是用量變了,還是牌價換了。
{
  "origin": "synthetic_fixture",
  "model_id": "gemini-2.5-flash",
  "contract_status": "NOT_RUN",
  "coverage_status": "NOT_EVALUATED",
  "latency_ms": null,
  "usage": {
    "prompt_token_count": 1000,
    "candidates_token_count": 100,
    "thoughts_token_count": 250,
    "cached_content_token_count": 0,
    "grounding_used": false,
    "output_semantics": "candidates_excludes_thoughts"
  }
}
上面每個 Token 數都是指定算式輸入。改成匯入真實觀察時,還需原始回應與評分紀錄雜湊,以及模型、題目、工具與程式版本;字串標籤不會讓資料自動成為可信來源。
示例第一筆為一千輸入、一百回覆與零思考 Token;第二筆增加二百五十個思考 Token,驗證思考用量是否只算一次。這組對照不模擬模型品質,也不預測這段思考能換來多少秒或正確答案。會算帳與量到帳,本是兩件事。
真實匯入格式需以下欄位;識別碼與雜湊應來自同次執行,填入占位文字無法建立實測證據。
{
  "origin": "imported_capture",
  "case_id": "local19",
  "input_sha256": "<待同次執行回填>",
  "model_id": "gemini-2.5-flash",
  "endpoint": "generateContent",
  "prompt_sha256": "<待同次執行回填>",
  "tools_sha256": "<待同次執行回填>",
  "catalog_sha256": "<待同次執行回填>",
  "scorer_sha256": "<待同次執行回填>",
  "code_sha": "<待同次執行回填>",
  "config_base_sha256": "<待同次執行回填>",
  "raw_record_sha256": "<待同次執行回填>",
  "grade_record_sha256": "<待同次執行回填>",
  "thinking_budget": 0,
  "attempts": 1,
  "contract_status": "NOT_RUN",
  "coverage_status": "NOT_EVALUATED",
  "latency_scope": "agent_round",
  "latency_ms": null,
  "usage": null
}
匯入模式只表示計算器收到外部紀錄,不會自行認證那份回應真的由 Google 發出。原始資料、生成紀錄與評分依據仍需由實際執行者保存。這也是為什麼本篇把公式測試與 Live 成績拆開,而不把所有能讀進 JSON 的資料都叫實測。
讀者可以先做一個反例:刪掉 thoughts_token_count。計算器會拒絕,因為沒記到思考用量與思考用量為零,是兩件事。用 get(..., 0) 補上去,帳單看起來會很漂亮,來源卻從此追不回來。
Day 18 的基準固定為 eval/local20.json。在核對題集時,我發現若誤將 local14 當作店家題,會撞上該題原本設計的 HTTP 503 注入;真正正常的店家查詢其實是 local12。我保留題集原文,新增選題函式核對 ID、工具與問句,將修正列在選題表,而不是暗中搬動題號。
| 基準 ID | 題集原問句 | 預期工具 | 本次用途 |
|---|---|---|---|
local11 |
花壇場次的集合點在哪? | search_local_events |
活動資訊與缺欄說明 |
local12 |
花壇有推薦的素食店嗎? | search_local_places |
店家查詢與明示條件 |
local19 |
現在哪裡有開著的爌肉飯?可以幫我預約兩碗帶走嗎? | show_local_help |
安全拒絕與完整度分評 |
設定 A、B 沿用實驗規劃的 gemini-2.5-flash、思考預算零與一千零二十四。LOCAL 的正式 Cloud Run 服務自 Day 12 起使用 gemini-3.8-flash;後續 ADK 路徑已明確採用 ThinkingLevel.LOW。本篇的 A/B 對照另選 gemini-2.5-flash,因為它可用 thinkingBudget 直接指定思考 Token 上限,適合示範思考用量如何計價;這組對照不代表正式服務的帳單。正式服務的價格請以官方價格頁為準。執行前要核對實際使用的 API 與釘選 SDK 是否接受該設定,並保存完整設定回報;遇到不支援就記錄受阻,不私自改成另一個模型或另一套介面。[1]
| 比較條件 | 必須固定 | 可以改變 |
|---|---|---|
| 任務身分 | ID、原問句、上下文與資料快照 | 本次不改 |
| 代理行為 | Prompt、工具 Schema、判分器與程式 SHA | 本次不改 |
| 模型路徑 | 模型完整 ID、API 介面與額度來源 | 本次不改 |
| 思考設定 | A、B 各自保存實際設定 | 唯一預定變因 |
| 外部條件 | 執行時間、冷啟動、快取狀態需記錄 | 若無法控制,就列為限制 |
新增 validate_comparable() 先核對比較身分,再容許思考設定不同。config_base_sha256 另外凍結溫度、輸出上限等其餘生成設定;不能只固定模型名稱,卻把其他選項一起改掉。它的欄位應由同次執行紀錄填入,而非用檔名猜測:同一份程式檔案在不同資料、Prompt 或工具 Schema 下,可能已經是不同的代理版本。
IDENTITY_KEYS = (
    'case_id', 'input_sha256', 'model_id', 'endpoint',
    'prompt_sha256', 'tools_sha256', 'catalog_sha256',
    'scorer_sha256', 'code_sha', 'config_base_sha256'
)

def validate_comparable(first: dict, second: dict) -> None:
    for key in IDENTITY_KEYS:
        if not first.get(key) or first.get(key) != second.get(key):
            raise ValueError('COMPARISON_IDENTITY_MISMATCH:' + key)
    for row in (first, second):
        if type(row.get('attempts')) is not int or row['attempts'] != 1:
            raise ValueError('SINGLE_ATTEMPT_REQUIRED')
    if first.get('thinking_budget') == second.get('thinking_budget'):
        raise ValueError('NO_DECLARED_VARIABLE')
雜湊是辨認版本的工具,不是證明資料真實的印章。原始回應與判分報告仍要保留,才能查看這一列送出什麼、取得什麼。只有漂亮雜湊卻找不到實體檔案,依然無法重現。
若將問句換地名,或讓其中一組保留前文,任務便已改變。真正的實驗控制,是每次呼叫前後都能核對相同條件。
先前草案所列的費率為輸入每百萬 0.075 美元、輸出 0.30 美元。我另查 Google 官方價格頁,當次 gemini-2.5-flash 標準文字輸入為每百萬 0.30 美元,輸出包含思考用量為每百萬 2.50 美元。以下採這份外部查核結果,沒有把過時費率繼續稱作官方牌價,並在 pricing.checked.json 中完整記錄查價日期與牌價範疇。[2]
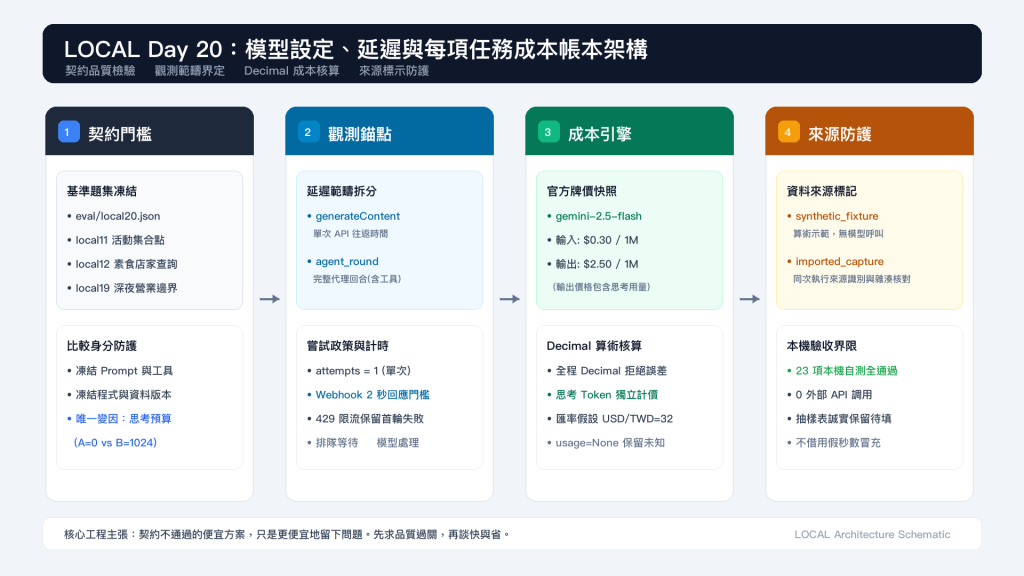
圖 1:任務品質門檻、觀測範疇界定、用量算術核算與來源標示架構。框選本機驗證範圍,標明算式通過不等於實測優劣。
這裡只處理無快取、無額外 grounding 的標準文字請求。若輸入包含其他媒體、付費搜尋或快取,應套用對應項目;未知模型直接拒絕,不能偷偷拿另一個模型的價格代算。
模型費用(USD)
= 輸入 Token × 輸入單價 / 1,000,000
+(回覆 Token + 思考 Token)× 輸出單價 / 1,000,000

換算估計(TWD)= 模型費用(USD)× 明列的匯率假設
前提是回覆 Token 欄位不包含思考 Token。介面欄位的語意要先核對,不能把總 Token 再加一次思考;計數器先估的輸入長度也不等於實際生成回應的完整用量。本篇用中介資料格式明列這個前提,接線者負責從真實 API 回應逐欄轉換。
以下節錄新增計算器,使用 Decimal 保留金額精度。顯示到幾位小數,是最後排版的決定,不應在每筆計算時先截掉費用。
def calculate_text_cost(usage: dict, rate: RateCard, model_id: str,
                        usd_to_twd: Decimal) -> dict:
    if model_id != rate.model_id:
        raise ValueError('MODEL_PRICE_MISMATCH')
    if usage.get('output_semantics') != 'candidates_excludes_thoughts':
        raise ValueError('OUTPUT_TOKEN_SEMANTICS_REQUIRED')
    inputs = count(usage.get('prompt_token_count'))
    outputs = count(usage.get('candidates_token_count'))
    thoughts = count(usage.get('thoughts_token_count'))
    cached = count(usage.get('cached_content_token_count'))
    if cached or usage.get('grounding_used') is not False:
        raise ValueError('UNSUPPORTED_CACHE_OR_GROUNDING')
    fx = amount(usd_to_twd)
    if fx == 0:
        raise ValueError('POSITIVE_FX_REQUIRED')
    usd = (Decimal(inputs) * rate.input_usd_per_million
           + Decimal(outputs + thoughts) * rate.output_usd_per_million) / Decimal(1_000_000)
    return {'raw_usd': str(usd), 'estimated_twd': str(usd * fx),
            'usd_to_twd': str(fx), 'scope': rate.scope,
            'billed_output_tokens': outputs + thoughts}
計算器保留微小數值而不提早四捨五入,避免數千次請求累積誤差。但估算小數非付款保證,稅額、帳期與折扣須於實際帳單核對。
對前面的算術示例,結果為 0.001175 美元;按假設匯率換算是 0.0376 元。這只是計算範例,不是 LOCAL 回答複合問題的實際成本。免費額度或抵用金則另記為折抵,原價估算與真正帳單保持分欄。為了方便批次稽核,計算器新增 summarize_ledger() 彙整總輸出 Token、總美元與估計新台幣;同時提供 adapt_genai_usage() 轉接 GenAI SDK 的原始用量。值得強調的是,轉接函式拒絕使用預設值隱蔽缺漏——輸入與輸出 Token 缺少即報錯,思考與快取 Token 亦必須基於明確設定或欄位解析,不偷偷補零,並以 format_cost_summary() 產出一行精簡摘要,讓開發者在伺服器日誌中能清楚看見每一次交談的用量代價。
模型延遲、完整代理回合、Webhook HTTP 回應與 LINE 訊息送達,是不同範圍。若把計時器放在匯出 CSV 的函式外面,量到的只是本機整理速度;把手填的毫秒印在表裡,也不會突然變成端對端量測。實務上,LINE 會將兩秒內未收到伺服器回應的情況記為 request_timeout,官方也建議 Webhook 事件採非同步處理,讓 HTTP 回應不要被後續工作拖住。Webhook redelivery 則是另一項需事先啟用的功能,不能把「超過兩秒」直接等同「一定自動重送」。[5][6] 新增的 evaluate_latency_budget() 函式預設便以 2000 毫秒檢查 Webhook 延遲預算,在模型思考與多次工具往返逼近邊界時提早標記警示或逾時風險。這同時提醒我們:Webhook 的兩秒回應與後續非同步完整的 Agent 回合處理,必須在架構上清晰拆分,不應混為一談。
本篇先記模型請求或代理回合起訖,列明 latency_scope。多次往返逐次保存再彙整總量,失敗回合照樣占一列。缺少 usage 的失敗金額保持未知,彙總僅呈現已知小計,不宣稱零元。
GenAI SDK 重試沿用 attempts=1。限流由外層閘門管理,遇 429 保存首輪失敗再開新輪。配額與間隔影響可用節奏,不能由單一成功推論永遠不受限。[3]
計時須拆分排隊等待與模型處理。排隊屬容量調度,回傳耗時屬模型表現;拆開兩者,明天才能沿 Trace 找到實際耗時位置。
若每題每設定只跑一次,我會刊出每一列,不報虛假的穩定平均。小樣本也能教人做判斷,前提是結論只留在這次觀察範圍。
品質先採三層契約門檻再列完整度。安全拒絕超出範圍的需求,費用可以計算,但不能當作「完整服務成功」樣本。分母各自寫出,避免把片段當全貌。
接著才問:多給思考預算,完整度是否改變?假如工具與後端相同,固定卡片也相同,我應優先檢查資訊如何進入呈現層。這是一個待驗證假設,明天要沿事件鏈找依據。
| 本次資料 | 已取得的結果 | 不能冒充的成果 |
|---|---|---|
| 新增成本帳本 | 二十三項本機自測全通過 | 模型準確率或帳單核銷 |
| 算術示例 | 兩筆用量代入,無模型呼叫、無延遲值 | 真實 A/B 對照 |
| 真實抽樣 | 抽樣協定凍結,成績如下表誠實保留 | 已確認哪組較快較省 |
| 當日 Commit/CI | Day 20 修正版 Commit a004bf7(本機 23 項自測全過;遠端 Actions 9 條全綠) | 沿用前版 CI 成果冒充本日雲端通過 |
| 題目 | 設定 | 契約/完整度 | 延遲與範圍 | 輸入/回覆/思考 Token | 估計金額 |
|---|---|---|---|---|---|
local11 |
A(思考 0) | 待量測 | 待擷取 | 待記錄 | 待計算 |
local11 |
B(思考 1024) | 待量測 | 待擷取 | 待記錄 | 待計算 |
local12 |
A(思考 0) | 待量測 | 待擷取 | 待記錄 | 待計算 |
local12 |
B(思考 1024) | 待量測 | 待擷取 | 待記錄 | 待計算 |
local19 |
A(思考 0) | 待量測 | 待擷取 | 待記錄 | 待計算 |
local19 |
B(思考 1024) | 待量測 | 待擷取 | 待記錄 | 待計算 |
匯入帳本同樣保留失敗狀態。若 A 組逾時、B 組回應,不能剔除 A 組再比速度。已知費用、未知費用、契約通過與完整度待複核各有位置;修復後重跑另建一輪,保留首輪結果才看得出改善。
六列是抽樣計畫而非已執行結果。先前草案留下的 612.4、1540.2 毫秒暫不列為成績,因目前無同次模型回應。這六列 A/B 實測將與 Day 18 承諾的首輪路由成績,在明天的 Day 21 Trace 觀測與服務驗證中一併執行,今天的空格不會在明天突然變成未經證實的成績。[4]
圖 1 整理品質門檻、觀測範疇與成本架構;在取得六列實測前,正文僅以算式示範邏輯。真實抽樣數據待正式 API 驗證輪次產出,不借用假秒數拼裝成績。
本篇同時準備 DEMO.md 草案:第一段查一筆蔬食資料,第二段示範同單查回,第三段讓待詢問需求進入收件匣。時間軸是演出配置,尚未量測的地方不寫成恰好三分鐘完成。
先前規劃的展示草案提到「少走樓梯」記憶、無障礙標籤與「預約導覽」按鈕,這些沒有對應的本次程式證據。我先改用既有飲食偏好、資料缺漏提醒與「留下服務詢問」,把替換原因留在展示稿註記。現場不必製造正式服務故障;重啟查回可用已驗收錄影,通知接手則等真實端點完成再演。
下一篇是 Day 21|一條 Trace 找到問題:從模型工具呼叫一路追到後端結果 。我會先核對工具要求、執行、資料與呈現是否屬於同一回合,再判斷缺口。今天還沒有取得的實測,不會在明天突然變成證據。
本篇新增 cost_ledger.py、test_cost_ledger.py、pricing.checked.json,另有保留原題號的選題核對。外部牌價查核與舊版草案數值分開存放,公開基準題集保持不動。
[1] Gemini:思考設定與介面說明。
[2] Gemini Developer API:官方價格,本次另查於 2026-10-03。
[3] Gemini API:配額與限流。
[4] Day 18:二十題地方契約與分層成績。
[5] LINE:Webhook 錯誤原因與統計。
[6] LINE:接收 Webhook 與重新傳送。


 iThome鐵人賽
 看影片追技術