
Day19 的結論很尷尬:Pi 把 telemetry 的契約、詞彙、型別、測試都寫好了,但沒有任何一行程式在發 span,而要承載它們的 AgentHarness 二十個操作全是空殼。
所以今天的目標拆成兩半:
好消息是第二件事有現成的材料:--mode json 的事件串流。
Day19 列了六條規則。把它們翻成程式,核心只有三十幾行:
function start(parentContext, parentId, options, callback) {
  const span = tracer.startSpan(options.name, { attributes: definedOnly(options.attributes) }, parentContext);
  const wrapper = makeSpan(span, trace.setSpan(parentContext, span), record);

  let result;
  try {
    result = callback(wrapper);              // 規則 1:同步呼叫,剛好一次
  } catch (thrown) {
    settle(record, span, thrown, true);
    return Promise.reject(thrown);           // 規則 2:同步丟出 → 轉成 rejected promise
  }

  if (result && typeof result.then === "function") {
    return result.then(                      // 規則 3:promise settle 之前 span 一直開著
      (value) => { settle(record, span, undefined, false); return value; },
      (thrown) => { settle(record, span, thrown, true); throw thrown; },
    );
  }

  settle(record, span, undefined, false);
  return result;
}
settle() 負責規則 4(沒明確設狀態就自動判定 ok/error),而每個記錄方法都包在 try/catch 裡,對應規則 5 和 6。
這就是 Pi 附一致性測試的價值。我把它接上 node 的測試框架跑下去:
node --test conformance.test.mjs
第一次跑:兩項失敗。
第一個 bug:我以為的「被動」不夠被動。 測試會故意傳進一個「讀取屬性就會爆炸」的物件。我的程式長這樣:
setAttributes(attributes) {
  const clean = definedOnly(attributes);   // ← 在 try 外面!讀取就炸了
  try { span.setAttributes(clean); } catch {}
}
例外直接穿過 telemetry、跑進業務邏輯——違反「記錄不能改變被觀測的東西」。而且測試還檢查「失敗的記錄呼叫必須整個被忽略,不能只套用一半」,所以修法不只是包 try,還要先送後端、成功了才更新自己的紀錄。
第二個 bug:span 結束後還能生小孩。 我有擋掉結束後的 setAttributes,卻忘了擋 startSpan。測試預期一個 span,我卻產生了兩個。修法是結束後改走一條「照樣執行 callback、但什麼都不記錄」的惰性路徑。
修完之後:
ℹ tests 10
ℹ pass 10
ℹ fail 0
這兩個 bug 都不是「會噴錯」的那種,而是「平常看不出來、出事時把 agent 一起拖下水」的那種。如果沒有這套測試,我會很有自信地把錯的東西 ship 出去。
順帶一提,這也是 harness 設計的一課:你提供擴充點時,一起附上驗證擴充點的測試,比寫十頁文件有效。
Pi 不發 span,但 --mode json 會把過程全部吐出來:
agent_start → turn_start → message_start → message_update×N → message_end
            → tool_execution_start → tool_execution_end → turn_end → … → agent_end
tool_execution_start 和 tool_execution_end 都帶 toolCallId 和 toolName——這正是 Day18 缺的東西:每個工具各自的開始與結束。
我寫了一個 wrapper:它啟動 Pi、逐行讀事件、在事件抵達的當下打上時間戳,然後用 Day19 那套 pi.* 詞彙開關 span。
這裡有個有趣的卡關:契約是 callback 式的(span 在 callback 結束時關閉),但事件串流是「開始」和「結束」分別在不同時間抵達。解法是把 promise 留在手上:
function openSpan(parent, name, attributes) {
  let release;
  const pending = new Promise((resolve) => { release = resolve; });
  let handle;
  (parent ?? telemetry.context).startSpan({ name, attributes }, (span) => {
    handle = span;      // startSpan 是同步呼叫 callback,所以這裡拿得到
    return pending;     // 回傳一個還沒 settle 的 promise → span 保持開啟
  });
  return { span: handle, close: (attrs) => { handle?.setAttributes(attrs); release(); } };
}
契約說「span 會開著直到 promise settle」,這裡就是直接拿這條規則來用。
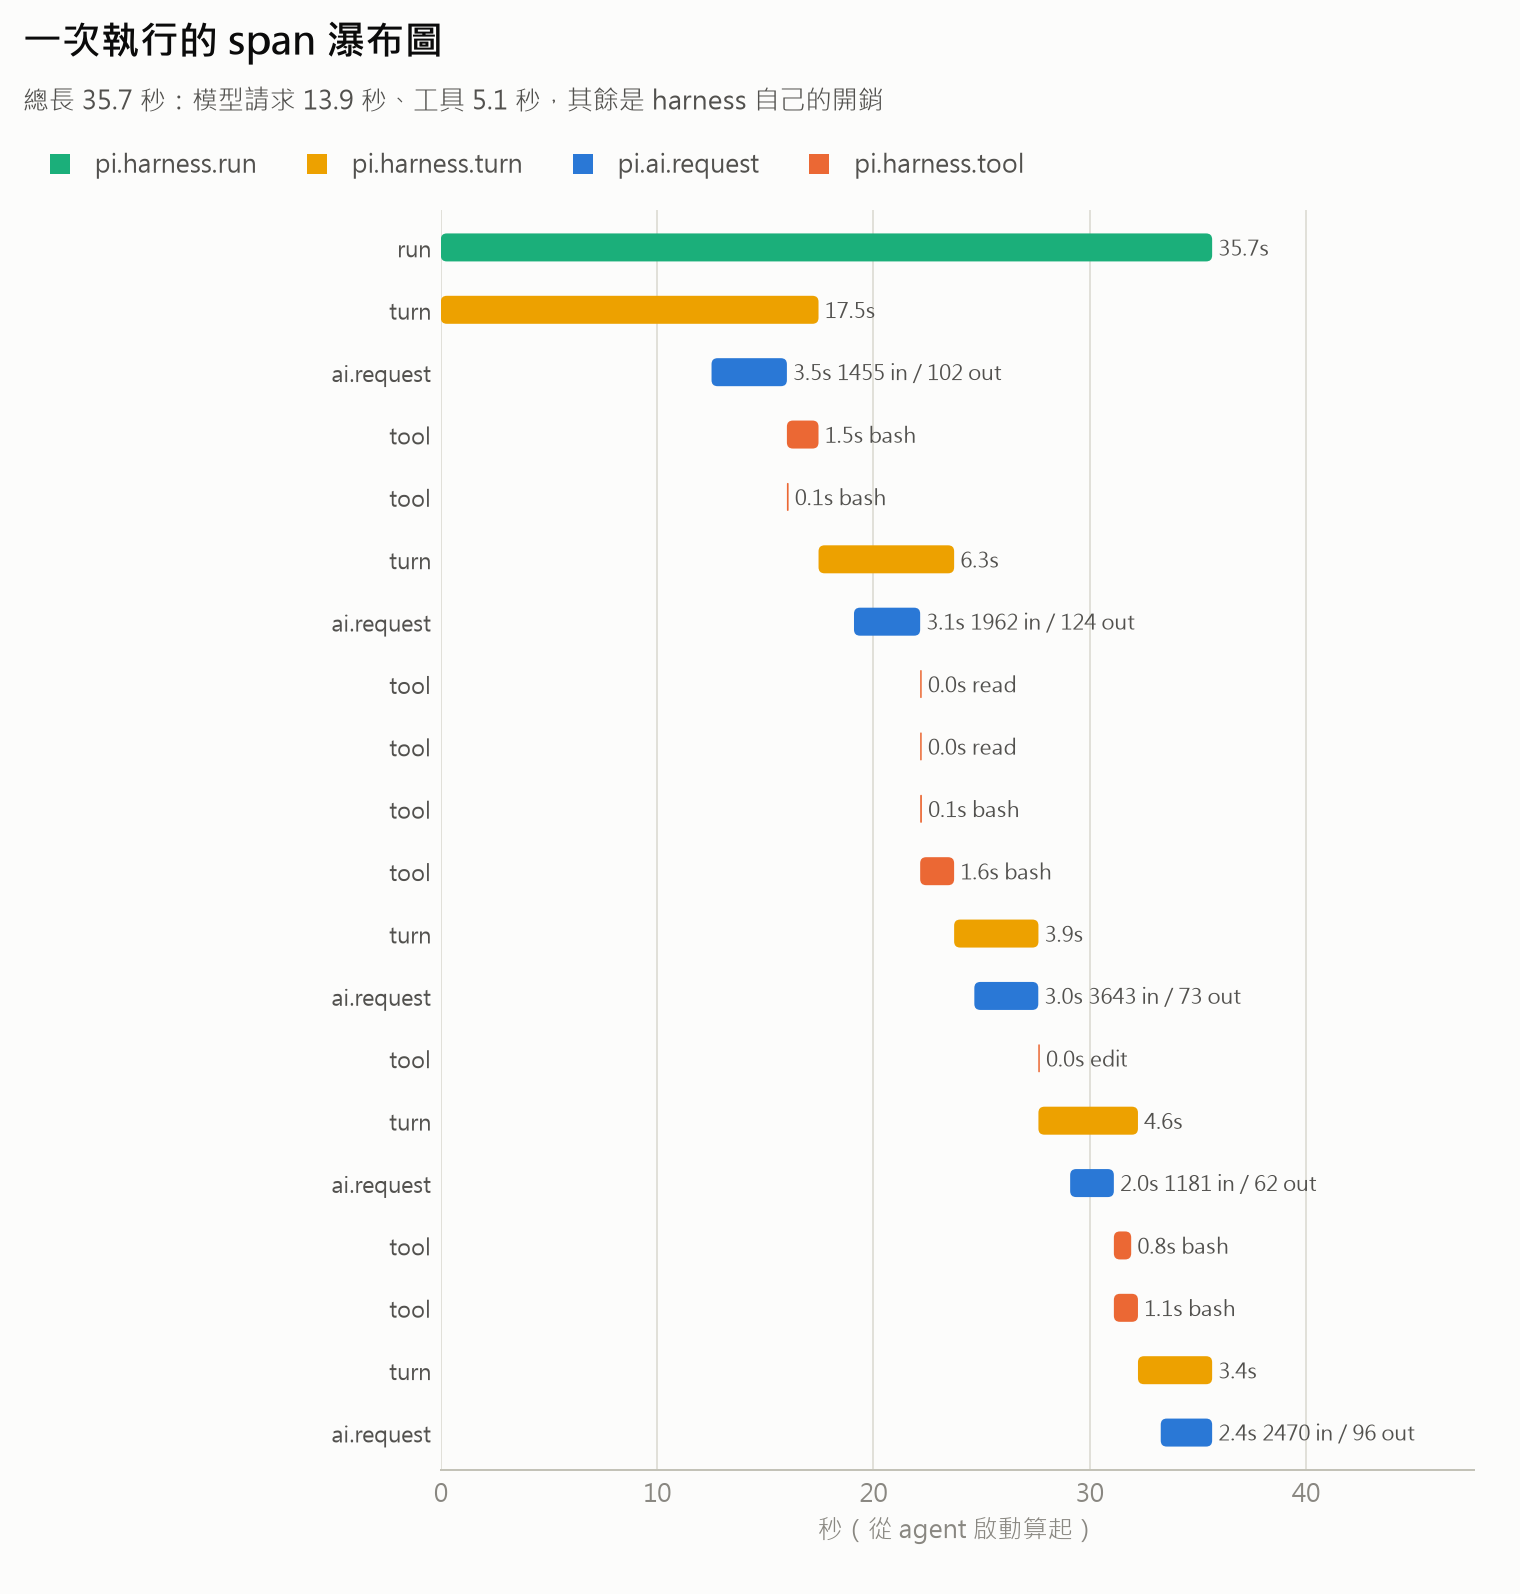
拿一個修 bug 的任務跑一次(gpt-5.6-luna、thinking off),得到 20 條 span:
| 項目 | 時間 | 佔總長 |
|---|---|---|
| 總長(agent_start → agent_end) | 35.7 秒 | 100% |
模型請求(5 次 pi.ai.request) |
13.9 秒 | 39% |
工具(9 次 pi.harness.tool) |
5.1 秒 | 14% |
| 其餘(harness 自己的開銷) | 約 16.7 秒 | 47% |
Day18 我用 session 時間戳推算,得到「97.5% 在等模型,工具只佔 2.3%」。
那個數字是錯的——更精確地說,它把 harness 的開銷全部算進了「等模型」。真相是模型請求只佔 39%。
最誇張的證據在瀑布圖最上面:第一次模型請求發生在第 12.5 秒。 在那之前的 12 秒,agent 一個字都還沒問,全花在啟動:載入設定、掃描 context 檔與 skills、確認模型清單與授權。
這也解釋了 Day18 那個「3.4 秒不知去向」——用 trace 一看,它根本不是 3.4 秒的小數點誤差,而是整整佔了快一半的一塊。
為什麼土炮法會錯? 因為「上一則訊息的時間戳」到「下一則訊息的時間戳」之間,除了模型在想,還塞著 harness 準備 context、寫 session、跑 hook 的時間。session 記錄只在「訊息」這個粒度留痕跡,中間的事它不知道,於是全部被算成等待。
量錯不可怕,可怕的是不知道自己在量什麼。 這也是 Day7 那句「一次成功不算數」的延伸版:一個數字要能信,得先知道它是怎麼來的。
平行工具現在分得開了。 有一輪同時跑了四個工具:
| 工具 | 耗時 |
|---|---|
| read | 12 毫秒 |
| read | 13 毫秒 |
| bash | 80 毫秒 |
| bash | 1,569 毫秒 |
那一批的耗時完全由最後一個 bash(跑測試)決定,其他三個加起來不到它的 7%。在 session 記錄裡,這四個是一團糊在一起的數字。
工具的真實開始時間也有了。 不再需要拿「模型輸出結束」當工具的起點,所以 Day18 那個「1.5 秒是高估」的問題自動消失。
pi.ai.stream.time_to_first_chunk_ms 發出來。--offline,所以啟動時做了模型清單與授權檢查的網路往返。有了 trace,就能看到那些「只在長任務才出現」的行為。Day21 拆 compaction:當對話長到裝不下時,Pi 怎麼決定丟掉哪一段、保留哪一段,以及那個切點規則為什麼不能亂切。


 iThome鐵人賽
 看影片追技術