
你的專案說明(README)有翻譯版嗎?改了英文版,其他語言有跟上嗎?
如果有一個檢查在幫你盯,你知道它實際在比什麼嗎?
usage 是我做的開源小工具,顯示 Claude Code、Codex 等 AI 工具用了多少 token、花了多少錢。它的 README 有英文、繁體中文、簡體中文、日文、韓文五份。
7 月 3 日,usage 加了一個文件同步檢查,每次推上 GitHub 都會跑。那時它只比英文和繁體中文。簡體中文、日文、韓文三份 README,是 7 月 11 日才加進專案的。
8 月 2 日凌晨,寫給 AI 看的專案說明檔 CLAUDE.md 裡記了一條:
README also has `zh-CN`, `ja`, and `ko`, which CI does not enforce — sync them by hand when README changes. `scripts/check_doc_parity.py` only checks English ↔ Traditional Chinese.
意思是:簡中、日文、韓文這三份,CI(每次推上去自動跑的檢查)不管,改 README 時要手動同步;那個檢查只比英文和繁中。
8 月 2 日下午,同步檢查改了,README 的五份都納入比對,比的仍是 ## 開頭的小標有幾個。那次改動(commit)的說明寫著:
五份 README 目前都是 13 個 ## 標題,加上這道檢查 CI 仍然是綠的。
CLAUDE.md 那一條沒有跟著改,還是寫著「CI 不管這三份」「只比英文和繁中」。
8 月 26 日深夜,usage 準備發 v0.30.0,新功能是支援 Grok CLI。英文和繁中的 README 各加了三處:功能清單多一條 Grok、「可以隱藏哪些區塊」的說明多列一個 Grok、比較表多一列 Grok。
簡中、日文、韓文三份,一處都沒加。
我用 git 取出 v0.30.0 那一版的檔案,跑當時的同步檢查:
$ python3 scripts/check_doc_parity.py
PASS: bilingual document parity check passed
通過。同一版的日文 README,「Grok」這個字一次都沒出現;英文版有 3 行提到它。
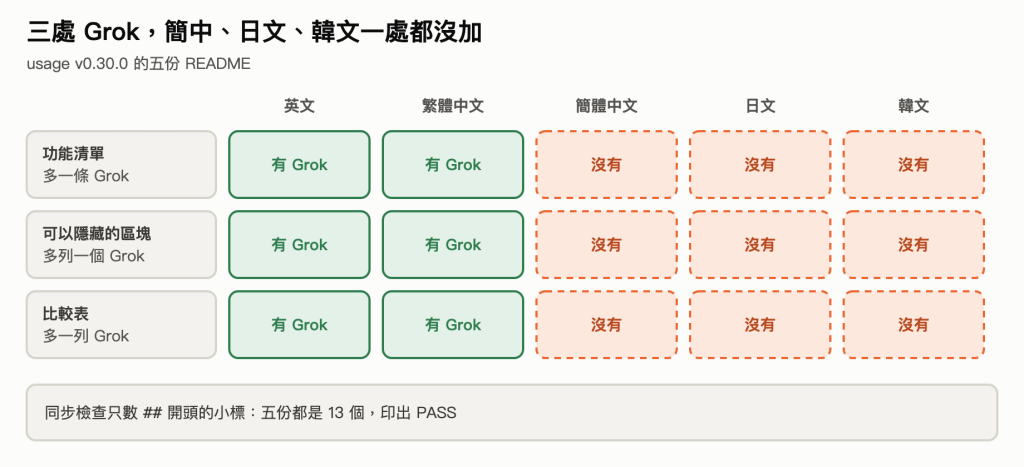
v0.30.0 在 8 月 27 日凌晨發出,接著又發了 v0.30.1,同步檢查一直是綠的。
缺口在發版後不到一天被翻出來。8 月 27 日晚上,一張盤點「Grok 還有哪裡沒接上」的工作單(交給 AI 的任務說明),第三項寫著:
README.ja.md、README.ko.md、README.zh-CN.md沒有跟著更新 Grok(CI 只檢查 en ↔ zh-TW)。
補上三份的那次改動,commit 的說明(掛著 Claude 共同作者)也這樣寫:
The Simplified Chinese, Japanese and Korean READMEs never got Grok … CI only enforces English against Traditional Chinese, so nothing caught it.
這兩句跟 CLAUDE.md 那一條說的是同一件事,可是 8 月 2 日下午之後就過時了。那時 CI 已經把這三份一起比,而且比完是綠的。
檢查為什麼過了?因為它只數一件事:每份 README 裡有幾行是 ## 開頭的小標。五份都是 13 個,就算同步。### 開頭的小小標,它也不數。
少了一條功能說明、少了一列表格,小標的數量不會變。
只數小標,是刻意的選擇。改動說明寫了原因:如果連小標的文字都要比,翻譯就得逐字對齊英文,譯文會不自然。
這個選擇的代價是:少了一個小標抓得到,小標底下少一條抓不到。
同樣的漏法,7 月 24 日也發生過一次。英文和繁中加了「服務狀態警示」(Claude、Codex 服務出問題時跳出的提醒)這條功能和比較表的一列,其他三份到 7 月 27 日才補上,中間發了 6 個版本。那時檢查還沒擴大,就算擴大了,只數小標也抓不到。
我回頭把歷史改動算了一次。這次小標連 ### 一起數,再多算兩樣東西:- 開頭的條列,和 | 開頭的表格列。7 月 11 日有五份 README 以來,改到 README 的改動一共 54 次,每一次都算。
數字對不上的有三件事:7 月 24 日那次(一直到 7 月 27 日補上之前,連續 4 次改動都對不上)、8 月 20 日英文和繁中多了一整個 ### 小節(其他三份 50 分鐘後補上,同一個版本發出),和 8 月 26 日的 Grok。三件都是真的沒跟上,沒有誤報。
現在就可以做一件事:把你的翻譯版故意刪掉一條條列,跑一次你的同步檢查。還是綠的,你就知道它看不到什麼。
要這樣數,可以存一個 check_readme_sync.py:
import re
import sys


def counts(path):
    with open(path, encoding="utf-8") as f:
        lines = f.read().splitlines()
    return {
        "小標": sum(1 for line in lines if re.match(r"^#{2,}\s", line)),
        "條列": sum(1 for line in lines if re.match(r"^\s*[-*]\s", line)),
        "表格列": sum(1 for line in lines if line.startswith("|")),
    }


base, *others = sys.argv[1:]
expected = counts(base)
ok = True
for path in others:
    got = counts(path)
    if got != expected:
        ok = False
        print(f"{path}:{got},{base} 是 {expected}")
sys.exit(0 if ok else 1)
第一個檔是原文,後面接各個翻譯版:
python3 check_readme_sync.py README.md README.zh-TW.md README.zh-CN.md README.ja.md README.ko.md
拿 usage 的 v0.30.0 跑,它印出:
README.zh-CN.md:{'小標': 23, '條列': 29, '表格列': 25},README.md 是 {'小標': 23, '條列': 30, '表格列': 26}
README.ja.md:{'小標': 23, '條列': 29, '表格列': 25},README.md 是 {'小標': 23, '條列': 30, '表格列': 26}
README.ko.md:{'小標': 23, '條列': 29, '表格列': 25},README.md 是 {'小標': 23, '條列': 30, '表格列': 26}
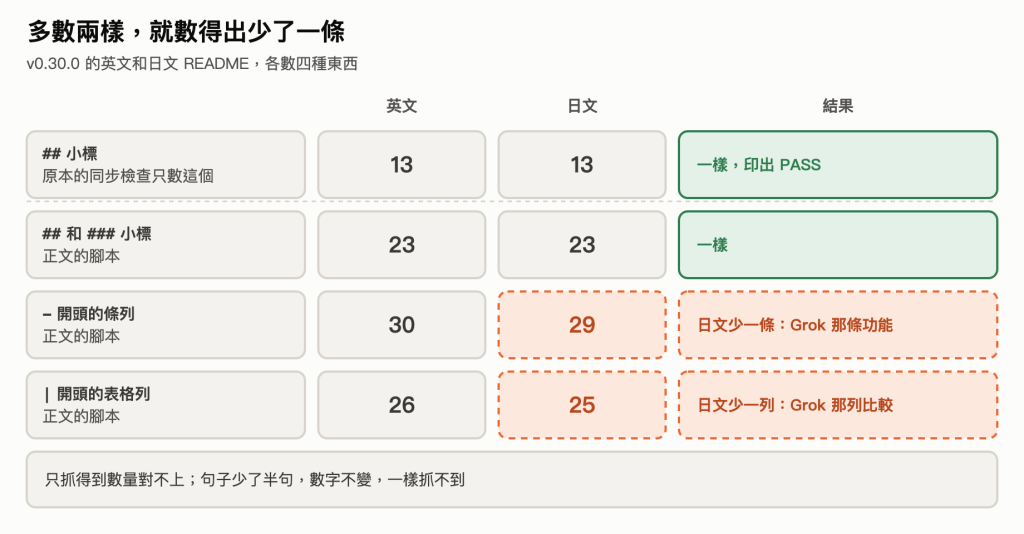
它一樣抓不到「句子少了半句」。數數字的檢查,只能抓到這三樣的數量對不上;翻譯版刻意少寫一條的專案,也會被它報錯。
還有一件事:改了檢查的範圍,就去搜寫給 AI 看的說明檔(CLAUDE.md、AGENTS.md 這類),把描述這個檢查的那幾句一起改掉。
工作單(交給 AI 的任務說明)裡有一格「做完怎麼算對」,Day 4、Day 8 到 Day 19 各在這格加了幾行。今天再加兩行:
做完怎麼算對:
- (Day 4、Day 8 到 Day 19 加的幾行)
- 改了有翻譯版的文件:每個語言版本都要改到,AI 回報要列出每一版改了哪幾行;同步檢查通過不算數
- 改了檢查的範圍:同一個改動裡,把說明檔裡描述這個檢查的句子一起改
今天的同步檢查,是有在看,只數一件事。明天看另一種:檢查一直是綠的,是因為跑檢查的電腦剛好用 UTC 時區(世界標準時間)。9 月 18 日,usage 的一個 PR(合併請求)寫著:報表有 6 個測試,換到台灣時間(UTC+8)的 Windows,每次都失敗。


 iThome鐵人賽
 看影片追技術