Hello, 各位 iT 邦幫忙 的粉絲們大家好~~~
這系列文源自這幾年在團隊裡導入 AI Coding 之後,一路踩雷、修正、再踩雷的真實過程。把這些收斂出來的方法整理成文,也許對正在煩惱同樣問題的你會有些幫助。
就當作是一份邊做邊記的工程筆記吧!
本篇是 當 AI 加入團隊:打造可審查、可驗證、會自我改善的 AI 開發工作流 系列文的 EP22。
延續上一篇的整理,我們也發現有幾組 skill 其實在做「方向相反、但邏輯幾乎一樣」的事情。
例如「把資料從裝置拉下來」跟「把資料推回裝置」,過去被寫成兩份幾乎重複的文件,只有 90% 相似、10% 不同。
我們的做法是:如果相似的能力只是方向或模式不同,就用輸入參數表達差異,合併成同一顆 skill;只有平台真正不同的地方,才值得分開維護。
# skill: device-data-sync

## Inputs
- direction: pull | push
- target: 裝置連線資訊

## Behavior
- direction = pull:從裝置取回資料到本機
- direction = push:把本機資料送回裝置
- 連線、驗證、錯誤處理邏輯共用同一套
但反過來,我們也刻意保留了真正不同平台之間的分界——例如某一類裝置用 Linux 式的 SSH 連線與互動流程,另一類裝置則是 Windows 式的帳密登入與互動密碼輸入,這兩者的連線模型、權限模型完全不同,硬要合併成表面統一的一份文件,反而會讓兩邊的細節互相污染,最後兩邊都寫得不清不楚。
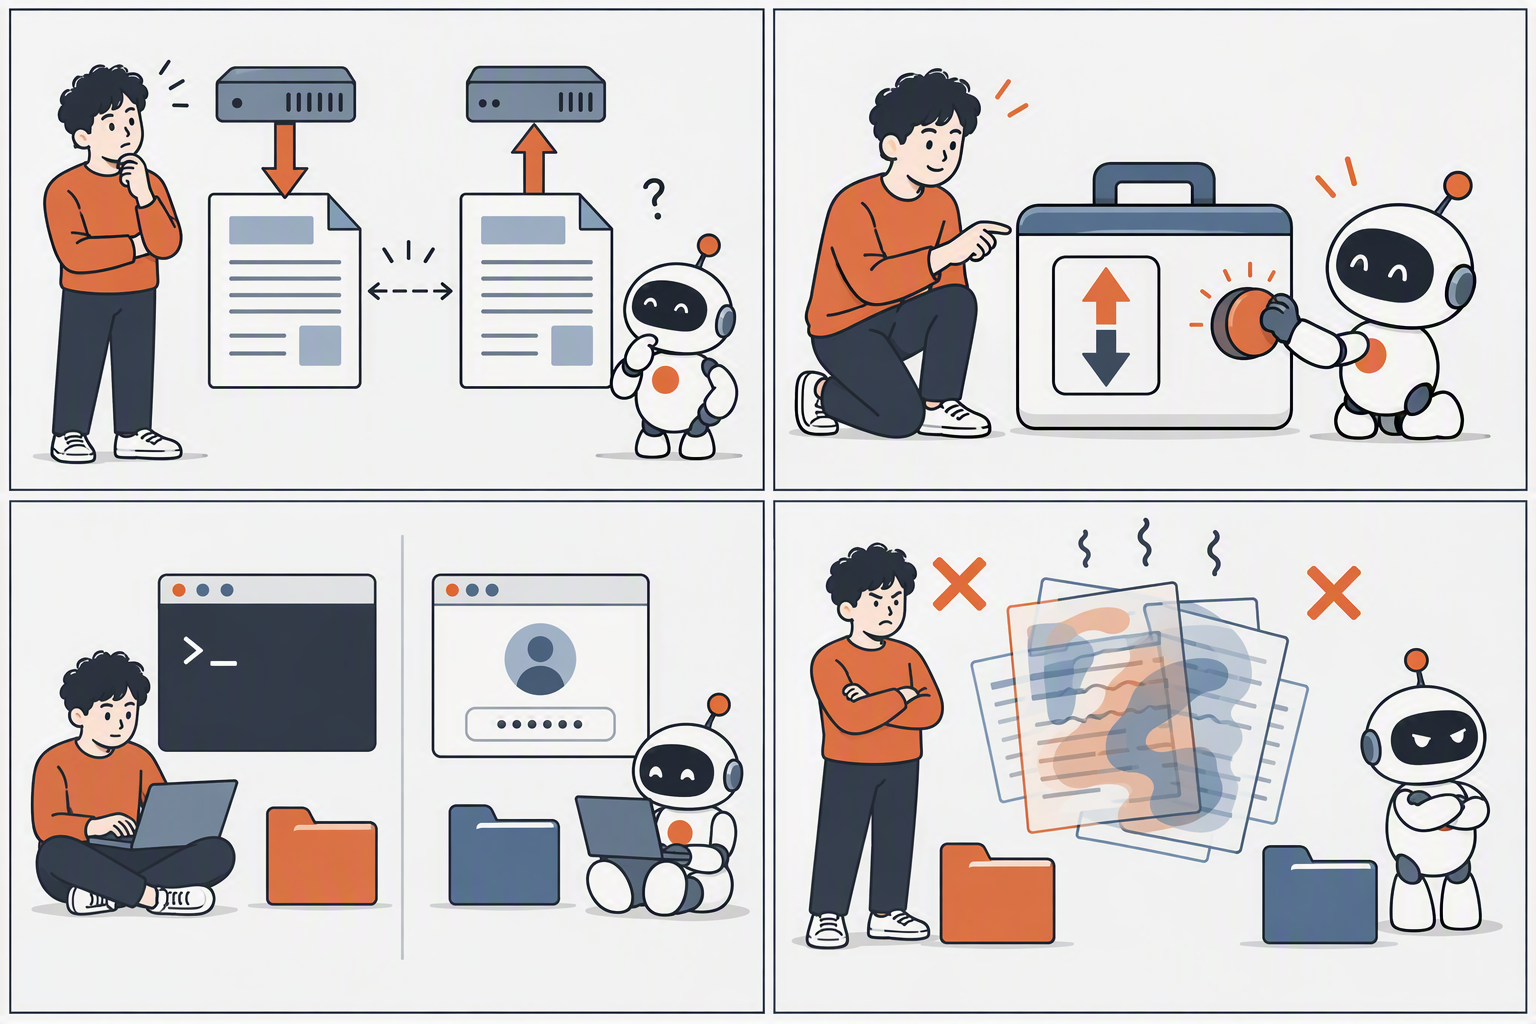
分辨這兩者,靠的不是感覺,而是回頭去看:如果把兩份文件疊在一起讀,讀者會不會被岔開的細節搞混?如果會,那就該分開。
這加起來其實就一句話:相似度高、只是參數不同該合併;概念看似相同但底層機制不一樣該分開。
技能的合併與分界處理好之後,我們接著把注意力放回現場裝置本身:部署流程要怎麼把真實裝置的限制寫進去,才不會「方便測試」卻不小心弄壞了正式環境?
下一篇來談。

 iThome鐵人賽
 看影片追技術
看更多