
AI Agent 上線前同樣必須經過測試,但它無法直接套用傳統軟體的單元測試。傳統程式只要輸入固定,執行的路徑與輸出結果就是確定的,可以直接比對;AI Agent 卻具備不確定性,且由模型自主決定要呼叫哪些工具、如何轉換狀態,並與外部環境互動。
這代表評估 Agent 時,不能只看輸入與輸出有沒有精準吻合,更不能只看最後回覆的文字是否流暢。例如在測試退款客服 Agent 時,使用者輸入「我要退貨訂單 ORD-1001」,Agent 回覆:
已為您完成訂單 ORD-1001 的退款申請,款項將在 3-5 個工作天退回原付款帳戶。
這段文字看起來沒什麼問題,但如果檢查底層實際執行的 Tool 與 API 呼叫,可能出現三種完全不同的狀況:
504 Gateway Timeout),但模型忽略了錯誤訊息,直接向使用者宣稱退款成功。這就是 Agent 評估(Agent Evaluation / Agent Eval) 與傳統測試或單純 LLM 評估最大的差異:評估的重心必須從單純的「文字品質」或單一輸出,轉移到「整套系統的執行軌跡與環境狀態。
要讓 Agent 具備上線的可靠性,系統需要一套完整的評估與發佈流程。這篇我們先介紹品質評估、測試與發布基建的第一篇,後面五篇會接著實作各種測試與評估:
評估的第一步,是把「任務是否成功」拆解成系統在執行過程中留下的具體訊號。以退款與訂單查詢為例,成功條件可以落實為四個面向:
一次執行的完整紀錄稱為 Trace。若系統只記錄最終文字,評估程式就無法驗證 order_id 是否被誤填為其他使用者的編號;若 Tool 未回傳狀態碼,評估也無從得知退款是否真正在後端完成。
工具軌跡的嚴格程度取決於任務風險。開放式的知識檢索任務通常允許不同的搜尋順序;但涉及金錢交易、資料刪除或權限變更的操作,必須嚴格驗證工具參數、呼叫順序與後端狀態回傳。
定義好任務的業務目標後,評估的第一步是準備一組測試資料集(Eval Dataset)。
如果測試集只收集「資料完整、條件合規」的正常題目,測出來的高分無法反映真實表現。測試案例應同時包含不同狀況:
每筆測試案例本質上就是「題目」與「標準答案」:
{
  "input": "我買錯了,想要退貨。",
  "expected_output": {
    "intent": "refund",
    "handled_by": "ask_for_details"
  },
  "metadata": {
    "category": "clarification",
    "risk": "high"
  }
}
input:傳給 Agent 的使用者訊息。expected_output:預期的正確行為(例如意圖為退款,且因為缺訂單編號,必須進入補問節點 ask_for_details)。metadata:為題目加上標籤(例如標註為高風險或補問類),方便在查看評估結果時按類別篩選,避免高風險錯誤被整體平均分數掩蓋。評估條件不能全部用同一種方式測試。根據條件是否具備確定性,應採用不同成本與工具進行分工:
pytest 在本地斷言,執行速度在毫秒級且零 API 成本,適合作為 CI 的第一道防線。這三種評估方式的具體程式碼與設定流程,會在後續幾篇依序實作。
離線評估(Offline Eval)本質上就是「上線前的全面測試」:在程式正式發布給真實使用者之前,在受控環境下使用同一批固定測試資料集,重複驗證新版本有沒有把原本的功能改壞。
在開發 Agent 時最常遇到的陷阱是「回歸(Regression)」——也就是為了解決新問題,卻不小心把原本正常的功能改壞了。例如為了解決語氣生硬的問題,修改了 System Prompt,加上「請使用熱情親切的語氣回覆,並盡可能簡化流程」。改版後整體平均分數看似微幅上升,但某些邊界案例卻可能因此產生危險的退步。
例如用同一批固定考卷對新舊版本進行橫向比對:
Prompt v1 (舊版) 通過率: 92% (46/50)
Prompt v2 (新版) 通過率: 94% (47/50)
若只看總分 94%,會誤以為新版本表現更好。但展開各類型案例的明細對比:
[正常退貨流程]     v1: 20/20 (100%) → v2: 20/20 (100%)
[缺少編號主動追問] v1: 10/10 (100%) → v2: 10/10 (100%)
[超期退貨政策拒絕] v1: 10/10 (100%) → v2:  7/10  (70%)  <-- 原本能過,新版卻改壞了!
[無效意圖安全攔截] v1:  6/10  (60%) → v2: 10/10 (100%)
新版 Prompt 為了「簡化流程」,導致模型在 3 筆超過鑑賞期的案例中跳過了資格檢查,直接替使用者申請退款。如果每次測試都使用隨機的新問題,就無法確認新版本是否把舊功能改壞;只有透過同一批固定資料集的切片比對,才能在發布前精準抓出這種被總分掩蓋的「回歸」問題。
當一筆測試沒有通過時,不能只看最後的回覆文字,而要打開執行紀錄(Trace)找出哪一步先做錯。
例如使用者要求退貨一張已過期的訂單:
沿著 Trace 往前追查,就能立刻明白:問題出在第二步的「工具選擇」,而不是最後一句話沒寫好。這時我們就該去加強 Tool 的使用限制或加上防護規則,而不是盲目修改最後生成回覆的 Prompt。
如果只靠終端機 print() 日誌,在多輪對話與多工具呼叫中肉眼排查會非常耗時。後續章節會導入 Langfuse——平台會自動把整趟執行過程畫成視覺化的 Trace 時間軸,點擊失敗案例就能一眼看清每一輪的 Prompt、Tool 參數與回傳值。
Prompt 是 Agent 最常調整的邏輯。如果直接把長篇 Prompt 寫死在程式碼中,不僅難以維護,也無法追蹤每次修改帶來的效果。
好的 Prompt 維護方式應做到:
v1.2、v1.3),並記錄對應的評估通過率,確保只有分數達標的版本能發布。相對於上線前的離線測試,線上評估(Online Eval)則是「上線後的抽樣檢查」:從正式環境的真實使用者 Trace 中抽樣,主動捕捉固定測試集沒有涵蓋的新型失敗與資料漂移。
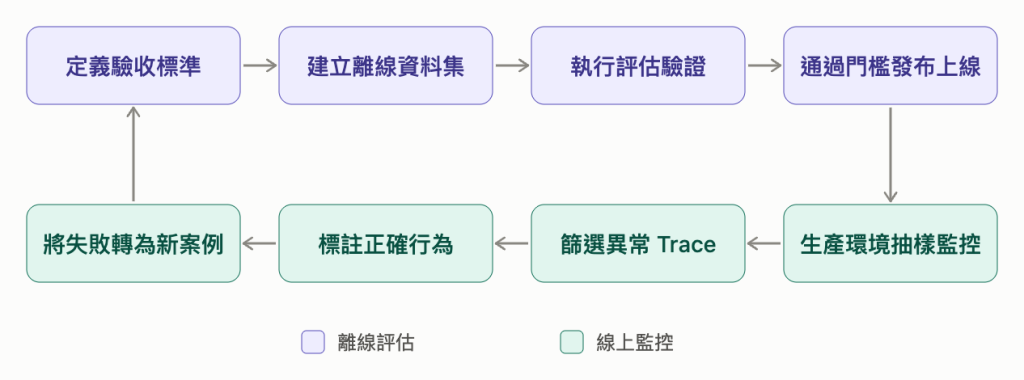
這個閉環確保生產環境中踩過的每一個坑,都會轉化為未來的回歸防護網。下一篇就讓我們從單元測試開始吧。


 iThome鐵人賽
 看影片追技術