
前幾篇用 RAG 與 GraphRAG,讓模型從非結構化文件裡檢索退貨規定、跨文件關聯這類語意資訊。但客服系統經常也要碰觸另一種資料——像訂單狀態這種存在關聯式資料庫裡、欄位固定的紀錄。當 AI Agent 需要存取這類資料庫時,最直覺的做法是把資料庫 Schema 提供給模型,讓模型根據使用者的自然語言提問自由生成 SQL 查詢(Text-to-SQL)。然而在線上環境中,讓模型自由撰寫 SQL 會面臨嚴重的穩定性與安全性問題:
以常見的電商客服為例,當使用者詢問:
幫我查已退款的訂單有哪些?
若直接讓模型自由撰寫 SQL,系統就必須承受上述的所有隨機風險。要解決這個問題,我們不讓模型直接碰 SQL,而是採用結構化查詢契約架構(QuerySpec):在這個架構下,我們將「語意理解」與「SQL 執行」徹底拆開:模型只負責將自然語言抽取成受限的 Pydantic 欄位參數,而真正的 SQL 組裝、參數化綁定與資料庫查詢,完全由確定性的程式端掌控。
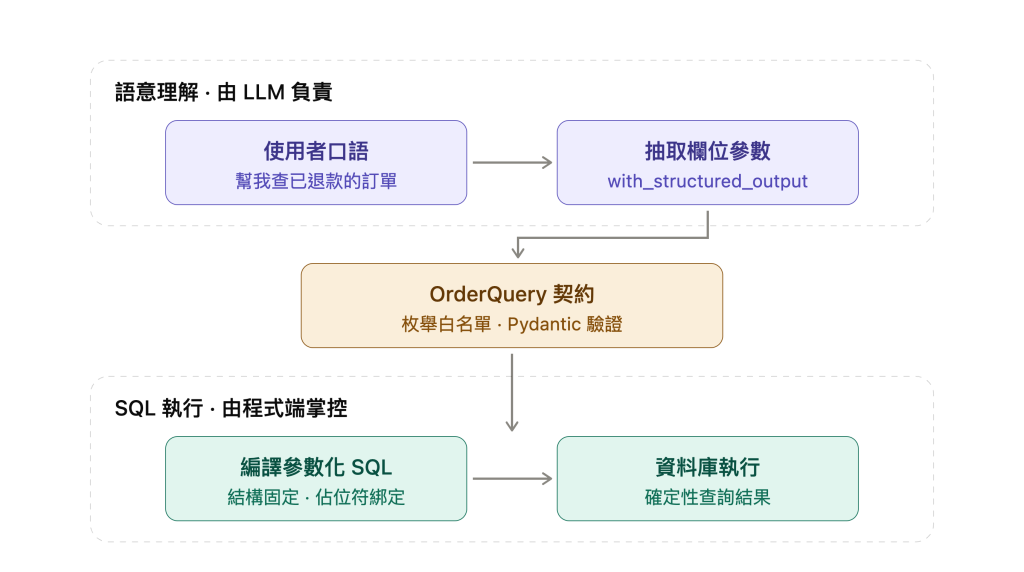
對應的範例程式位於 ai-agent-sample/langgraph/langgraph-queryspec-order。
為了防止模型自行發明查詢條件或選錯欄位,我們在程式端主動劃定查詢邊界——只開放業務允許查詢的維度,並將合法值嚴格鎖定在白名單內。
在我們的範例中,假設系統目前只開放使用者依照「訂單狀態」進行查詢。我們的目的是讓模型只能在已知合法的狀態中挑選,完全禁止自由發揮。因此,我們先用 StrEnum 列出資料庫中合法的狀態值,再透過 Pydantic 定義這份受限的查詢契約 OrderQuery 作為規範:
from enum import StrEnum
from pydantic import BaseModel


class OrderStatus(StrEnum):
    PENDING = "待處理"
    PROCESSING = "檢驗中"
    REFUNDED = "已退款"


class OrderQuery(BaseModel):
    status: OrderStatus | None = None
這份契約在型別層級建立了強制防線:status 欄位只能接收預先定義的枚舉值(「待處理」、「檢驗中」、「已退款」)或 None(代表不限狀態)。若模型嘗試填入不存在的狀態(例如「處理中」或「已取消」),Pydantic 在第一時間就會阻擋下來,杜絕了無效狀態滲透到後續流程。
在 LangChain 中,可以直接使用 Chat Model 內建的 with_structured_output 方法。它會自動將 Pydantic 模型轉為 Tool Calling 定義,並在模型回覆後將結果反序列化為已驗證的物件:
from langchain_anthropic import ChatAnthropic

model = ChatAnthropic(model="claude-haiku-4-5")
structured_llm = model.with_structured_output(OrderQuery)

query = structured_llm.invoke("幫我查已退款的訂單有哪些?")
# 得到:OrderQuery(status=OrderStatus.REFUNDED)
模型只負責把「已退款」對應到合法枚舉 OrderStatus.REFUNDED,不碰任何 SQL 語句。
拿到模型抽取的 OrderQuery 後,後續的 SQL 組裝完全由程式端接手。
查詢編譯器負責將這份受限的契約轉換為參數化 SQL:
from typing import Any


def compile_order_query(query: OrderQuery) -> tuple[str, list[Any]]:
    conditions: list[str] = []
    sql_params: list[Any] = []

    if query.status is not None:
        conditions.append("status = ?")
        sql_params.append(query.status.value)

    where_clause = f"WHERE {' AND '.join(conditions)} " if conditions else ""
    sql = f"SELECT id, product_name, amount, status FROM orders {where_clause}ORDER BY id DESC"
    return sql, sql_params
不同的使用者提問,經過契約抽取與編譯器處理後,產生的 SQL 與參數對應如下:
OrderQuery(status=OrderStatus.REFUNDED)
SELECT id, product_name, amount, status FROM orders WHERE status = ? ORDER BY id DESC
["已退款"]
OrderQuery(status=None)
SELECT id, product_name, amount, status FROM orders ORDER BY id DESC
[]
OrderStatus 的枚舉白名單,在 Pydantic 層級就會被直接拒絕。即使模型被誘導抽取為「已退款」,帶入 SQL 時也只會作為 ? 佔位符的純字串參數,絕不會被當作 SQL 語法解析執行。這段編譯邏輯確保了兩項防護:
? 佔位符傳入資料庫,欄位值不會被當作 SQL 語法解析。結構化查詢契約的另一個優勢是讓多輪對話的條件維護變得單純。
當使用者在對話中追加或調整條件時:
使用者:幫我查所有的訂單。
查詢參數:OrderQuery(status=None)

使用者:只要已退款的。
查詢參數:OrderQuery(status="已退款")
因為查詢狀態是明確的 Python 物件,程式只需將新收到的欄位覆寫到既有物件上(例如更新 query.status = OrderStatus.REFUNDED),再重新執行 compile_order_query 即可。程式不需要依賴模型從頭閱讀整段對話歷史來重新編寫整句 SQL,避免了對話輪數增加時條件被遺漏或串錯的問題。
結構化查詢契約架構的核心是將權限與職責徹底切開:
這套流程跟前面 RAG、GraphRAG 處理的是不同的資料型態,但分工邏輯一致:RAG 讓模型對向量化的文件做語意檢索,QuerySpec 讓模型對關聯式資料庫做欄位抽取,兩者都只讓模型負責語意理解這一步。模型只出現在「自然語言轉 OrderQuery」這一步,之後的 SQL 組裝、參數化綁定、資料庫查詢,全部交給程式碼按固定順序執行。模型看不到查詢結果,也不需要決定下一步要不要再查、要不要換一張表查。控制流程從頭到尾寫在程式碼裡,模型負責的只是流程中一段受限的語意解析——這就是 workflow 的做法:LLM 是流程裡固定的一個環節,而不是自己在迴圈裡決定要做什麼、什麼時候停下來的 agent。


 iThome鐵人賽
 看影片追技術