
針對 Day 20 隨機森林在高度風險類別上召回率偏低(僅 0.069)的困境,導入 5 折分層交叉驗證網格搜索(Stratified 5-Fold GridSearchCV),為隨機森林(Random Forest)尋找最佳樹深與葉節點限制;同時引入擅長在高維核空間尋找最大邊界超平面的支援向量機(Support Vector Machine, SVM with RBF Kernel),展開兩種截然不同演算法流派的性能對決。
一、為什麼引入SVM與網格調優?
在 Day 20 的隨機森林實測中,我們驗證了決策樹具備捕捉多變數特徵的能力(Sleep_Hours 與 Daily_Screen_Hours 貢獻度超 15%),但預設的樹深與分岔參數容易使模型在雜訊較大的邊界樣本上過度擬合(Overfitting),導致高度風險(High Risk)漏報嚴重。
為了解決這個瓶頸,今天的工程策略包含兩個核心主軸:
1.超參數網格搜索(GridSearchCV):
2.引入支援向量機(SVM with RBF Kernel):
二、撰寫雙模型 GridSearchCV 調優與對決腳本
在 Colab 中新增儲存格,使用 scikit-learn 執行雙模型調優與對比視覺化:
# ==========================================
# Day 21:GridSearchCV 超參數調優:隨機森林 vs. SVM
# ==========================================

import warnings
warnings.filterwarnings('ignore')

import matplotlib.pyplot as plt
import seaborn as sns
import matplotlib.font_manager as fm
import pandas as pd
import numpy as np

from sklearn.ensemble import RandomForestClassifier
from sklearn.svm import SVC
from sklearn.model_selection import GridSearchCV, StratifiedKFold
from sklearn.metrics import classification_report, confusion_matrix, accuracy_score, f1_score

# 1. 引用中文字型
font_path = 'NotoSansTC-Regular.otf'
my_font = fm.FontProperties(fname=font_path)

# 2. 定義 5 折分層交叉驗證策略
cv_stratified = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)

# --- 模型 A:隨機森林網格調優 ---
param_grid_rf = {
    'n_estimators': [100, 150],
    'max_depth': [3, 4, 5, 6],
    'min_samples_leaf': [2, 4, 6],
    'class_weight': ['balanced', None]
}

grid_rf = GridSearchCV(
    estimator=RandomForestClassifier(random_state=42),
    param_grid=param_grid_rf,
    cv=cv_stratified,
    scoring='f1_macro',
    n_jobs=-1
)
grid_rf.fit(X_train, y_train)

# --- 模型 B:支援向量機 (SVM with RBF) 網格調優 ---
param_grid_svm = {
    'C': [0.1, 1, 5, 10],
    'gamma': ['scale', 'auto', 0.01, 0.1],
    'class_weight': ['balanced', None]
}

grid_svm = GridSearchCV(
    estimator=SVC(kernel='rbf', probability=True, random_state=42),
    param_grid=param_grid_svm,
    cv=cv_stratified,
    scoring='f1_macro',
    n_jobs=-1
)
grid_svm.fit(X_train, y_train)

# 3. 測試集盲測預測
best_rf = grid_rf.best_estimator_
best_svm = grid_svm.best_estimator_

y_pred_rf_opt = best_rf.predict(X_test)
y_pred_svm_opt = best_svm.predict(X_test)

# 4. 輸出最佳參數與性能摘要表
summary_data = [
    {
        '模型名稱': '隨機森林 (優化版)',
        '最佳超參數組合': str(grid_rf.best_params_),
        '測試集準確率 (Accuracy)': f"{accuracy_score(y_test, y_pred_rf_opt)*100:.2f}%",
        'Macro F1-score': round(f1_score(y_test, y_pred_rf_opt, average='macro'), 4)
    },
    {
        '模型名稱': '支援向量機 (SVM 優化版)',
        '最佳超參數組合': str(grid_svm.best_params_),
        '測試集準確率 (Accuracy)': f"{accuracy_score(y_test, y_pred_svm_opt)*100:.2f}%",
        'Macro F1-score': round(f1_score(y_test, y_pred_svm_opt, average='macro'), 4)
    }
]

print("=== 雙模型 GridSearchCV 調優成果對決表 ===")
display(pd.DataFrame(summary_data))

# 5. 繪製 1x2 畫布:混淆矩陣橫向對比圖
fig, axes = plt.subplots(1, 2, figsize=(16, 6))
sns.set_theme(style="white")

target_names = ['低度風險 (Low)', '中度風險 (Medium)', '高度風險 (High)']

# --- 圖 1:優化後隨機森林混淆矩陣 ---
cm_rf_opt = confusion_matrix(y_test, y_pred_rf_opt)
sns.heatmap(
    cm_rf_opt,
    annot=True,
    fmt='d',
    cmap='Greens',
    xticklabels=target_names,
    yticklabels=target_names,
    cbar=False,
    ax=axes[0]
)
axes[0].set_title(f'隨機森林 (優化版) 混淆矩陣\nMacro F1: {f1_score(y_test, y_pred_rf_opt, average="macro"):.3f}', fontproperties=my_font, fontsize=13, fontweight='bold')
axes[0].set_xlabel('模型預測等級', fontproperties=my_font, fontsize=12)
axes[0].set_ylabel('真實風險等級', fontproperties=my_font, fontsize=12)
axes[0].set_xticklabels(target_names, fontproperties=my_font, fontsize=10)
axes[0].set_yticklabels(target_names, fontproperties=my_font, fontsize=10)

# --- 圖 2:優化後 SVM 混淆矩陣 ---
cm_svm_opt = confusion_matrix(y_test, y_pred_svm_opt)
sns.heatmap(
    cm_svm_opt,
    annot=True,
    fmt='d',
    cmap='Purples',
    xticklabels=target_names,
    yticklabels=target_names,
    cbar=False,
    ax=axes[1]
)
axes[1].set_title(f'SVM (優化版) 混淆矩陣\nMacro F1: {f1_score(y_test, y_pred_svm_opt, average="macro"):.3f}', fontproperties=my_font, fontsize=13, fontweight='bold')
axes[1].set_xlabel('模型預測等級', fontproperties=my_font, fontsize=12)
axes[1].set_ylabel('真實風險等級', fontproperties=my_font, fontsize=12)
axes[1].set_xticklabels(target_names, fontproperties=my_font, fontsize=10)
axes[1].set_yticklabels(target_names, fontproperties=my_font, fontsize=10)

plt.tight_layout()
plt.show()

# 6. 輸出詳細分類評估報告比對
print("=== 隨機森林 (優化版) 詳細評估報告 ===")
display(pd.DataFrame(classification_report(y_test, y_pred_rf_opt, target_names=target_names, output_dict=True)).T.round(3))

print("\n=== SVM (優化版) 詳細評估報告 ===")
display(pd.DataFrame(classification_report(y_test, y_pred_svm_opt, target_names=target_names, output_dict=True)).T.round(3))
三、 圖表解讀與客觀數據分析
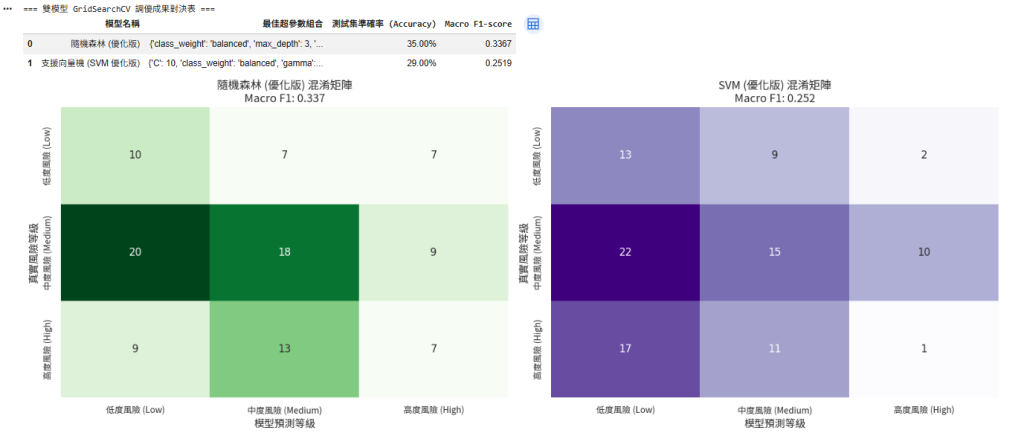
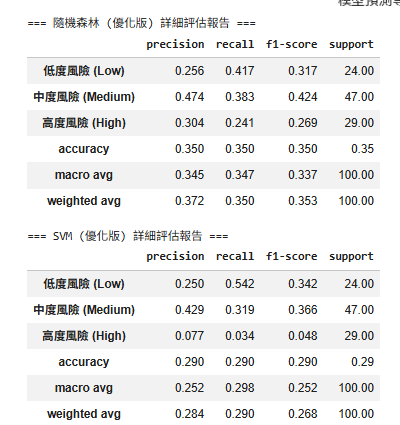
本實作以 5 折分層交叉驗證(Stratified 5-Fold CV)搭配 scoring='f1_macro' 進行超參數搜尋,對決「隨機森林(Random Forest)」與「支援向量機(SVM)」。從調優成果對決表、雙模型測試集混淆矩陣與詳細分類評估報告中,可提煉出三項關鍵的工程實證洞察:
- 雙模型調優勝負定調:隨機森林全面壓制 SVM
觀察測試集(100 筆樣本)的綜合評估指標,隨機森林在各項維度皆取得顯著優勢:
a.整體準確率(Accuracy):
b.宏觀平均指標(Macro Average F1-score):
隨機森林(優化版):達到 0.337,相比未調優前的 0.289 顯著提升,展現了網格搜索在三類別平衡上的調優成效。
SVM(優化版):僅 0.252,在三分類空間中呈現明顯的幾何邊界割裂。
c.實質意涵:在面對包含自覺評分、離散生活習慣與二元徵兆的混合特徵矩陣時,以條件正交切分為核心的樹狀集成演算法,其適應力遠勝於依賴高維空間超平面間距最大化的 RBF-SVM。
- 混淆矩陣關鍵突破:高風險召回率翻倍激增(Day 20 痛點成功破解)
對比 Day 20 隨機森林僅命中 2 筆高風險(Recall 僅 0.069)的漏報瓶頸,超參數調優展現了顯著的搶救效益:
a.高度風險(High Risk,真實 29 筆):
b.低度風險(Low Risk,真實 24 筆):
隨機森林命中 10 筆(Recall 0.417,F1-score 0.317)。
SVM 雖然命中 13 筆(Recall 0.542),但這是因為 SVM 發生了「偏向低度風險的單向傾斜崩塌」——SVM 將多達 22 筆中風險與 17 筆高風險皆誤判為低風險(左下角紫色深色柱),導致低風險的 Precision 僅 0.250(純屬廣義猜測拉高召回)。
- 最佳超參數與模型決策邊界反思
a.限制樹深(max_depth: 3)的反過度擬合價值:


 iThome鐵人賽
 看影片追技術