
成功訓練多類別邏輯回歸模型,完成測試集推論評估,並將模型係數轉化為特徵權重條形圖以利可解釋性分析。
一、實作前情境:為什麼選擇多元邏輯回歸作為 Baseline?
在機器學習實務中,無論後續打算使用多複雜的模型(如 Random Forest、XGBoost 或神經網路),第一步永遠應該建立一個具備強解釋性且結構單純的基準模型:
1.多類別分類本質:
2.高透明度與可解釋性:
二、撰寫模型訓練、評估與係數可視化腳本
在 Colab 中新增儲存格,使用 scikit-learn 的 LogisticRegression 進行模型配適,並以 classification_report 與視覺化熱力圖呈現評估成果:
# ==========================================
# Day 19:多元邏輯回歸基準模型與特徵權重解析
# ==========================================

import warnings
warnings.filterwarnings('ignore')

import matplotlib.pyplot as plt
import seaborn as sns
import matplotlib.font_manager as fm
import pandas as pd
import numpy as np
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, confusion_matrix, accuracy_score

# 1. 引用中文字型
font_path = 'NotoSansTC-Regular.otf'
my_font = fm.FontProperties(fname=font_path)

# 2. 建立並訓練多元邏輯回歸模型
# multi_class='multinomial', solver='lbfgs' 為多元 Softmax 標準設定
clf = LogisticRegression(
    multi_class='multinomial',
    solver='lbfgs',
    max_iter=1000,
    random_state=42
)
clf.fit(X_train, y_train)

# 3. 測試集預測
y_pred = clf.predict(X_test)
y_prob = clf.predict_proba(X_test)

acc = accuracy_score(y_test, y_pred)
print(f"=== 多元邏輯回歸測試集整體準確率 (Accuracy): {acc * 100:.2f}% ===\n")

# 4. 分類報告 (Precision, Recall, F1-score)
target_names = ['低度風險 (Low)', '中度風險 (Medium)', '高度風險 (High)']
report_dict = classification_report(y_test, y_pred, target_names=target_names, output_dict=True)
report_df = pd.DataFrame(report_dict).transpose()
print("=== 分類性能評估報告 (Classification Report) ===")
display(report_df.round(3))

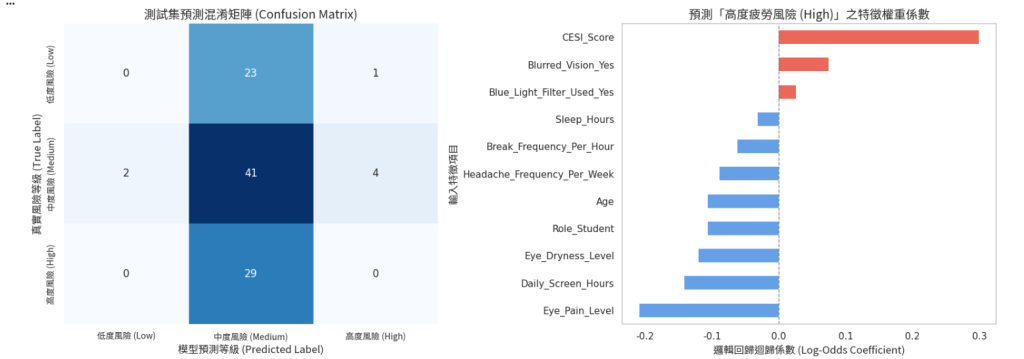
# 5. 繪製 1x2 畫布:混淆矩陣熱力圖 + 高風險特徵係數長條圖
fig, axes = plt.subplots(1, 2, figsize=(16, 6))
sns.set_theme(style="white")

# --- 圖 1:混淆矩陣熱力圖 (Confusion Matrix) ---
cm = confusion_matrix(y_test, y_pred)
sns.heatmap(
    cm,
    annot=True,
    fmt='d',
    cmap='Blues',
    xticklabels=target_names,
    yticklabels=target_names,
    cbar=False,
    ax=axes[0]
)
axes[0].set_title('測試集預測混淆矩陣 (Confusion Matrix)', fontproperties=my_font, fontsize=14, fontweight='bold')
axes[0].set_xlabel('模型預測等級 (Predicted Label)', fontproperties=my_font, fontsize=12)
axes[0].set_ylabel('真實風險等級 (True Label)', fontproperties=my_font, fontsize=12)
axes[0].set_xticklabels(target_names, fontproperties=my_font, fontsize=10)
axes[0].set_yticklabels(target_names, fontproperties=my_font, fontsize=10)

# --- 圖 2:推動判定為「高度風險 (High Risk)」的特徵權重係數 ---
# clf.coef_[2] 對應類別 2 (High Risk) 的線性權重
coef_high = pd.Series(clf.coef_[2], index=X_train.columns).sort_values()

# 顏色區分正負影響:正向推升使用紅橘色,負向保護使用青藍色
colors = ['#4a90e2' if val < 0 else '#e74c3c' for val in coef_high.values]

coef_high.plot(kind='barh', ax=axes[1], color=colors, edgecolor='none', alpha=0.85)
axes[1].axvline(0, color='gray', linestyle='--', linewidth=1)
axes[1].set_title('預測「高度疲勞風險 (High)」之特徵權重係數', fontproperties=my_font, fontsize=14, fontweight='bold')
axes[1].set_xlabel('邏輯回歸迴歸係數 (Log-Odds Coefficient)', fontproperties=my_font, fontsize=12)
axes[1].set_ylabel('輸入特徵項目', fontproperties=my_font, fontsize=12)

plt.tight_layout()
plt.show()

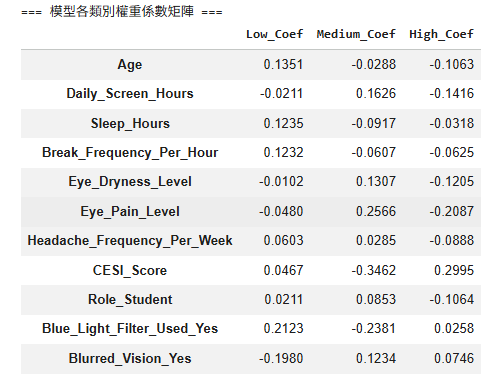
# 6. 輸出各類別係數總表
coef_df = pd.DataFrame(clf.coef_, columns=X_train.columns, index=['Low_Coef', 'Medium_Coef', 'High_Coef']).T
print("=== 模型各類別權重係數矩陣 ===")
display(coef_df.round(4))
三、圖表解讀與客觀數據分析
本實作以多元邏輯回歸作為預測用眼疲勞風險的 Baseline 模型,從測試集混淆矩陣、特徵迴歸係數長條圖及係數矩陣中,揭示了線性模型在複雜生理資料上的極限與關鍵洞察:
b.反向係數的反思(Multicollinearity & Suppression Effect):


 iThome鐵人賽
 看影片追技術