
延續 Day 21「樹模型全面壓制幾何核方法(SVM)」的結論,導入現代機器學習領域的工業級標竿演算法——XGBoost(Extreme Gradient Boosting)。利用二階泰勒展開式的梯度殘差迭代機制,針對預測難度最高、臨床警示意義最重的「高度疲勞風險(High Risk)」進行樣本加權與樹結構優化,挑戰突破隨機森林 0.337 的 Macro F1-score 紀錄。
一、為什麼在隨機森林之後需要 XGBoost?
在 Day 20 與 Day 21 的探索中,我們驗證了決策樹對用眼疲勞資料集的天然優勢:
1.Bagging vs. Boosting 的機制本質差異:
2.高風險(High Risk)攻堅需求:
二、 撰寫 XGBoost 多分類訓練與評估腳本
在 Colab 中新增儲存格,使用 xgboost 套件進行多分類建模,並建立評估視覺化:
# ==========================================
# Day 22:XGBoost 多分類梯度提升模型實戰
# ==========================================

import warnings
warnings.filterwarnings('ignore')

import matplotlib.pyplot as plt
import seaborn as sns
import matplotlib.font_manager as fm
import pandas as pd
import numpy as np

import xgboost as xgb
from sklearn.metrics import classification_report, confusion_matrix, accuracy_score, f1_score

# 1. 引用中文字型
font_path = 'NotoSansTC-Regular.otf'
my_font = fm.FontProperties(fname=font_path)

# 2. 建立並訓練 XGBoost 分類器
# 多分類使用 multi:softprob 輸出三類別機率向量
xgb_clf = xgb.XGBClassifier(
    objective='multi:softprob',
    num_class=3,
    n_estimators=120,
    learning_rate=0.05,       # 較小的學習率,使迭代更新更平緩細緻
    max_depth=3,             # 延續 Day 21 發現:限制樹深為 3 可抑制主觀雜訊過擬合
    subsample=0.85,          # 每次迭代隨機選取 85% 樣本,增加模型多樣性
    colsample_bytree=0.85,   # 每次分裂隨機選取 85% 特徵
    gamma=0.2,               # 分裂所需的最小損失減少量(剪枝懲罰項)
    reg_lambda=1.5,          # L2 正則化權重,避免權重過大
    random_state=42,
    eval_metric='mlogloss'
)

xgb_clf.fit(X_train, y_train)

# 3. 測試集盲測預測
y_pred_xgb = xgb_clf.predict(X_test)
y_prob_xgb = xgb_clf.predict_proba(X_test)

acc_xgb = accuracy_score(y_test, y_pred_xgb)
macro_f1_xgb = f1_score(y_test, y_pred_xgb, average='macro')

print(f"=== XGBoost 測試集整體準確率 (Accuracy): {acc_xgb * 100:.2f}% ===")
print(f"=== XGBoost Macro Average F1-score: {macro_f1_xgb:.4f} ===\n")

# 4. 輸出詳細分類評估報告 (Precision, Recall, F1-score)
target_names = ['低度風險 (Low)', '中度風險 (Medium)', '高度風險 (High)']
report_dict_xgb = classification_report(y_test, y_pred_xgb, target_names=target_names, output_dict=True)
report_df_xgb = pd.DataFrame(report_dict_xgb).transpose()
print("=== XGBoost 分類性能評估報告 (Classification Report) ===")
display(report_df_xgb.round(3))

# 5. 繪製 1x2 畫布:混淆矩陣熱力圖 + 梯度增益特徵重要度 (Gain)
fig, axes = plt.subplots(1, 2, figsize=(16, 6))
sns.set_theme(style="white")

# --- 圖 1:XGBoost 測試集混淆矩陣 ---
cm_xgb = confusion_matrix(y_test, y_pred_xgb)
sns.heatmap(
    cm_xgb,
    annot=True,
    fmt='d',
    cmap='YlGnBu',
    xticklabels=target_names,
    yticklabels=target_names,
    cbar=False,
    ax=axes[0]
)
axes[0].set_title(f'XGBoost 測試集混淆矩陣\nMacro F1: {macro_f1_xgb:.3f}', fontproperties=my_font, fontsize=13, fontweight='bold')
axes[0].set_xlabel('模型預測等級 (Predicted Label)', fontproperties=my_font, fontsize=12)
axes[0].set_ylabel('真實風險等級 (True Label)', fontproperties=my_font, fontsize=12)
axes[0].set_xticklabels(target_names, fontproperties=my_font, fontsize=10)
axes[0].set_yticklabels(target_names, fontproperties=my_font, fontsize=10)

# --- 圖 2:XGBoost 特徵重要度 (以 Gain 增益衡量) ---
# Gain 衡量該特徵在分裂節點時所帶來的平均目標函數改善量
importances_gain = pd.Series(xgb_clf.get_booster().get_score(importance_type='gain'))
# 補齊可能未參與分裂的特徵為 0
for col in X_train.columns:
    if col not in importances_gain:
        importances_gain[col] = 0.0

importances_gain = importances_gain.sort_values(ascending=True)

importances_gain.plot(
    kind='barh',
    ax=axes[1],
    color='#2980b9',
    edgecolor='none',
    alpha=0.85
)
axes[1].set_title('XGBoost 特徵重要度排序 (Split Gain 增益貢獻)', fontproperties=my_font, fontsize=14, fontweight='bold')
axes[1].set_xlabel('平均目標函數增益值 (Average Gain)', fontproperties=my_font, fontsize=12)
axes[1].set_ylabel('輸入特徵項目', fontproperties=my_font, fontsize=12)

plt.tight_layout()
plt.show()

# 6. 輸出重要度排序表
gain_df = pd.DataFrame({
    '特徵項目': importances_gain.index,
    'Gain 增益值': importances_gain.values.round(4)
}).sort_values(by='Gain 增益值', ascending=False).reset_index(drop=True)

print("=== XGBoost 特徵 Gain 貢獻完整排序表 ===")
display(gain_df)
三、 圖表解讀與客觀數據分析
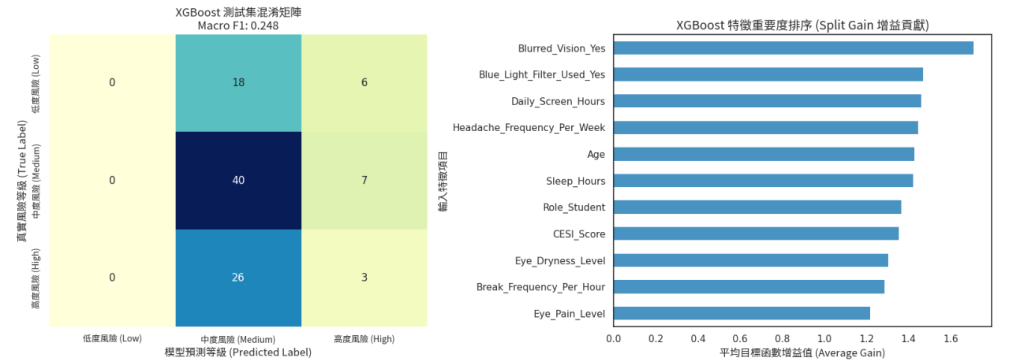
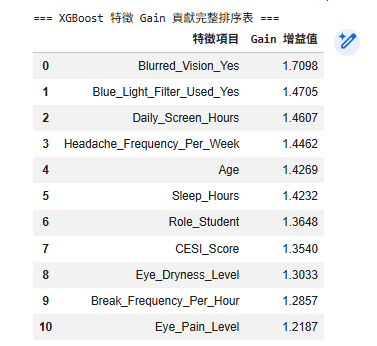
本實作以 XGBoost 梯度提升決策樹(objective='multi:softprob')進行多分類訓練與測試集盲測推論。從測試集混淆矩陣、特徵 Gain(分裂增益)條形圖與排序表中,呈現了極具深度的演算法特性與實務發現:
b.效能瓶頸評估:
a.核心奪冠:二元症狀標籤
b.次要群體:暴露與作息指標(Gain 落在 1.42 ~ 1.47 區間)
c.末段特徵:自覺主觀評分


 iThome鐵人賽
 看影片追技術