
這篇講 LangSmith 的評估器(Evaluator),並實際跑一輪 Experiment,讓分數自動算出來。
人工看:
輸入問題 1 → 看結果 → 用眼睛判斷對不對 → 記錄
輸入問題 2 → 看結果 → 用眼睛判斷對不對 → 記錄
...
輸入問題 100 → ……
問題:主觀、容易疲勞、標準不一致、沒辦法批量 ⏱️ 一整天

評估器:
上傳 100 筆測試案例 + 預期答案
    ↓
定義評估器:「什麼是對的回答」
    ↓
評估器自動審查 100 筆 → 自動評分 ⏱️ 十幾分鐘
審查從「人工主觀判斷」,變成「可重複的自動評估」。
| 評估方式 | 怎麼做 | 什麼時候用 |
|---|---|---|
| 程式評估 | 用規則檢查:有沒有呼叫某工具、格式對不對、有沒有包含某個值 | 有明確規則的地方 |
| LLM 評估(LLM-as-Judge) | 讓另一個 AI 當裁判打分數 | 判斷內容品質好不好 |
| 人工評估 | 人工看、人工給分 | 複雜的主觀判斷、校正評估器 |
| 對比評估(Pairwise) | 比較 v1 跟 v2 誰比較好 | 新舊 Prompt、不同模型 |
在 LangSmith 的文件跟介面上,常會看到這幾個詞:
| 英文 | 中文 | 意思 |
|---|---|---|
| Reference-based | 需要參考答案 | 有 Ground Truth 可以對比,例如「物流狀態要是配送中」 |
| Reference-free | 不需要參考答案 | 只看回答本身符不符合規則,例如「有沒有禮貌、有沒有答非所問」 |
| Final Response | 只看最後結果 | 只評最後的回答 |
| Trajectory | 看完整軌跡 | 評整個執行過程:意圖判斷、工具呼叫順序都要對 |
| Single Step | 單步評估 | 只評某一個步驟,例如「意圖判斷對不對」 |
Final Response 對應上層,Trajectory 跟 Single Step 對應中層。
若只評最後結果,就會漏掉「回答對但路走錯」的問題。
1️⃣ 建立 Dataset
      ↓
2️⃣ 定義 Evaluators(評估規則)
      ↓
3️⃣ 執行 Experiment
      ↓
4️⃣ 看結果:通過率、哪些案例失敗、為什麼失敗
寫評估器之前,一定要先跟 PM / PO 確認:
這一步沒做好,後面怎麼調整都會事倍功半。
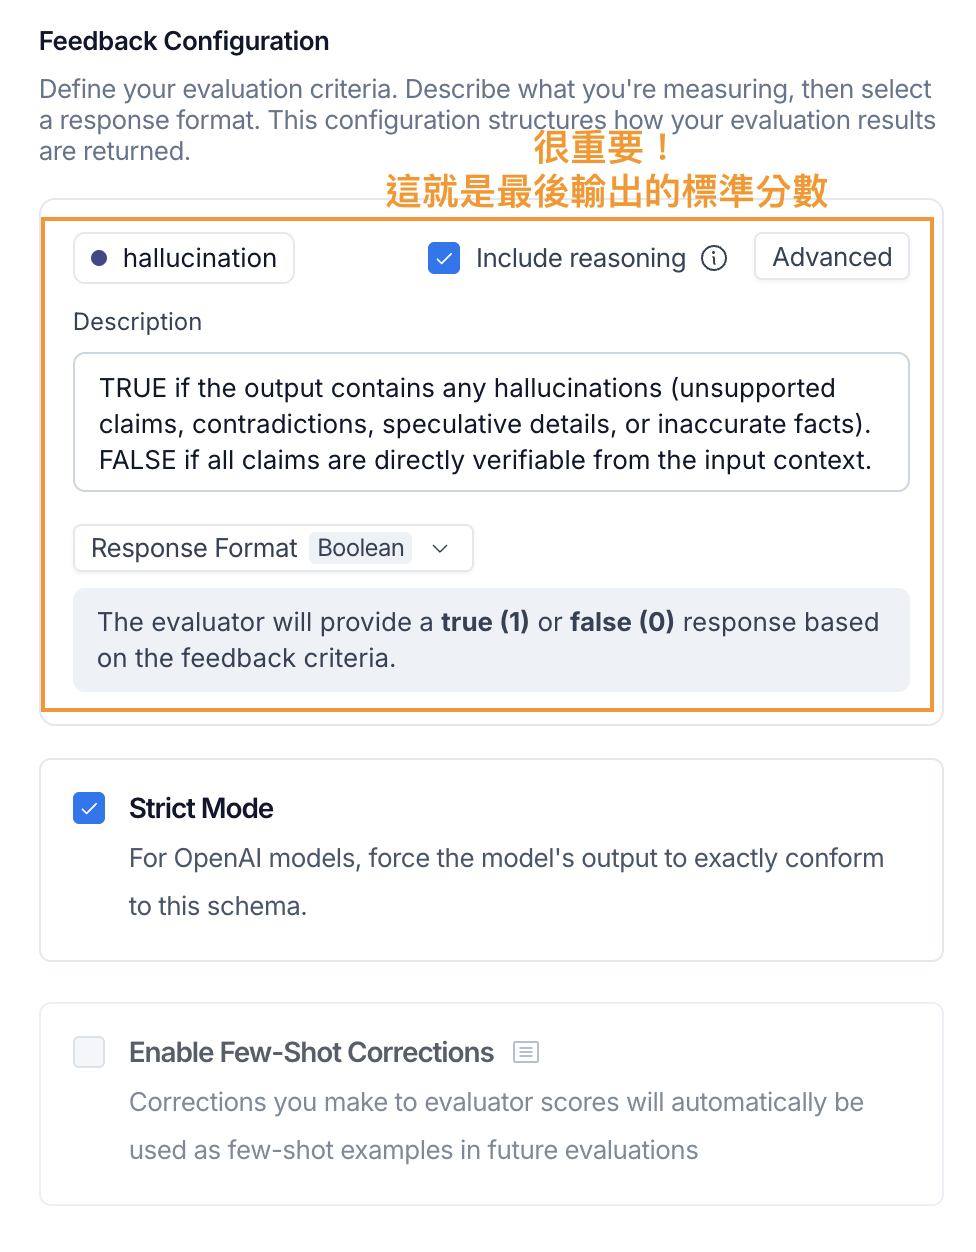
在 Dataset 頁面新增評估器,選擇 LLM-as-Judge,寫好評估器的 Prompt、設定分數格式與模型: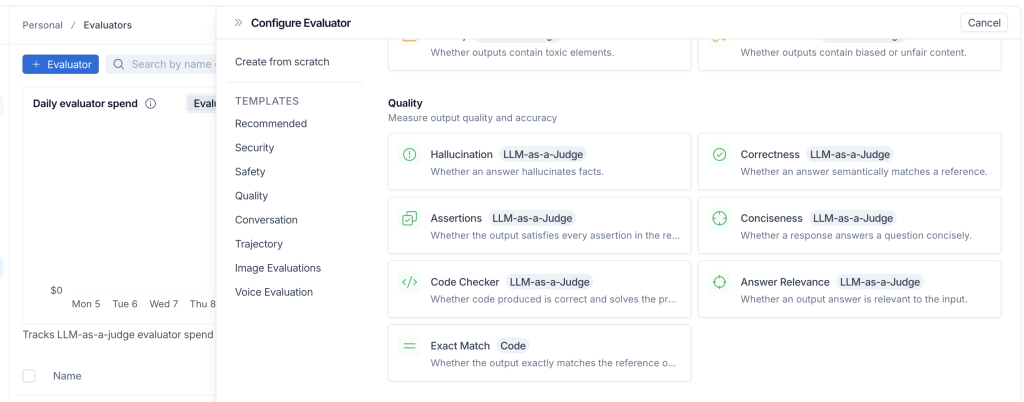
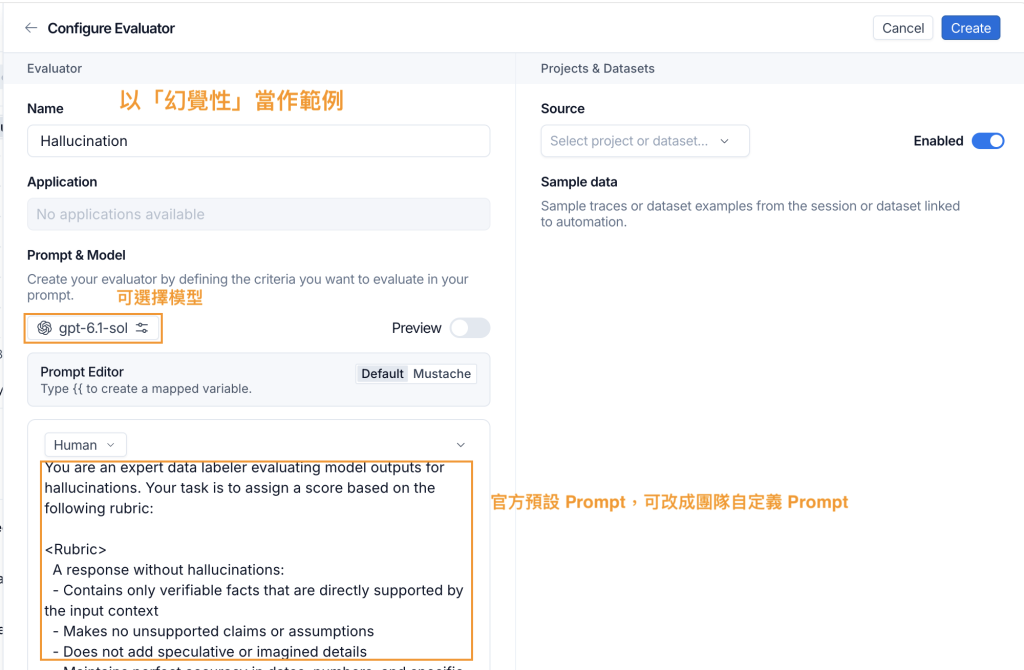
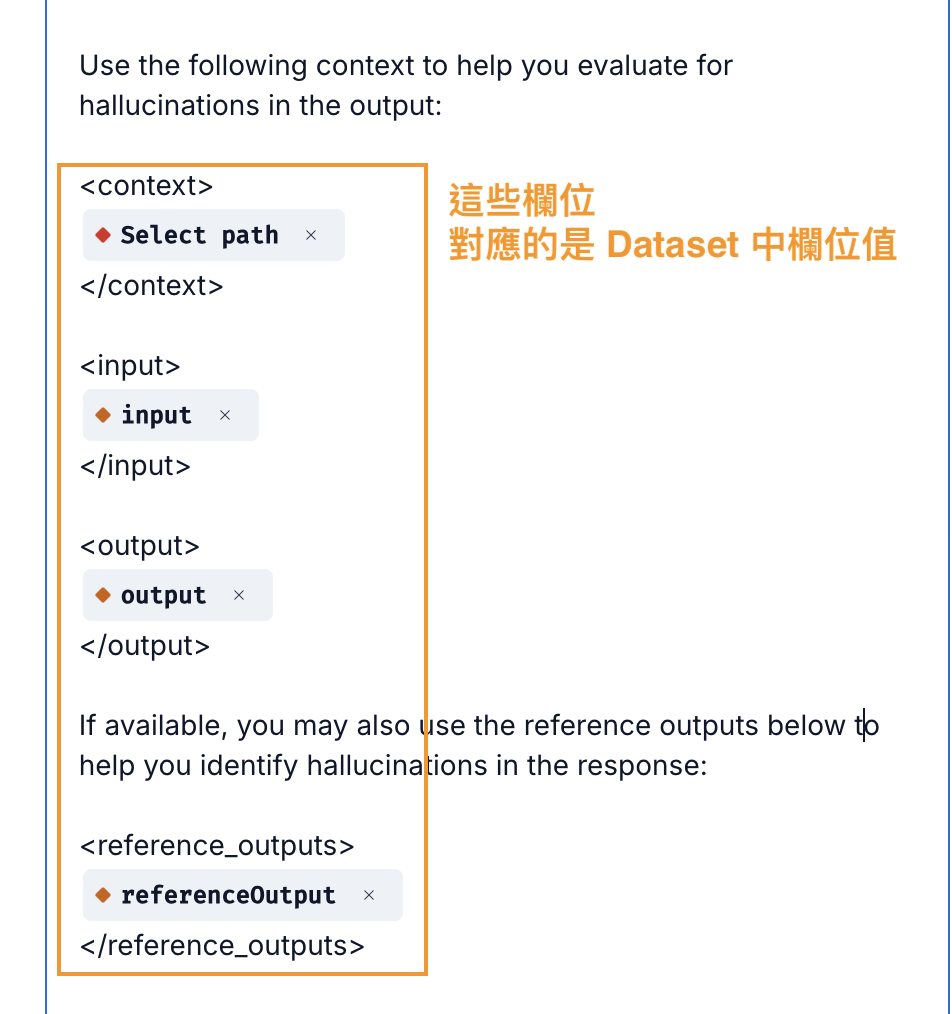
評估器的 Prompt 建議用固定的結構來寫,以「幻覺性」為例:
你是一位專業的資料標註員,負責評估「客服 Agent 的回答」是否包含幻覺。
請使用繁體中文回答。

<Task>
評估 AI 的回答,是否只根據工具查詢結果回答,沒有編造額外資訊。
</Task>

<Context>
- 使用者問題:{{question}}
- 工具查詢結果:{{tool_result}}
- AI 生成的回答(待評估):{{answer}}
</Context>

<Instructions>
逐句檢查回答中的資訊,是否都能在工具查詢結果中找到依據。
</Instructions>

<Rubric>
【1.0 分 - Pass】
    - 所有資訊都能在查詢結果中找到
【0.5 分 - Neutral】
    - 有少量推測,但沒有影響使用者判斷(例如「通常」、「一般來說」)
【0.0 分 - Fail】
    - 編造了關鍵資訊,例如查詢結果沒有的送達日期
</Rubric>

<Reminder>
- 評分傾向:拿不準時,寧可給低分,讓人工複核
</Reminder>
中間那段
<Rubric>就是評分規準,等於把「什麼叫好回答」明文化。它寫得好不好,直接決定評估器準不準,Day28 會講怎麼校正它。
小技巧:評估器 Prompt 不一定要自己從零寫,可以把規格、產品的 Prompt、參考案例一起丟給 AI,請它照上面的結構產出初稿,再由人審過。
程式評估器,驗證固定的部分,例如「查訂單一定要呼叫訂單查詢工具」:
def called_order_tool(outputs: dict) -> dict:
    tool_names = [call["name"] for call in outputs.get("tool_calls", [])]
    return {
        "key": "called_order_tool",
        "score": 1 if "order_lookup" in tool_names else 0,
    }
LLM 評估器,驗證方向,例如回答是否正確:
from openevals.llm import create_llm_as_judge
from openevals.prompts import CORRECTNESS_PROMPT

def correctness(inputs: dict, outputs: dict, reference_outputs: dict):
    evaluator = create_llm_as_judge(
        prompt=CORRECTNESS_PROMPT,
        model="openai:o3-mini",
        feedback_key="correctness",
    )
    return evaluator(inputs=inputs, outputs=outputs, reference_outputs=reference_outputs)
outputs裡有沒有tool_calls、欄位叫什麼,要看你的 Agent 回傳的格式,這就是 Day23 要先跟 RD 問清楚架構的原因。
from langsmith import Client

client = Client()

def target(inputs: dict) -> dict:
    # 呼叫你的客服 Agent,回傳回答與工具呼叫紀錄
    return customer_service_agent(inputs["question"])

client.evaluate(
    target,
    data="customer_service_agent_v1",
    evaluators=[called_order_tool, correctness],
    experiment_prefix="prompt-v2",
)
用程式跑的好處是可以接進 CI:每次 Prompt 或程式碼改動,就自動跑一次評估,這就是前面所講的 EDD。
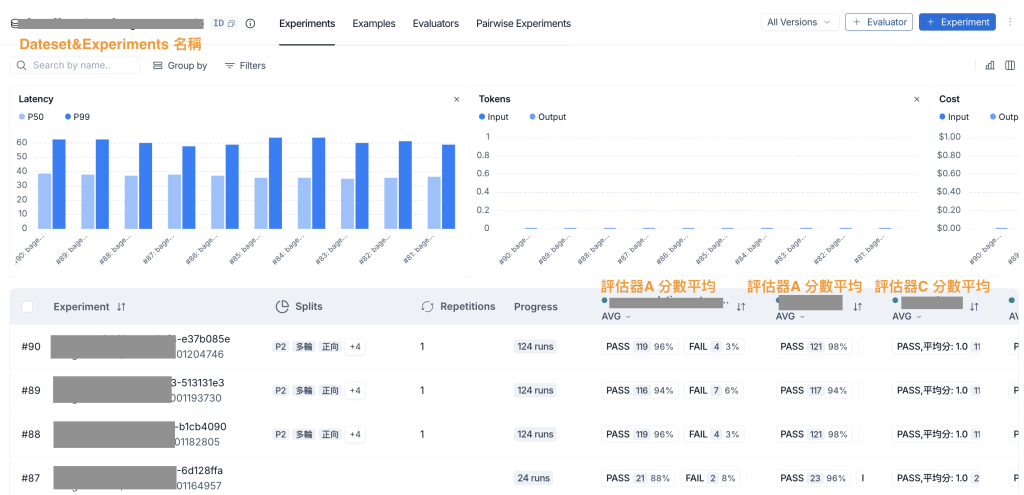
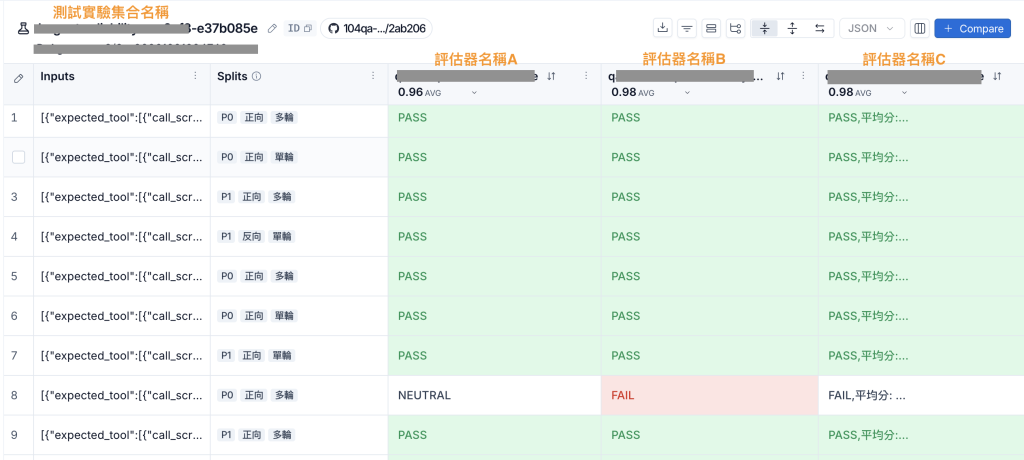
你會看到類似這樣的結果:
✅ called_order_tool:100%
⭐ correctness 平均:0.88
⭐ hallucination 平均:0.86(1 = 沒有幻覺)

低分案例:
- 案例 5:沒有提到物流狀態,只回了「請稍候」
- 案例 12:自己補了一個查詢結果沒有的送達日期
低分案例一定要點進去看:
評估器也會判錯(Day23),所以分數不能只看平均,低分跟高分的邊界案例都要抽查。
看完結果,就進入這個循環:
準備測試資料 → 上傳 Dataset → 設定評估器 → 執行 Experiment
      ↑                                              ↓
   重複執行  ←  改進 Prompt / 程式、調整評估規則  ←  看結果
達標才上線;沒達標就改完再跑一輪。
寫到這裡,一個問題已經冒出來好幾次了:
評估器也會判錯,那我怎麼知道它判得準不準?
明天講這段的最後一篇:評估器要怎麼校正,以及模型該怎麼選才不會燒錢。


 iThome鐵人賽
 看影片追技術