
昨天用 Precision、Recall、F1 量出了評估器準不準。
但量出來「不準」之後,該怎麼修?
這篇講評估器的校正手段、校正時最難的判斷,以及模型怎麼選才不會花了錢、又拿到一堆不可信的分數。
每種校正手段的成本跟風險都不一樣,方向是「先用低風險的,確認沒效再往上升級」:
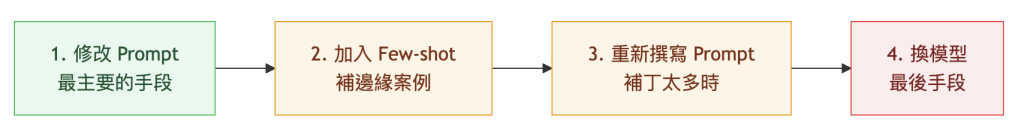
| 手段 | 什麼時候用 | 要注意的 |
|---|---|---|
| 修改 Prompt | 普遍性的判斷偏差、評分邏輯不符規格、邊界條件沒講清楚 | 一次只改一個方向,先用 20~30 筆確認方向對了,再跑更多 |
| 加入 Few-shot | Prompt 已經穩定,大量執行後發現某種特殊案例反覆判錯,而且難以用文字描述 | 只補邊緣案例,不修普遍問題;每一筆都要記錄加的原因 |
| 重新撰寫 Prompt | 反覆修改到結構混亂、前後矛盾,繼續補丁比重寫還貴 | 先整理哪裡有問題、哪裡要保留;重寫後等於重新驗證 |
| 換模型 | 上面都試過還是不行,而且有明確理由相信是模型能力的限制 | 影響最廣、最不透明,見下方「模型怎麼選」 |
實際情況不一定要照固定順序,但第一次建立評估器時,建議照這個順序走一遍。
建好評估器後,先跑 10~20 筆,人工逐一比對評估器的判斷。
「穩定」的定義是:
達到這個狀態之前,只調整 Prompt,不做其他事;
每改一版就重跑、跟上一版比較,並記下「改了什麼、為什麼改、效果如何」。
案例越多,越不可能每筆都看,可以分級抽查:
| 跑了多少筆 | 要人工看哪些 |
|---|---|
| 20 筆以內 | 1、0.5、0 分全部都看 |
| 50 筆左右 | 只看 0.5 跟 0 分 |
| 500 筆以上 | 只看 0 分 |

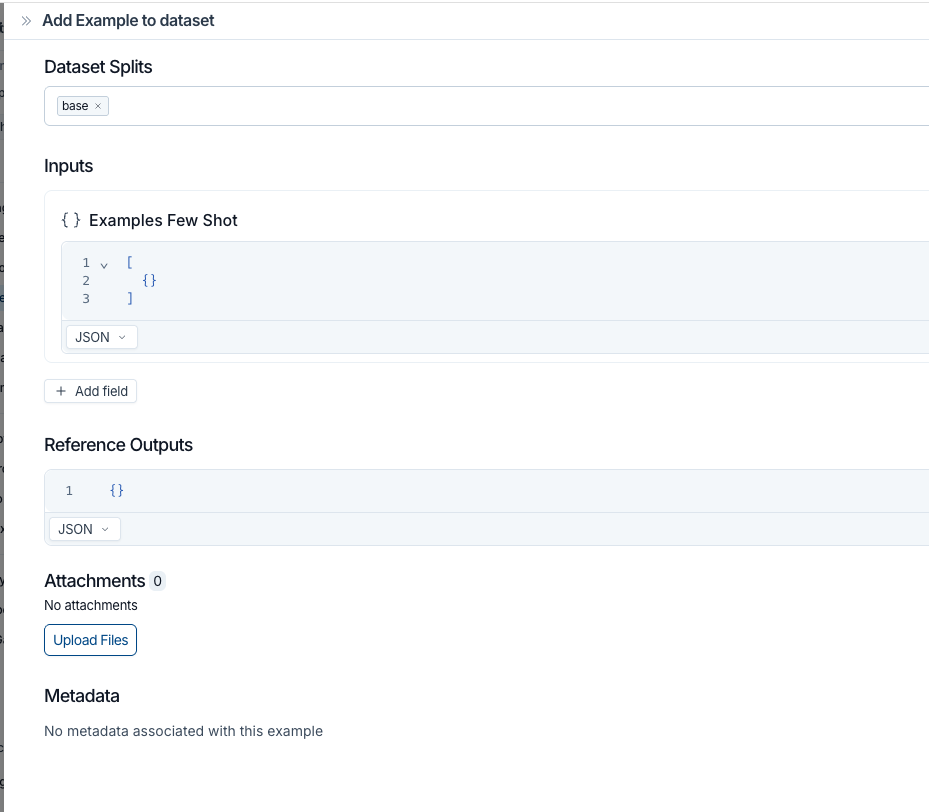
{
  "inputs": {
    "question": "我的訂單 A123 什麼時候會到?",
    "tool_result": "訂單 A123:已出貨,物流狀態:配送中"
  },
  "outputs": {
    "answer": "您的訂單已出貨,目前配送中,一般約 1~2 天內會送達。"
  }
}
{
  "hallucination": 0.5,
  "few_shot_explanation": "查詢結果沒有送達日期,「一般約 1~2 天」屬於推測,但有用「一般」標示不確定性,沒有誤導使用者,給 0.5 而非 0。"
}
評估器校正裡最花時間的,不是改 Prompt 本身,而是搞清楚該改哪一個 Prompt:
| 你看到的狀況 | 可能是 A | 也可能是 B |
|---|---|---|
| 評估器給低分,但 PM 覺得回答可以接受 | 評估器太嚴 → 改評估器 Prompt | PM 的規格還沒想清楚 → 先對齊規格 |
| 評估器給高分,但 QA 人工看覺得有問題 | 評估器漏抓 → 改評估器 Prompt | QA 跟 PM 對規格的理解不同 → 先對齊理解 |
| 回答真的不好 | — | Agent 本身的問題 → 改產品的 Prompt |
遇到這種狀況,最快的方法是直接拉 PM / PO 一起看那筆案例:
「這筆 AI 的回答,你覺得應該給幾分?為什麼?」
備註:這件事也可以請 AI 幫忙:把產品的 Prompt、評估器的 Prompt、測試結果一起丟給 AI,請它先分類「這筆是誰的問題」,甚至可以寫成一支 Skill 重複使用。但最後一定要人工審查。
評估器要選模型,Agent 本身也要選模型。
直覺是「選最強的」,但實務上要同時看三件事:
| 考量 | 選太強的模型 | 選太弱的模型 |
|---|---|---|
| 成本 | 每次評估都很貴,跑不起回歸 | 便宜 |
| 準確度 | 高 | 判錯多,分數不可信 |
| 速度 | 通常比較慢,可能造成逾時 | 快 |
分數下降、或出現新的誤判類型,就應該換回原本的模型,重新評估方向。
選模型本身就是一道 QA 取捨題:品質、成本、可用性,三者要一起看。
AI Agent 測試這一段寫到這裡,面對的其實不只是「學一個新工具」,而是測試思維本質的轉變:
傳統 QA:
規格書 → 測試案例 → 執行 → PASS / FAIL → 上線
                              ↓
                       清晰明確,黑白分明

AI 時代:
品質指標 → 評估器設計 → 自動評估 → 分數評價 → 持續監控
                                  ↓
                     機率性、多面向、需要持續優化
QA 的本質還是「品質守護者」,只是守護的方式變了:
| 傳統應用的守護方式 | AI 應用的守護方式 |
|---|---|
| 按規格驗證功能 | 設計評估指標,定義什麼是「好」 |
| 管理測試覆蓋率 | 品質信心度:95% 通過率夠不夠安心? |
| Bug 排查修復 | 品質診斷:答案為什麼不好?從三層往下查 |
| 上線前一次性檢測 | 持續評估:Code、Prompt、Data、模型一變就要測 |
| 人工審核驗證 | 自動評估工具,大規模批量評估 |
| 上線後偶爾抽查 | 持續監控,及時預警 |
傳統的測試思維不會消失,而是跟 AI 測試思維共存、互補。不是取代,而是升級。
回頭看還會發現一件事:
工具會換、平台會換、模型也會一直換,但 「什麼叫好的回答」這個判斷,從頭到尾都是人定義的。
評估器只是把這個判斷寫成程式,讓它可以重複執行而已。
AI Agent 測試這一段,到這裡告一段落。
明天是最後一篇,終於要來收尾了~


 iThome鐵人賽
 看影片追技術