
這系列測到今天,還沒碰過一個完全不同的領域:用真的瀏覽器去測 UI。今天介紹的 ui-test,來自 Browserbase——做雲端瀏覽器基礎設施的公司,旗下的 browse CLI 可以純本機跑,不需要申請帳號或 API key,browse doctor 回報 managed-local, headless 就代表隨時能用。這個技能定位清楚:不是讀程式碼猜 UI 對不對,是真的開瀏覽器、真的點下去。
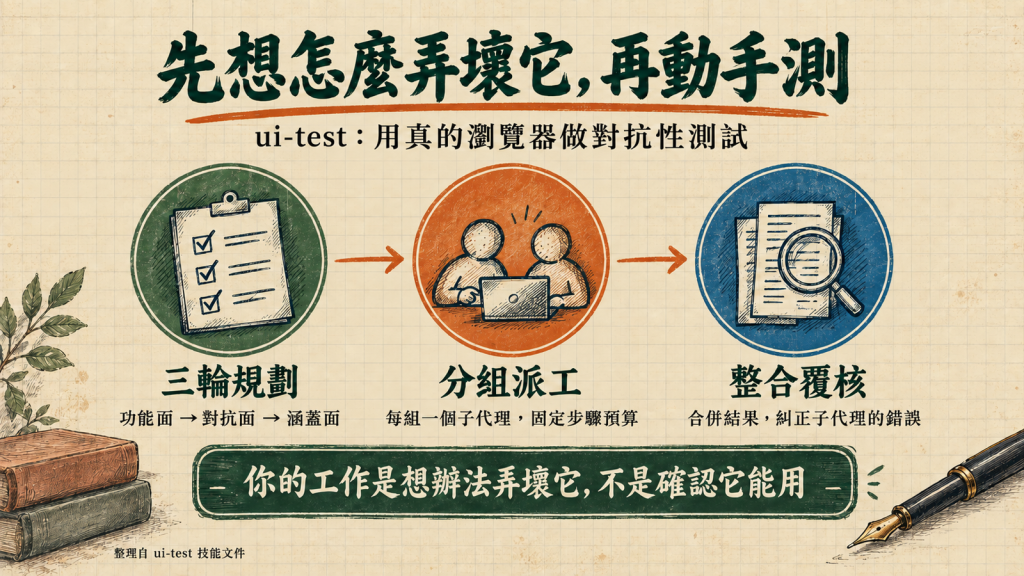
開宗明義一句話定調了整個技能的立場:「你的工作是想辦法弄壞它,不是確認它能用。」具體拆成三條規則:
這套流程背後有個說法我覺得值得記下來:把工作拆給多個子代理,瓶頸在最慢的那一個,所以寧可切成很多個小任務,也不要切成幾個大任務;一個單一元件的小修改,不需要開很多代理、跑很多步驟,一次整頁改版才需要——規模要跟著改動範圍走,不是每次都用同一套重裝備。
要測出「真的有沒有開瀏覽器」這件事,題目要挑一個光看程式碼容易猜錯、但實際點一下立刻現形的 bug。我做了一個訂閱表單頁面:輸入框、一個 Subscribe 按鈕,上面疊了一層裝飾用的漸層背景 .decor。第一版我把 .decor 設成沒有指定 z-index,心裡預期它會蓋住按鈕——結果自己先用 browse 手動驗證,發現瀏覽器實際的疊圖順序跟我以為的不一樣,按鈕好好地被點到了。
這個意外本身就值得記一筆:CSS 堆疊順序的規則,不是我憑直覺猜得準的。沒有指定 z-index 的 .decor(絕對定位)跟沒有定位、但寫了 z-index: 1 的 .content,在瀏覽器的實際繪製順序裡,後者反而蓋在前者上面——因為沒有 position 屬性的元素,z-index 根本不會生效,而我原本以為這行 z-index: 1 一定管用。調整成明確給 .decor 設定 z-index: 2、.content 也加上 position: relative; z-index: 1,才讓 .decor 真正蓋到上面。我用 browse eval 跑 document.elementFromPoint()、再用 browse mouse click 對準按鈕的實際座標點一次,確認回傳的元素是 .decor 而不是按鈕本身,點擊完全沒有觸發訂閱邏輯,才敢把這個當成一個夠格的題目。
這個過程剛好示範了題目設計本身要經過的驗證:乍看是「裝飾層在內容下面」的正常寫法,實際上順序反了,而且這種反轉只有自己動手點一下,或是認真在腦中模擬完整的 CSS 疊圖規則,才看得出來——連我自己都在設計階段先猜錯一次,更不用說光讀程式碼掃過去的人。
我拿掉這個技能跑了一次基線,結果意外地好:它自己寫了 Playwright 腳本,抓出按鈕被疊圖擋住、Playwright 的錯誤訊息精確到「<div class="decor"> intercepts pointer events」,還找到 email 驗證只檢查有沒有 @、按 Enter 不會送出(輸入框沒包在 <form> 裡)、「訂閱成功」其實是前端寫死沒有真的送出任何請求這幾個次要問題,甚至主動把 CSS 暫時改成 pointer-events:none 驗證過修法有效,才又還原回去,全程沒有留下任何改動。這代表就算完全不靠這個技能,現在的模型已經有「寫測試腳本、真的跑一次」的本能,不是只會讀程式碼空想。基線自己也誠實列了沒測到的部分:手機版面沒測,無障礙工具沒用,而且主動問了一句「如果這是正式頁面,實際上沒有收到任何訂閱,這是不是刻意的 demo」——這種把自己判斷不了的地方攤開問,而不是悄悄假設,也是這系列一路測下來常常在看的品質指標。
接著我在同樣的環境裡裝上 ui-test,用幾乎一樣的提示再測一次:「這是一個訂閱表單頁面,幫我測試這個頁面有沒有問題。」結果跟沒裝技能那次幾乎一模一樣——還是自己寫 Playwright 腳本、還是抓到同一個 bug。我把這次的完整對話紀錄翻出來,搜尋有沒有出現 Skill 工具呼叫、搜尋「Round」「adversarial」「browse mouse」「browse click」這幾個只會出現在 ui-test 文件裡的字眼,全部是零——技能名字本身只在系統自動列出的「可用技能清單」裡出現過,從來沒有被真的讀取或叫用過。技能裝著,但從頭到尾沒被讀過。
同一個頁面,這次提示改成「請用 ui-test 這個技能幫我測試這個頁面有沒有問題」。這次完全不一樣:先叫出技能本身,接著在動手之前,把完整的三輪規劃攤開寫出來。開場第一句話就先把立場講清楚:
先讀過原始碼,因此規劃時知道要重點驗證
.decor遮罩(z-index:2,蓋在.content的z-index:1之上)是否攔截點擊。這是我的假設,要由瀏覽器實測確認,不能只憑讀程式碼就下結論。
接著是三輪規劃本身:第一輪四條基本流程(載入頁面、合法 email 送出、空白送出、沒有 @ 的輸入);第二輪七條對抗性案例,包含上面那個疊圖假設要怎麼驗證(elementFromPoint 檢查中心點命中的是誰)、超長輸入、特殊字元與 XSS、快速連點三次;第三輪補上鍵盤流程、無障礙(label、aria-live、色彩對比)、375px 手機寬度會不會橫向溢出。十五條測試去重合併後,分成兩組——Group A「互動與功能」含真實點擊,Group B「遮罩驗證與無障礙」——各自派一個子代理去跑,每組大約 40 步,而且兩組同時開瀏覽器時用不同的 session 名稱隔開,避免互相干擾。
最後交回來的結果是:16 項測試、8 過 7 敗 1 跳過,兩個子代理「獨立」驗證出同一個疊圖問題——失敗的測項精確點名了 valid-submit、empty-submit、no-at-submit、input-focus-click、overlay-hit-test 這五條,每一條都附了截圖檔名。比基線多出來的,是幾個基線完全沒做到的細節:算出紅字在白底上的對比度是 4.00:1,低於 WCAG AA 要求的 4.5:1,而且特別註明「實際背景是米白色,所以對比會更低」,沒有停在算出一個數字就交差;發現滑鼠點不到按鈕,但鍵盤操作(Tab 到輸入框、輸入、Tab 到按鈕、Enter)完全正常,所以問題精準地只影響滑鼠和觸控使用者;375px 的手機寬度沒有橫向溢出;XSS 輸入沒有被當成 HTML 插入,window.__xss 不存在。
更值得記的是,整合結果時它抓到了自己派出去的子代理講錯的地方——某個子代理回報「前後空白的 email 會被 trim 掉」,但它回頭對照原始碼,發現根本沒有 trim() 這個函式,那組輸入能通過只是因為裡面剛好含有 @,驗證邏輯本來就只檢查這一點。它沒有把子代理的說法照單全收寫進報告,而是直接標註「agent 的說法有誤」,附上正確的解釋。這代表整個流程裡「主代理規劃、子代理執行、主代理整合」這個分工,不只是為了跑得快,整合這一步也真的在做覆核,不是單純把子代理的話照抄一遍。
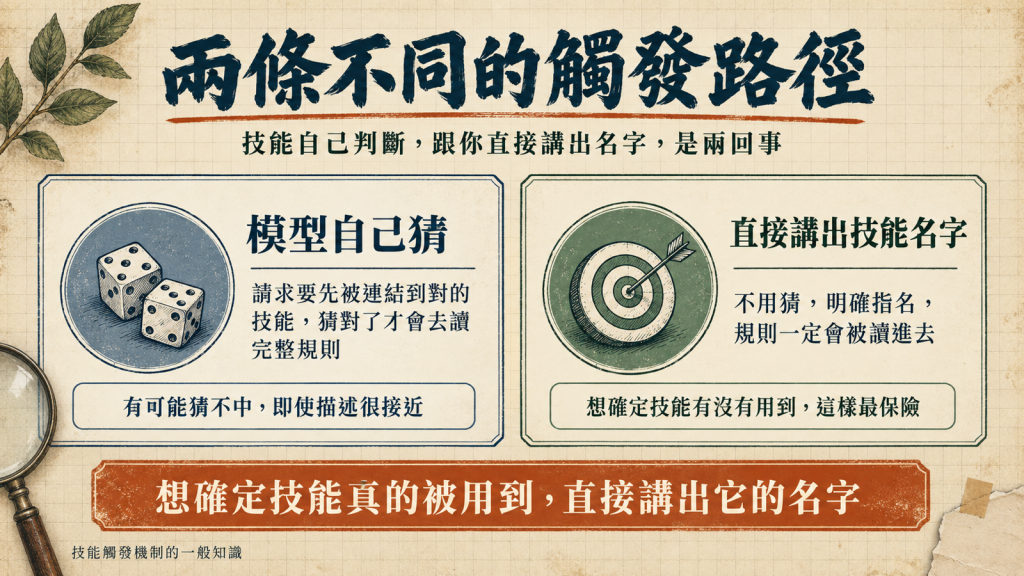
三種情境放在一起看,關鍵的分界點不是「模型聰不聰明」,是「這個技能有沒有被讀進去」。ui-test 的觸發描述寫得相當具體——「當使用者要求測試 UI 變動、審查 PR、稽核無障礙,或跑探索式測試」——照理說「幫我測試這個頁面有沒有問題」應該算是很貼合的請求。但模型自己判斷「要不要去讀一個技能的完整內容」,跟使用者直接講出技能名字,終究是兩種不同的觸發路徑:前者要先猜這個請求跟哪個技能最相關,猜中了才會去讀完整規則;後者是明確指名,不用猜。今天恰好測到的是前者猜錯、後者命中——而且猜錯的那次,並不是因為模型能力不夠(它自己寫的 Playwright 腳本品質也不差),是這個特定請求沒有被連結到這個特定技能。這跟 Day 14、17 測到的「規則讀了但判斷沒接住」又不一樣,是更前面一步:連「要不要讀」這個判斷都沒發生。
ui-test 自己的觸發詞(「測試這個頁面有沒有問題」)照講一遍,裝著的技能還是完全沒被讀取。想確定某個技能有沒有真的派上用場,與其照著直覺下指令,不如直接把技能名字講出來。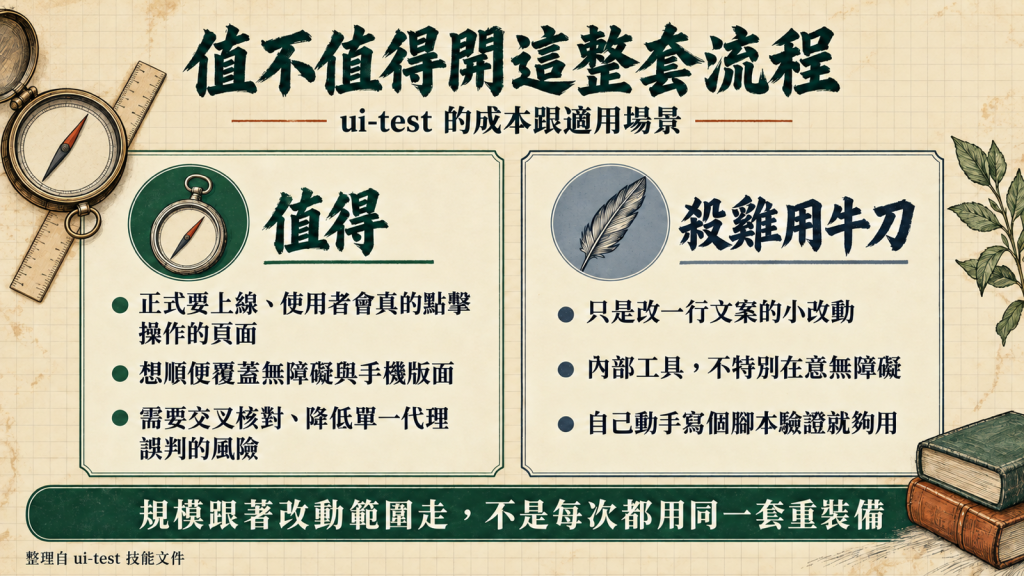
這套流程的成本不低——三輪規劃、多個子代理、每組 40 步的預算,比起自己隨手寫個 Playwright 腳本重很多。適合用在正式要上線、UI 變動牽涉到使用者真的會用滑鼠跟鍵盤操作的頁面,尤其是你想要「無障礙」「手機版面」這些容易被漏掉的面向也一併覆蓋到的時候。如果只是改一行文案、或是內部工具不太在意無障礙,花這整套流程去測可能是殺雞用牛刀——基線那種「自己寫個腳本驗證一下」的做法,今天測起來已經夠用。
今天選的題目剛好是個「一測就垮」的明顯 bug,三種情境都抓到了同一個問題,沒辦法看出這個技能在「bug 比較隱晦、要連點好幾次才會現形」這種情境下,規劃的完整度有沒有差別。子代理步驟預算是技能自己決定的,我沒有刻意去逼近預算上限、看它會不會因為步數不夠而漏測。而且我只測了一次顯式呼叫,沒有重跑驗證「指名道姓就會跑完整流程」這件事有多穩定——這次的三輪規劃寫得工整、子代理分工也乾淨,換一次跑,細節上可能會有落差。另外色彩對比度那個數字是它自己算出來的,我沒有拿專門的工具(例如瀏覽器內建的對比度檢查器)重新驗證一次 4.00:1 這個數字對不對,也沒有去追「trim() 那個子代理為什麼會講錯」這件事——是子代理憑印象講的,還是真的讀錯了程式碼,今天沒有深究,只確認了主代理有把它糾正過來這個事實。
這個頁面也刻意做得很小,只有一個表單、一支腳本,ui-test 文件裡講到的「diff-driven」工作流程(只測有改動的部分)今天完全沒機會測到,因為沒有既有的 git 歷史可以比對;平行跑多個 Browserbase 遠端瀏覽器那個模式也沒測,因為今天全程只用本機瀏覽器。
這個結果剛好把這系列從 Day 14 就開始反覆驗的一件事,又補上一塊:裝了技能不等於會被用到,這點今天又中了一次。但今天多出來的是第三種情境——指名道姓硬是把它叫出來之後,流程確實照著文件寫的樣子跑了一遍,而且跑出來的東西比不叫它時更紮實。前面幾天測到的多半是「有沒有被叫到」這個二分結果,今天額外證明了「真的被叫到之後,值不值得」——今天的答案是值得,差別不只是多抓一個 bug,是多了一層交叉核對的機制。
今天也讓這系列第一次真正碰到瀏覽器自動化這個領域,連帶把「用 AI 寫測試」這件事的門檻又往下拉了一截——browse CLI 純本機就能跑,不用排隊申請雲端帳號,這代表接下來想繼續測別的瀏覽器相關技能,門檻也不會太高。
明天想找一個完全不同的方向繼續測,這系列的候選清單還在累積。


 iThome鐵人賽
 看影片追技術