
昨天測的 prompt-improver,主張是「自動攔下模糊的話,問清楚再做」,結果是規則讀了、範例也對上了,實際判斷卻沒接住。今天換一個做法完全不同的機制,目標一樣:grill-me,來自 Matt Pocock 的技能包。這個名字可能眼熟——TypeScript 教育圈很有名的人,AI Hero newsletter 六萬訂閱,他的 mattpocock/skills 這個 repo 星數 274,445,比 VS Code 還高,我用 gh api 核對過是真的,不是灌水,反映的是他本人在社群的影響力。
grill-me 跟 prompt-improver 要解決的是同一個問題——人沒把需求講清楚,AI 就自己腦補——但做法是反過來的:不是系統自動判斷「這句話夠不夠清楚」,是把決定權交給使用者,要你自己主動打一個指令,換來一輪不怕麻煩的拷問。

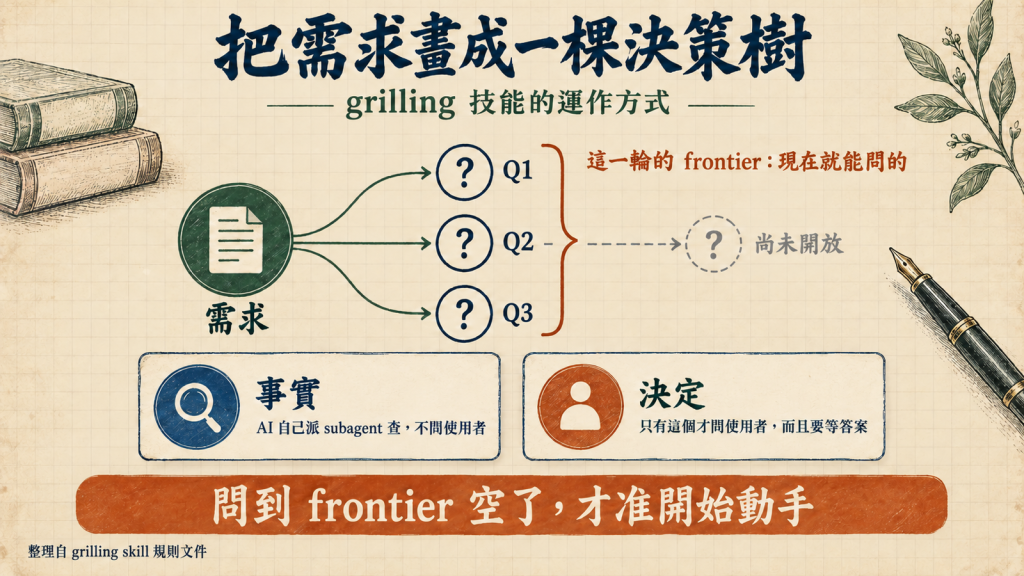
grill-me 本身只有一行內容:呼叫另一個叫 grilling 的技能。真正的邏輯都在 grilling 裡,原文照抄核心設計:
Map this as a design tree: every decision branches into the decisions that hang off it.
Work the tree in rounds. The frontier is every decision whose prerequisites are already settled: the questions you can ask now without guessing at answers you haven't heard yet. Ask the whole frontier in one round...
把一個需求拆成一棵決策樹,每個決定底下可能還分出更多決定。「frontier(前沿)」指的是這一輪已經有足夠前提可以問的那些問題——不等前面的答案也能先問的,一次全部問完,不要一題一題來回。格式也寫死了:每題用 ❓ Qn 編號,附一句自己的建議答案(➡️),讓使用者可以用「全部照建議」的方式快速過關,不用每題都重新想。
規則裡還有一條分工,是今天測出來最關鍵的一句:
Finding facts is your job, never the user's. ... dispatch a sub-agent to find it; don't ask the user for anything you could look up yourself.
「事實」是 AI 自己的工作,不是使用者的——技術棧是什麼、專案裡有沒有登入機制,這些查得到的東西要自己派 subagent 去查,不准丟給使用者回答。只有真正的「決定」(這個功能要不要跨裝置同步、要不要顯示收藏數)才問人。結束的條件也寫清楚:「frontier 空了」,決策樹每一條分支都走過,沒有任何一處是默默假設過去的,才算完成;完成之前不准動手做。
準備了一個很小的 Next.js 專案:首頁列出兩篇文章,資料是寫死在記憶體的陣列(lib/db.ts),沒有登入、沒有資料庫、沒有文章詳情頁。任務只給一句話:「幫我在這個 Next.js 專案裡加一個『收藏文章』的功能。」不講存哪裡、不講要不要帳號、不講要不要列表頁——這些全部是真正的設計決定,刻意留給測試。
一組直接丟這句話;另一組在前面加 /grill-me,讓 grilling 技能先接手。
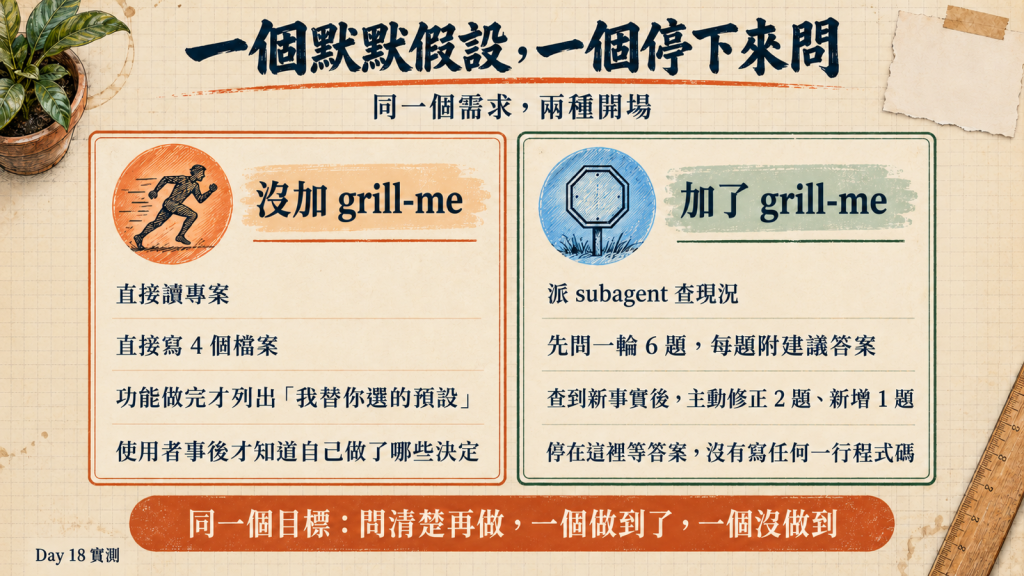
沒加 /grill-me 那組,行為很乾脆:自己讀了 package.json 和 lib/db.ts,兩次 Bash 查完現況,接著直接寫了四個檔案——收藏資料層、一個 Server Action、改過的首頁、新的收藏清單頁,全部做完才在回覆尾巴列出「我替你選的預設」:收藏存記憶體、不分帳號、用 Server Action 不開 client component。這些選擇都合理,說明也很清楚,但整個過程沒有一句話是在問,使用者是在功能做完之後才知道自己其實做了哪些決定。
加了 /grill-me 那組,從頭到尾沒有寫下任何一行程式碼。對話紀錄裡,它先派了一個 Explore 子代理(model: haiku,符合「查資料用便宜模型」的分工慣例)去挖專案現況,同時自己先問出第一輪六題——誰可以收藏、要不要跨裝置同步、需不需要收藏清單頁、按鈕放哪、要不要顯示收藏數、文章下架時收藏怎麼辦,每題都附建議答案。子代理回報結果後,它做了一件很值得記下來的事:明確講「Q1–Q6 還沒有人回,我不會當成已答」,然後發現子代理查到的事實(專案沒有登入、沒有資料庫、沒有詳情頁)跟自己原本問題裡預設的前提衝突,主動把 Q1、Q2、Q4 改掉,新增一題 Q7,最後才把修正後的完整清單丟回來,附一句「請回答 Q1、Q2、Q3、Q5、Q6、Q7」,停在那裡等。
修正後的 Q1 原文照抄,可以看出它怎麼把「查到的事實」轉成「真正該問的決定」:
❓ Q1(修正) - 誰可以收藏?:專案目前沒有使用者概念,可選三條路:
(a) 不做帳號,收藏存在瀏覽器 localStorage,只對該瀏覽器有效。
(b) 不做帳號,伺服器用 cookie 辨識匿名訪客,收藏存伺服器。
(c) 先補認證和資料庫,再做收藏。
➡️ 建議 (a)。範圍最小、可逆,之後要升級成 (c) 時,只要把 localStorage 的內容在登入時搬進資料庫即可。
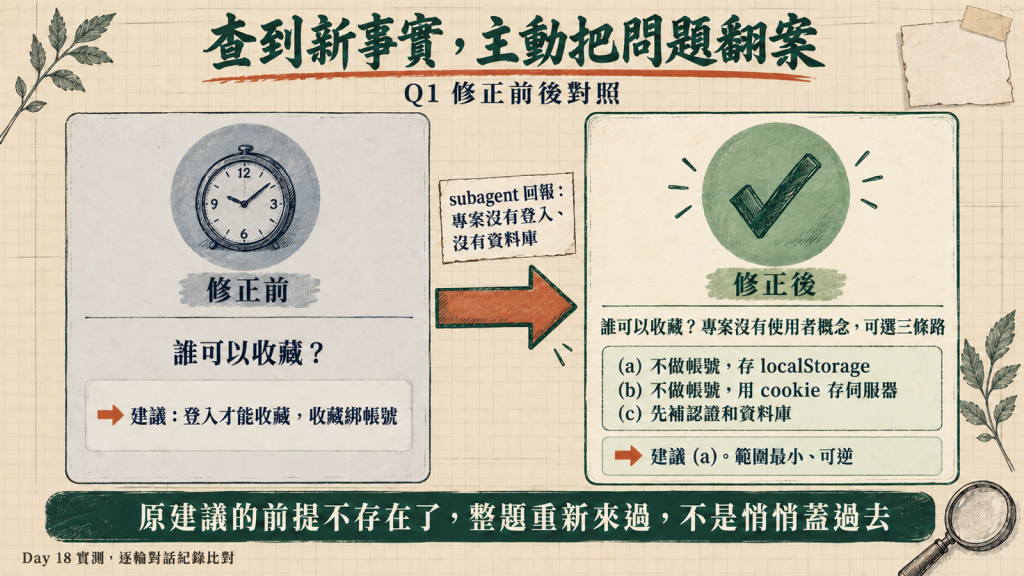
這題原本的建議是「登入才能收藏」,查完事實後整個翻案,因為原建議的前提(專案有登入機制)根本不存在。它也沒有把套件管理器這種查得到的小事丟回來問,原文:「套件管理器我會自己查鎖檔,不用你回答」——完全對上規則裡「事實自己查,決定才問人」那條分工。
同樣是「問清楚再做」,這次做得準,關鍵不在模型比較聰明,是機制設計本身把「容易出錯的地方」先排除掉了:
prompt-improver 的失敗點,正好就是「模型自己判斷這句話算不算模糊」這一步沒接住;grill-me 不需要判斷,使用者主動打了,就一定會跑。這跟昨天的對比也很清楚:同一個「問清楚」的目標,自動判斷式的做法失敗了,顯式觸發+具體流程的做法成功了。 不是因為顯式觸發天生比較可靠,是因為「要不要問」這個判斷題被拿掉了,剩下的只是「怎麼問」這個可以寫成具體步驟的問題——後者對模型來說明顯更容易做對。
claude -p)單輪模式測,grilling 規則裡「等使用者回答下一輪」的多輪來回,今天沒辦法真的測到——只看到了第一輪問題、子代理回報、修正後的第二輪,使用者還沒回答流程就結束了。昨天跟今天放在一起看,是這系列目前最乾淨的一組對照:同一個「先問清楚再做」的目標,自動判斷式的 prompt-improver 沒接住,顯式觸發+具體流程的 grill-me 完全接住,而且接得比預期更細緻(事實翻案、問題修正)。這代表「機制有沒有用」真的要分開看兩層:有沒有被觸發,跟觸發之後設計得好不好,是兩件獨立的事,不能用其中一天的結果去代表整類機制。
Matt Pocock 的技能包裡還有一個 grill-with-docs,做的事更進一步——不只問清楚,還會把討論出來的設計決定寫成一份共用詞彙表,號稱能讓之後的 session 用詞更一致、輸出更精簡。這是獨立的主張,留到明天單獨測。


 iThome鐵人賽
 看影片追技術