
在上一篇文章 Day 10:在 Spring MVC 裡寫 suspend function,能動但有代價 最後留下一個問題:如果限制的源頭是底層容器骨架,有沒有一種框架,從底層設計開始就不是 Thread-per-Request 模型,執行緒與請求之間的關係從一開始就不是一對一綁定到底?
今天正式回答這個問題。
Spring WebFlux 就是這樣的框架。它底層建立在 Reactor 這個反應式程式設計函式庫之上,採用一套與 Thread-per-Request 完全不同的方式處理連線,這種底層模型稱為 WebFlux 反應式模型,這個詞從今天開始正式定案,後續全系列一律使用這個名稱。
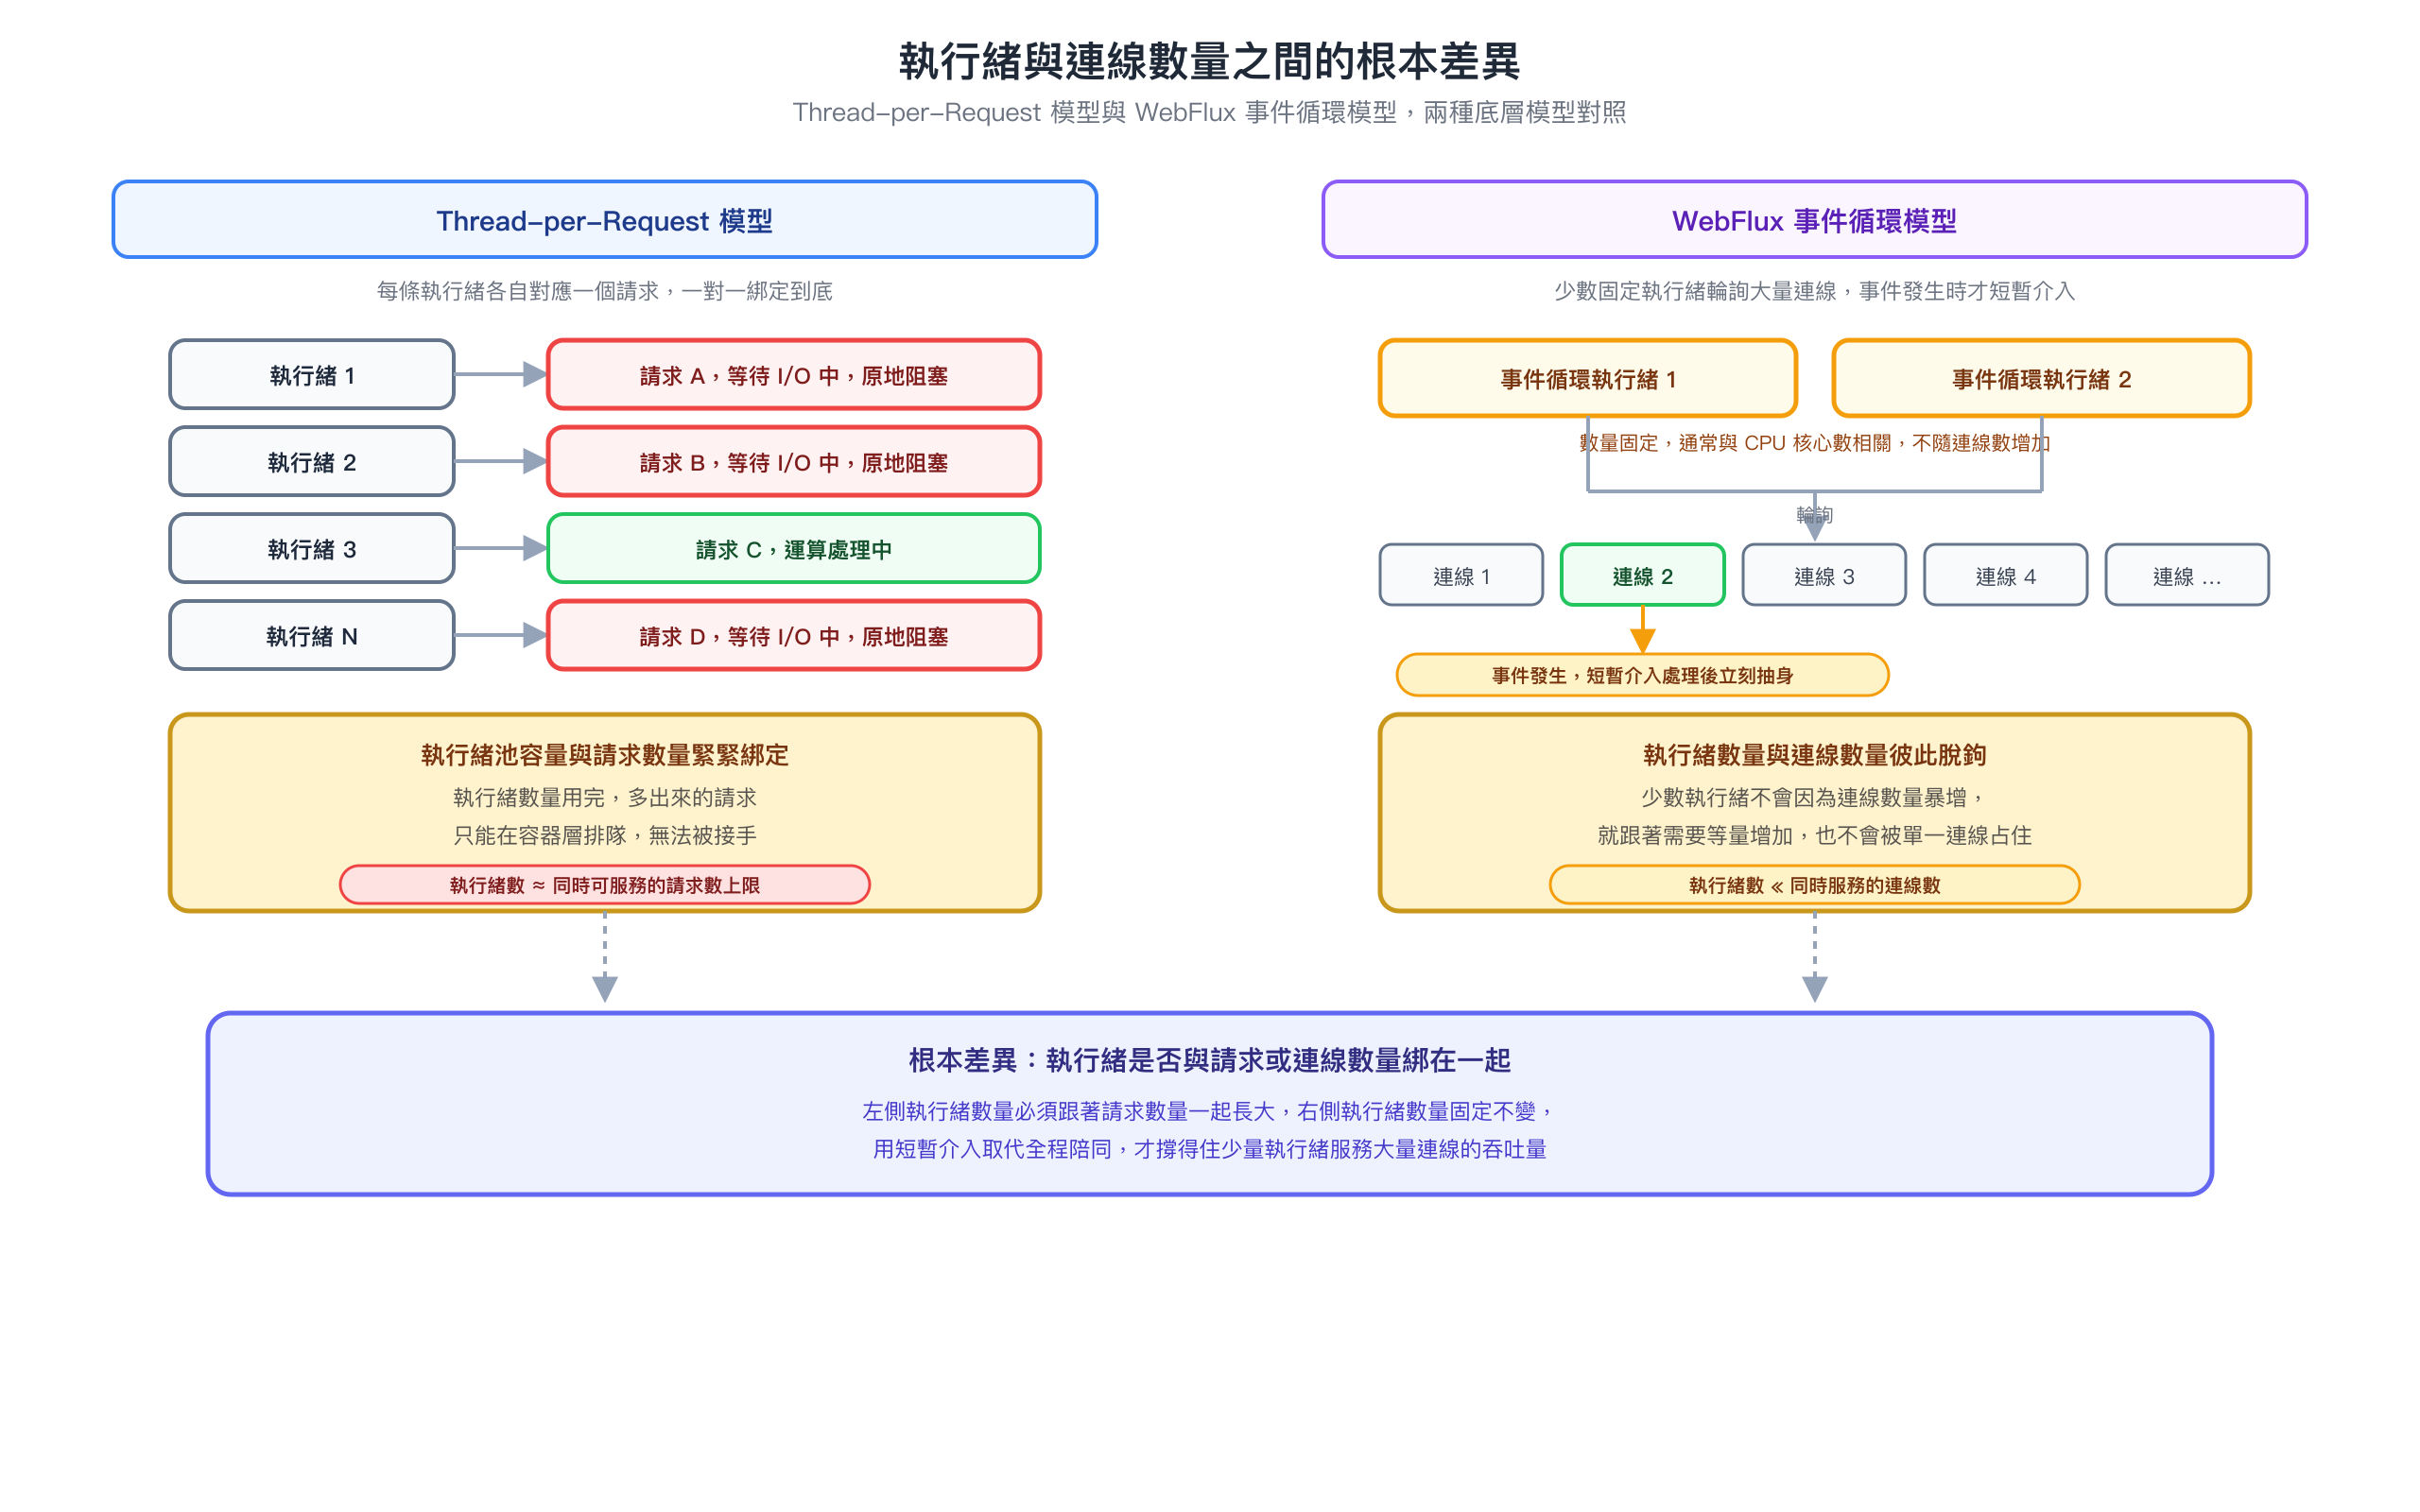
先把最核心的差異講清楚。Day 02:Thread-per-Request 模型的極限,搞懂你原本在用什麼 定案的模型,是每個請求配置一條執行緒,這條執行緒從頭到尾陪著這個請求走完,執行緒池的容量因此決定了系統同時能處理的請求數量上限。WebFlux 底層完全不是這樣運作的。
WebFlux 不會為每個進來的請求配置一條專屬執行緒,而是用少量固定數量的事件循環執行緒,透過非阻塞的方式輪流處理大量連線上發生的事件。這批事件循環執行緒的數量通常與 CPU 核心數相關,數量不多,可能只有個位數到十幾條,但它們不需要像 Thread-per-Request 模型裡的執行緒那樣,一路陪著某個請求從頭等到尾。當某個連線上有事件發生,例如資料已經準備好可以讀取,事件循環執行緒就被喚醒去處理那個事件,處理完立刻抽身,回頭繼續輪詢其他連線上有沒有事件發生,不會停在原地空等任何一個請求的後續進展。
拿訂單查詢與扣庫存服務套進來看會更具體。促銷活動開賣那一刻,大量查詢請求同時湧入,如果這支服務用 WebFlux 改寫,並不會像 Day 02:Thread-per-Request 模型的極限,搞懂你原本在用什麼 描述的那樣,執行緒池迅速被打滿、多出來的請求只能在容器層排隊等候。因為底層根本不是用「一個請求佔用一條執行緒直到處理完畢」的方式在運作,少數幾條事件循環執行緒不會因為同時有幾千個請求在等資料庫回應,就跟著憑空需要幾千條執行緒去對應。這幾條事件循環執行緒只在真正有事情可以做的那一刻才短暫介入,其餘時間都在輪詢,不會被任何單一請求的等待過程占住。
這裡也要誠實補一句,避免只看到好處而忽略代價。這個模型換來的高吞吐量,前提是整條程式碼鏈路都必須是非阻塞的。事件循環執行緒的數量原本就稀少,一旦鏈路中間有一段用了傳統阻塞式的呼叫,那條事件循環執行緒就會被卡在原地,而它負責輪詢的可不只一個連線,是大量連線共用的資源。這裡先點出這個風險存在,不深入展開細節,後面會再回頭談。
用程式碼建立一點視覺印象。WebFlux 風格的 Controller 方法,回傳型別通常是 Mono 或 Flux 這類代表非同步串流結果的型別,而不是直接回傳資料本身:
@RestController
@RequestMapping("/orders")
class OrderReactiveController(
    private val orderReactiveService: OrderReactiveService
) {
    @GetMapping("/{orderId}")
    fun getOrder(@PathVariable orderId: Long): Mono<OrderDetail> {
        return orderReactiveService.findOrderDetail(orderId)
    }
}
這裡只需要建立「回傳型別變成 Mono 這種東西」的第一印象,不需要深入 Mono 背後一整套反應式操作符怎麼串接、怎麼組合,那是完整的反應式串流理論,超出今天要建立的心智模型範圍。
前面建立了 WebFlux 底層模型的印象,但這裡有一個非常容易掉進去的陷阱,必須在往下讀之前先處理掉。
因為協程與反應式程式設計都號稱能處理高併發,都與「非阻塞」這個詞緊緊掛勾在一起,很容易讓人下意識把兩者當成同一件事的兩種說法,或者更糟,把兩者當成互斥的競爭技術,以為選了協程就用不到 WebFlux,選了 WebFlux 就不需要協程。這個分類框架是錯的,而且錯誤的影響很根本;一旦帶著這個錯誤框架,繼續往下讀這個系列,後面很多內容都會卡住。
正確的理解方式,是把兩者放在不同的層次上看待。協程是 Kotlin 語言層級提供的並發程式設計工具,處理的問題是「如何撰寫一段可以暫停又能被恢復的程式碼」,這件事從 Day 03:第一個 suspend function,協程到底暫停了什麼 一路到 Day 07:Dispatchers,協程實際跑在哪條執行緒上 定案的 Dispatchers,談的都是協程這個語言層級的機制怎麼運作。WebFlux 則是 Spring 框架層級的反應式程式設計模型,處理的問題是「整個應用程式底層要用什麼方式處理大量連線」,今天談的事件循環執行緒就是這個問題的答案。一個回答的是「程式碼怎麼寫」,一個回答的是「應用程式底層怎麼跑」,兩者根本不在同一個問題的同一個答案欄位裡,自然不存在誰取代誰的關係。
順著這個層次差異往下看,兩者不只不衝突,還可以直接搭配使用。Kotlin 協程實際上可以用來簡化撰寫基於 Reactor 的反應式程式碼,透過協程的語法包裝反應式串流的操作,讓開發者用近似循序的寫法撰寫原本需要串接大量操作符才能完成的反應式邏輯。這裡只建立「協程能搭配 WebFlux、而且能讓反應式程式碼寫起來更接近循序邏輯」這個方向性認識,不展開具體的轉換語法或 API 名稱,那些屬於更深入的實作細節,留到系列後面有需要時再處理。
如果只能記住一句話,可以記這句:WebFlux 決定了應用程式底層用什麼方式處理連線,協程則是在這個或其他底層模型之上,用來撰寫並發邏輯的語言工具。
這是兩個不同維度的技術選擇,可以同時存在於同一支應用程式裡,一個負責底層骨架,一個負責你動手寫程式碼時的表達方式。
讀到這裡,一個很自然會冒出來的問題是,既然協程可以搭配 Spring MVC,也可以搭配 WebFlux,那到底該選哪一種組合?
這是一個合理的問題,但今天還無法完整回答。完整的選型判斷,需要把資料庫存取這一層是否也能做到非阻塞這件事一併考慮進去,這件事本篇還沒有處理。這裡先明確告知,完整的選型判斷依據會在 《Day 14:小結:三種技術選型的判斷依據,MVC、WebFlux 各用在哪》 正式收斂成一個完整的說明。
今天只建立一個認識:選型需要考慮的維度,不只框架本身,還有更多拼圖尚未到位,不要把今天的內容誤當成最終結論。
回到前面提過的那個風險,事件循環執行緒一旦被阻塞式呼叫卡住,影響的不只是單一請求。現在把這個風險具體指向一個很實際的環節,追問下去。
即使應用程式用 WebFlux 搭配協程,整條請求處理鏈路理論上可以是非阻塞的,從接收連線、排程協程、到組裝回應,每一步都不會讓稀少的事件循環執行緒白白等待。但如果中間查詢資料庫這一步,用的還是傳統阻塞式的資料庫存取方式,會發生什麼事?稀少的事件循環執行緒可能因此被卡住,前面辛苦建立起來的非阻塞優勢就前功盡棄,整條鏈路的表現會被這一段拖累,回到與 Thread-per-Request 模型類似的等待窘境,只是這次卡住的執行緒更加稀少,影響範圍反而可能更大。
下一篇會補上這最後一塊拼圖,讓資料庫存取也不阻塞執行緒。
今天正式定案了 WebFlux 反應式模型這個錨點,把它與 Day 2 的 Thread-per-Request 模型放在一起對照,也把協程與反應式程式設計這兩個容易混淆的概念拉開成不同層次,各自負責不同的問題。《Day 12:R2DBC,讓資料庫存取也不阻塞執行緒》 會接著處理資料庫存取這一環。


 iThome鐵人賽
 看影片追技術