
Day 28:部署上線的協程專屬檢查清單 收尾時說,檢查清單確認完畢,理論上系統已經準備好上線,但清單畢竟是清單,逐項對照設定值是否合理,跟系統實際從請求進來到回應結束的完整行為是否真的如預期運作,還是兩件事,值得完整跑一次從頭到尾的驗收。今天就是這個驗收本身。
這篇文章不會出現任何新名詞,也不會再定案任何新機制。29 天累積下來的每一個觀念,此刻都已經各自站穩了腳步,今天要做的事情很單純:回到 Day 01:為什麼高併發後端需要協程,從一個會卡住的 API 說起 那個促銷活動情境,把它當成整條時間軸的起點,讓訂單服務實戰整合版真正經歷一次那個場景,沿途每個環節該對應哪一天建立的機制,就老老實實地標出來,不重新展開論證,只看它們此刻怎麼一起運作。
倒數計時歸零的那一刻,畫面跟 Day 1 描述的一模一樣:大量使用者同時查詢訂單、確認庫存,同時有一批人鎖定同一筆庫存極少的限量商品,準備搶購。系列開篇建立的那個情境,走過 28 天的鋪陳,今天終於被完整地放回它原本的場景裡運作一次。
如果這是一套傳統的 Thread-per-Request 架構,Day 02:Thread-per-Request 模型的極限,搞懂你原本在用什麼 講得很清楚,每個請求會佔用一條執行緒直到處理完畢,而查詢訂單狀態、確認庫存這些步驟,絕大部分時間都花在等待資料庫或下游服務回應,執行緒實際上什麼都沒做,卻依然被那個請求占著動彈不得。促銷流量一衝高,執行緒池很快被這些空等的請求打滿,後面湧入的請求只能排隊等一條執行緒被釋放,回應時間就是這樣從幾十毫秒一路墊到數秒甚至逾時。
今天的訂單服務實戰整合版走的不是這條路。Day 11:WebFlux 是什麼,協程與反應式模型的分工 定案的 WebFlux 反應式模型,搭配 Day 12:R2DBC,讓資料庫存取也不阻塞執行緒 定案的 R2DBC,讓整條鏈路從 Controller 到資料庫存取都是非阻塞的,Day 14:小結:三種技術選型的判斷依據,MVC、WebFlux 各用在哪 當時已經把選型理由收斂清楚,這套組合正適合這種高併發、等待密集的情境。請求不再需要綁死一條執行緒去空等,這是接下來整條時間軸能撐住的地基。
跟著其中一個查詢訂單請求,看它實際發生了什麼事。請求打到 OrderController.getOrder,Day 05:Coroutine Scope,協程住在哪裡、活多久 定案的 Coroutine Scope 在這一刻建立,它的生命週期跟這次請求綁在一起,請求還沒處理完,Scope 就存在,請求結束或中斷,Scope 也該跟著收掉。
OrderService.getOrderDetail 內部依序呼叫 orderRepository.findById(orderId) 與 stockCheckSemaphore.withPermit { stockClient.checkStock(orderId) },這兩段呼叫背後各自被排到 Day 07:Dispatchers,協程實際跑在哪條執行緒上 定案的 Dispatcher 所管理的執行緒資源上,等待資料庫回應或下游服務回應的那段時間,執行緒被讓出去做別的事,不是白白空等。Day 13:協程搭配訊息佇列與外部 API 呼叫的常見模式 建立的平行呼叫手法,在 deductStockAndFollowUp 這類扣庫存後續動作裡同樣派上用場,確認優惠資格與發送通知這兩個互不依賴的呼叫,各自用 async 平行發起,這正是 Day 06:Structured Concurrency,為什麼協程不能亂長亂放 定案的父子收斂關係的具體展現,父範圍知道自己底下有誰,也必須等它們都有結果才能真正結束。
這次請求身上還帶著一件事。Day 25:可觀測性第一步,讓協程執行狀況不再是黑盒子 建立的 RequestId,作為自訂的 CoroutineContext.Element,在 OrderController.getOrder 這一層用 UUID.randomUUID() 產生,並用 withContext(requestId) { } 包住後續呼叫。這個識別碼落在 Day 08:Coroutine Context 與例外處理,協程出錯了誰負責 定案的 Coroutine Context 裡,沿途所有的日誌輸出,無論最終跑在哪一條執行緒上,都能透過 coroutineContext[RequestId]?.value 被正確地串接回同一個請求。促銷活動當下,成千上萬個請求同時湧入,這個機制決定了事後追查某一個特定使用者的搶購請求到底發生了什麼事,還有沒有辦法把那些散落在不同執行緒上的日誌拼回同一條完整的故事線。
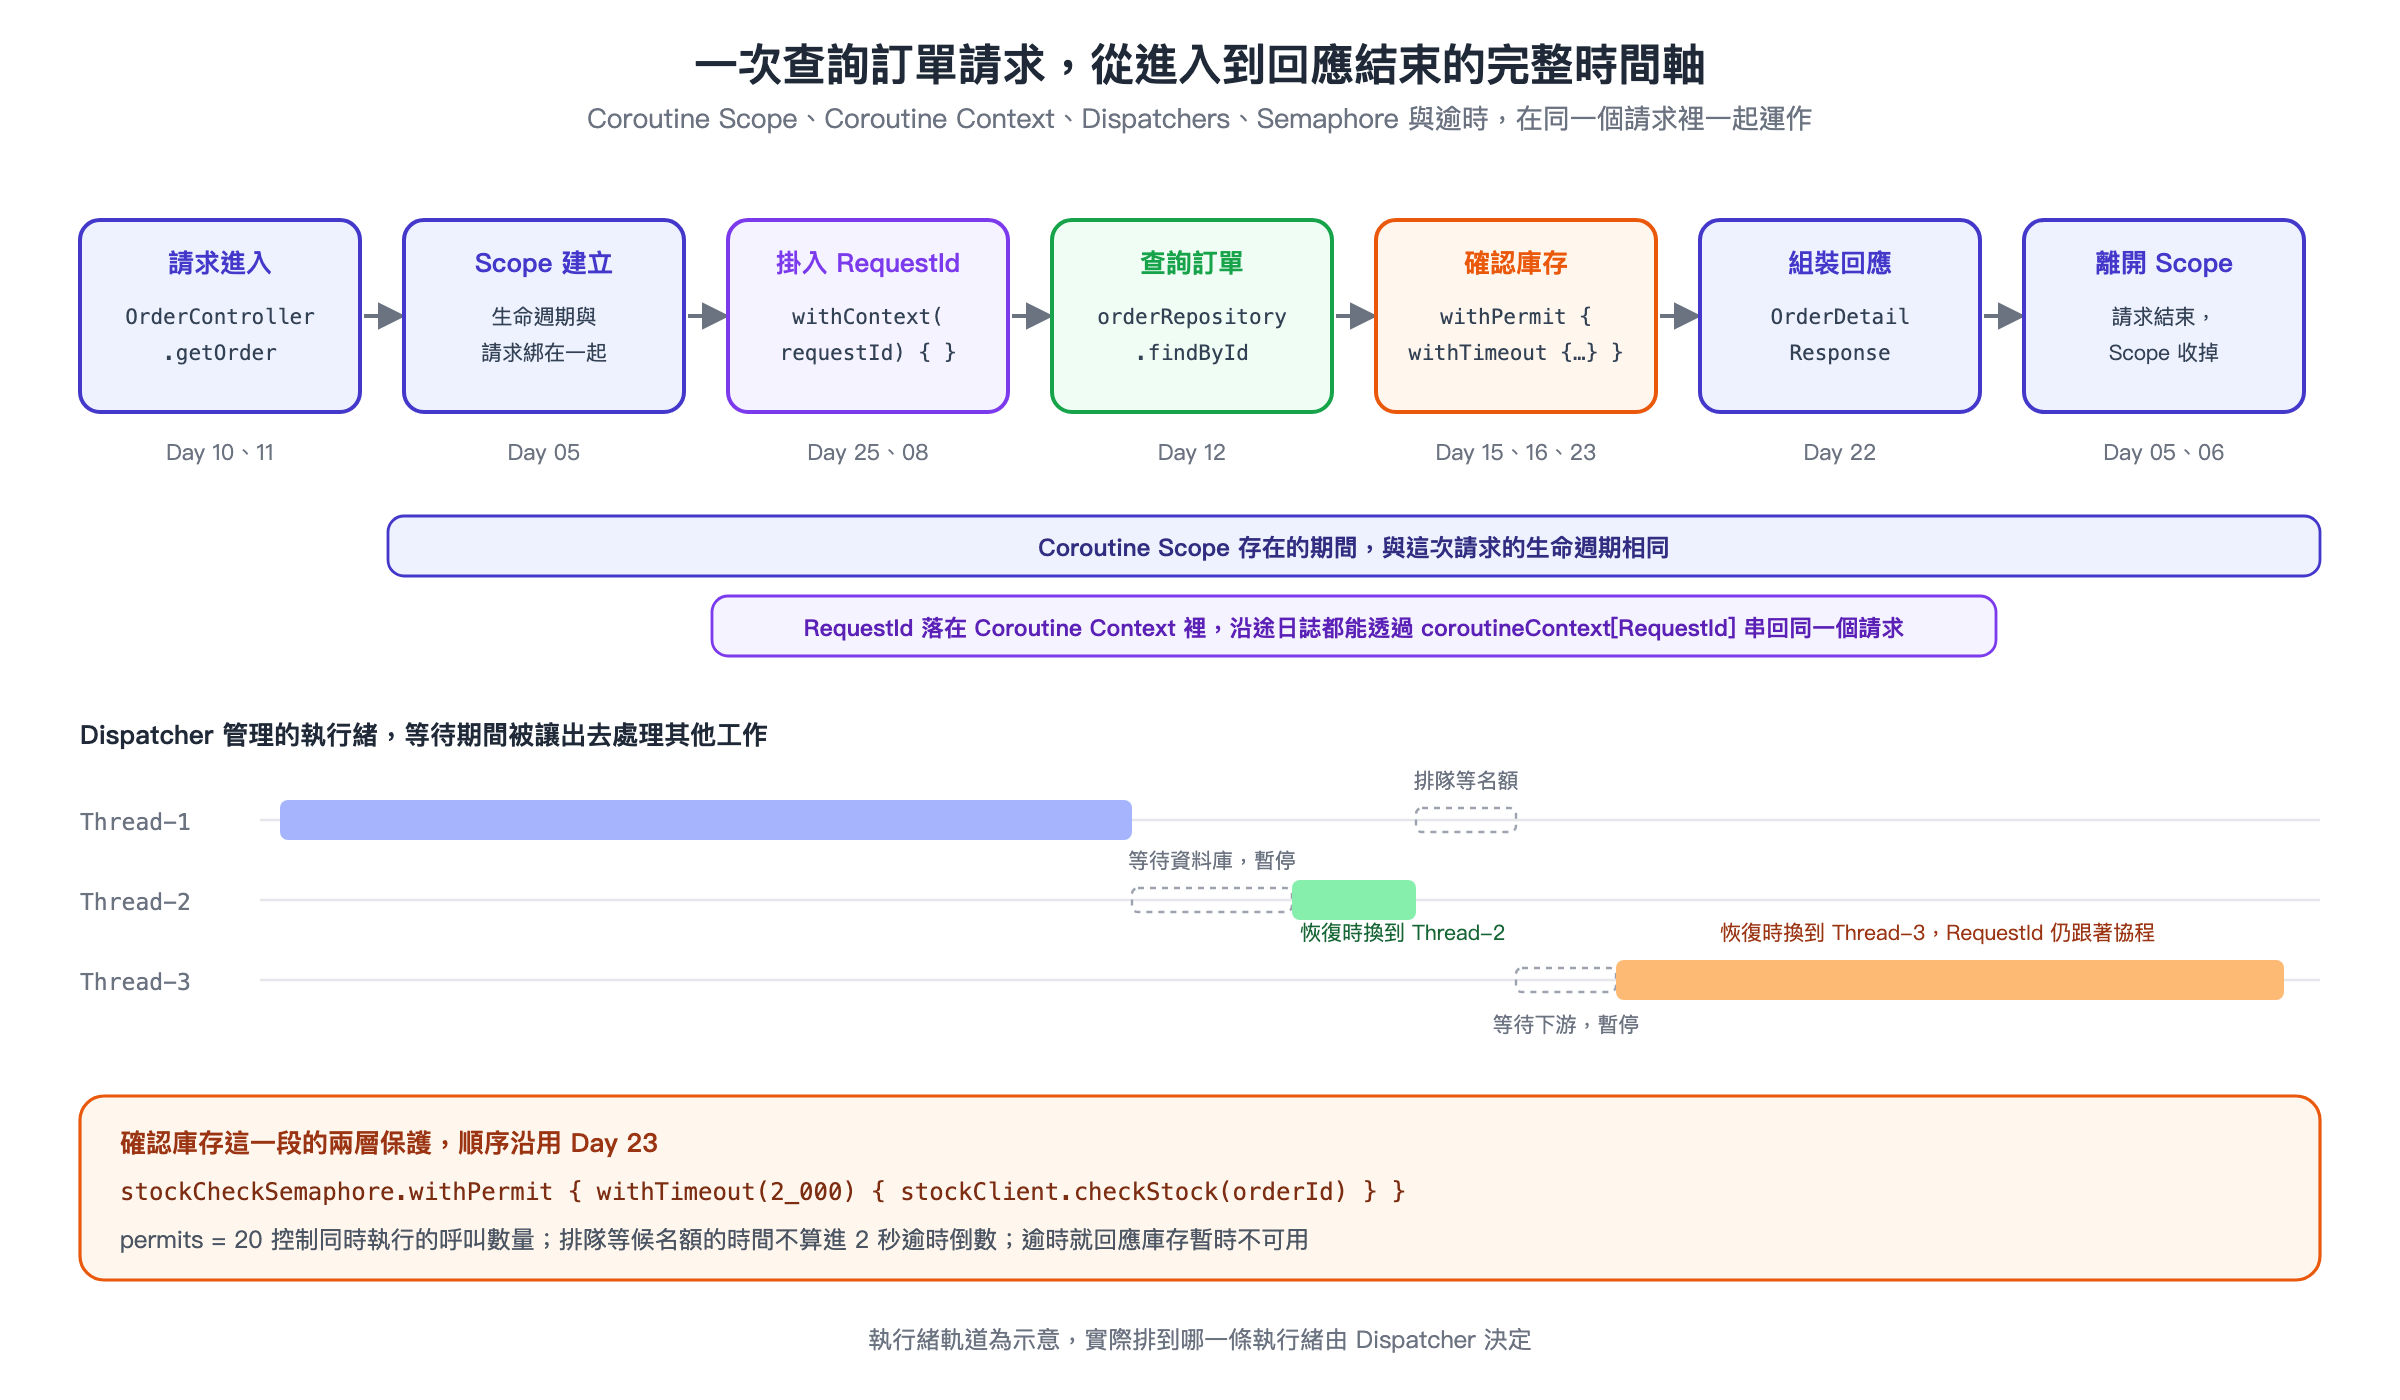
確認庫存這一步,正是整條鏈路裡真正暴露在外部依賴風險下的環節。Day 15:併發限制,用 Semaphore 保護下游別被打爆 定案的 Semaphore 節流,被 Day 23:把併發控制手段實際裝進訂單服務 實際裝進了 stockCheckSemaphore,permits = 20,同時執行的呼叫數量被控制在這個上限之內,超過的請求短暫排隊,而不是一股腦全部湧向確認庫存這個內部服務。這段呼叫同時搭配了 withTimeout(2_000),如果下游服務異常延遲,這次呼叫會在兩秒後主動放棄並回應使用者庫存暫時不可用,而不是無限期占著資源等待,兩者疊加的順序沿用 Day 23 定案的安排,withPermit { } 包在外層,withTimeout 包在內層,排隊等候名額的時間不算進逾時倒數。
查詢與更新資料庫這一步,依賴的是 R2DBC 連線池提供的連線,Day 18:協程遇上 R2DBC 連線池,小心連線被偷偷耗盡 已經講清楚,等待取得連線是暫停而非阻塞,但連線供需失衡依然會造成排隊。這項資源此刻的使用狀況,正被 Day 26:Metrics 與監控,量化你的協程效能表現 建立的監控機制持續記錄,使用中連線數量越接近 max-size 設定的上限,等待中的協程數量越不是零,就越接近連線池被打滿的警訊。促銷尖峰期間,這條曲線是團隊判斷連線池夠不夠用最直接的依據。
如果這個情境還涉及庫存異動事件這類持續性資料流,例如扣庫存成功後需要通知其他系統更新展示頁面上的剩餘數量,Day 17:背壓是什麼,生產太快時該怎麼踩煞車 定案的背壓機制會在這裡發揮作用,確保事件產生的速度超過消費端處理速度時,不會在 Channel 或 Flow 裡無限制堆積。這不是今天這場搶購驗收的重點路徑,簡短點出這件事在整條鏈路裡的位置即可。
真正的考驗發生在那筆庫存極少的限量商品上。多個使用者幾乎同時送出搶購請求,命中的正是 Day 24:庫存扣減的併發正確性,用資料庫機制取代分散式鎖 定案的核心場景。StockRepository.deductOneWithVersionCheck 這個樂觀鎖方法,在 WHERE 子句裡同時比對版本號與庫存數量,StockService.deductStockOptimistic 依照這次更新實際影響了幾列資料判斷成敗:
suspend fun deductStockOptimistic(stockId: Long): Boolean {
    val stock = checkNotNull(stockRepository.findById(stockId))
    val affectedRows = stockRepository.deductOneWithVersionCheck(
        stockId = stockId,
        expectedVersion = stock.version,
    )
    val succeeded = affectedRows > 0
    if (!succeeded) {
        versionConflictCounter.increment()
    }
    return succeeded
}
多個請求幾乎同時讀到同一個版本號,只有第一個成功寫入的請求,會讓資料庫裡的版本號真正前進一格,其餘請求帶著已經過期的版本號嘗試更新,affectedRows 落回零,succeeded 判定為 false,這些請求得到的是清楚的搶購失敗回應,而不是被悄悄蓋過去的錯誤資料。庫存扣減交易全程包在 TransactionalOperator.executeAndAwait { } 裡,查詢與更新被視為同一個原子單位,Day 06:Structured Concurrency,為什麼協程不能亂長亂放 定案的結構化並發精神,在這個交易邊界上同樣成立。
這整個過程發生的版本衝突次數,此刻正被 versionConflictCounter 這個 stock.deduct.version_conflict Counter 記錄下來,供後續團隊了解這波促銷活動的實際衝突頻率,不再需要像 Day 24 結尾那樣,只能憑空猜測衝突到底發生得頻不頻繁。這個計數器安靜地掛在 deductStockOptimistic 內部,此刻是它真正派上用場的時刻,衝突次數越高,代表這波搶購的競爭越激烈,這是一個能被具體讀出來的數字,不再是一團迷霧。
流量從爬升到尖峰再到回落,這整套曲線的走勢,跟 Day 20:實測結果解讀,協程贏在哪裡、代價又是什麼 與 Day 27:壓力測試,驗證系統在高併發下真的撐得住 先前用 k6 量測建立的預期表現相符。回應時間沒有在流量攀升時無止盡地惡化,錯誤率維持在可接受的範圍內,Semaphore 排隊帶來的等候延遲屬於可控範圍,樂觀鎖守住了庫存數字的正確性。前面投入的每一項觀念與機制,在這場真實情境下確實發揮了作用,不是紙上談兵的推演,是被實際流量走過一遍之後依然站得住腳的結果。
回頭看這整條路,從 Day 1 那個一到促銷就卡住、回應時間從幾十毫秒一路飆到逾時的 API,走到今天這個能撐住同樣情境的完整服務,中間走過的是一條循序漸進的路徑。每一步的理由都是明確的:先搞懂原本的 Thread-per-Request 模型到底把執行緒耗在哪裡,再建立協程暫停不等於阻塞的心智模型,接著花五天打穩 Scope、結構化並發、Dispatcher、Context 這套協程自己的世界觀,再花五天搞懂協程怎麼跟 Spring 生態系搭配,然後花七天補齊高併發情境下真正必要的控制手段,最後用八天把這一切收斂進一個具名專案,補上可觀測性與部署經驗。這不是一開始就理解了所有事情才動筆,是走過這條路才逐漸看懂每一塊拼圖該擺在哪裡。
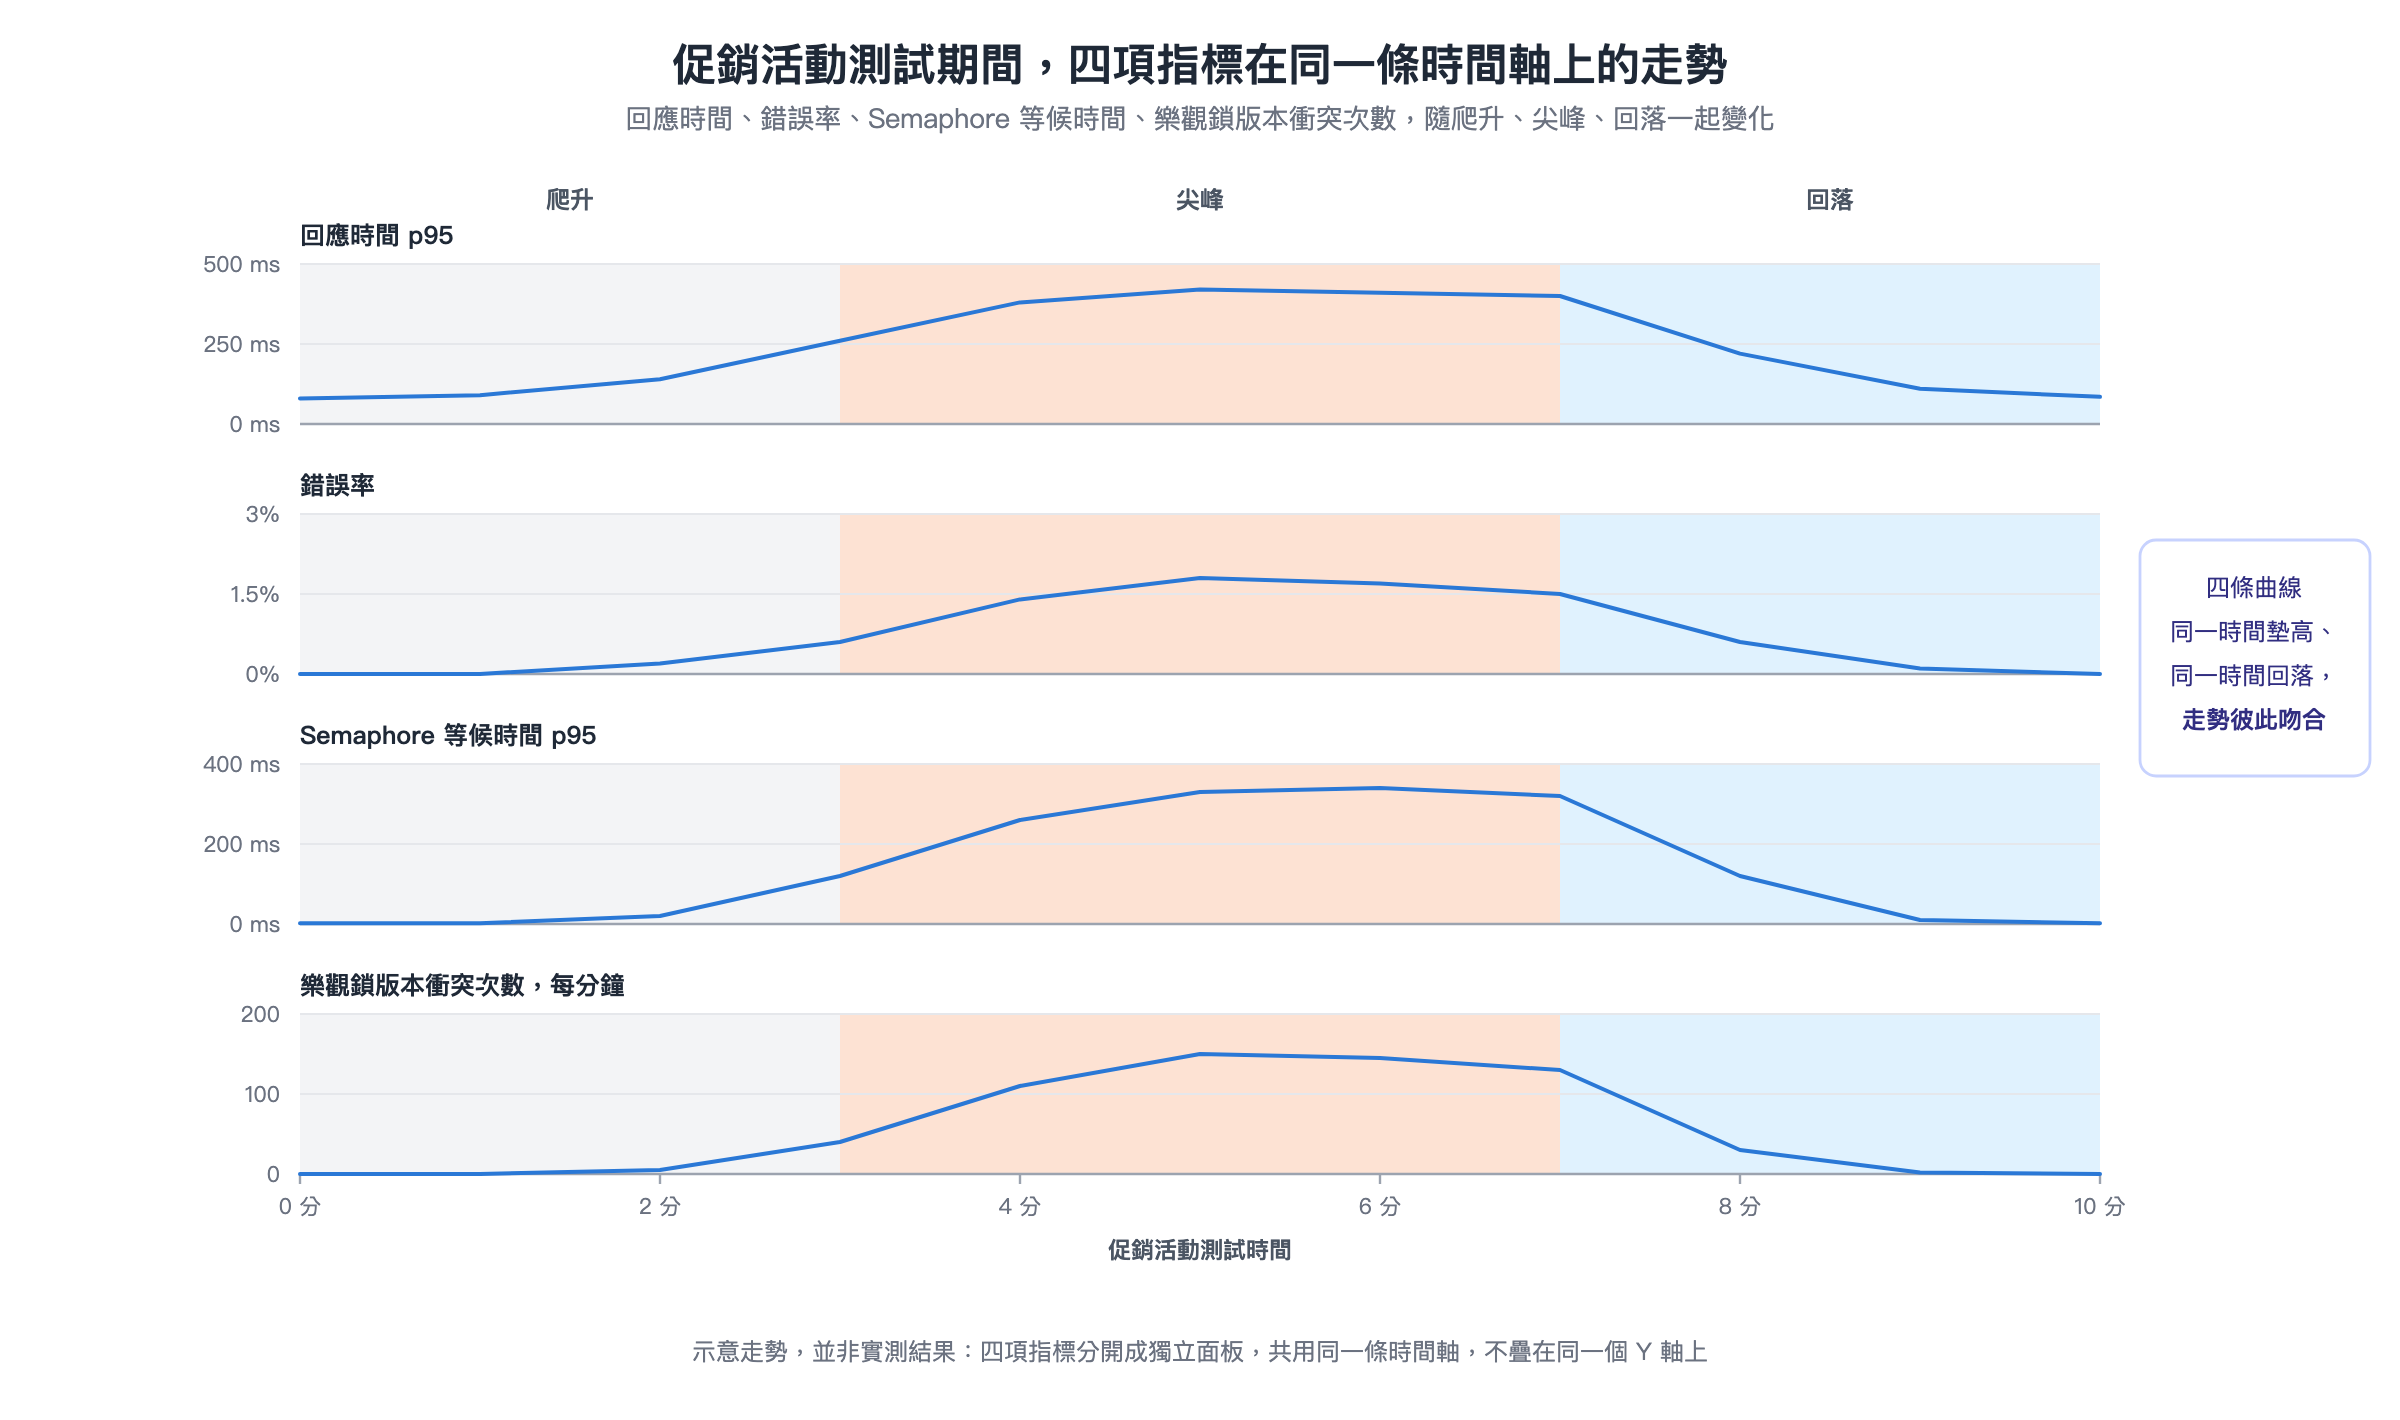
今天這趟端到端的驗收走完,回頭看看沿途標記過的每一站,Coroutine Scope、Structured Concurrency、Dispatchers、Coroutine Context、WebFlux 與 R2DBC 的選型、Semaphore 節流、逾時取消、背壓、R2DBC 連線池、樂觀鎖版本衝突控制,這些原本分散在 29 天裡各自獨立的知識片段,此刻確實串成了同一條完整的時間軸,撐住了 Day 1 那個曾經會卡住的情境。
累積到今天,這趟旅程已經留下了大量具體的知識與實作經驗。但如果退一步問,這一切最初到底是為了回答什麼問題,答案要回到系列第一天提出的那個疑問。走了這麼遠,是時候回頭看看那個問題原本問的到底是什麼,以及今天累積的這一切,能不能真正回答它。
下一篇,也是系列最後一篇,會回頭回應這個問題,並誠實檢討協程模型的限制。
《Day 30:完賽總結,Kotlin 協程適合與不適合的情境》 見。


 iThome鐵人賽
 看影片追技術