
前兩天在磨驗證的工具: Day 11 給了六招驗算法, Day 12 給心智清單降低驗證成本. 但驗證這件事有另一個環節你動不了 — 人的狀況.
想想這些場景:
這些不是猜測, 是 2024-2025 累積的實證. 這篇把兩個時間尺度都攤開, 也給有靠山的破法.
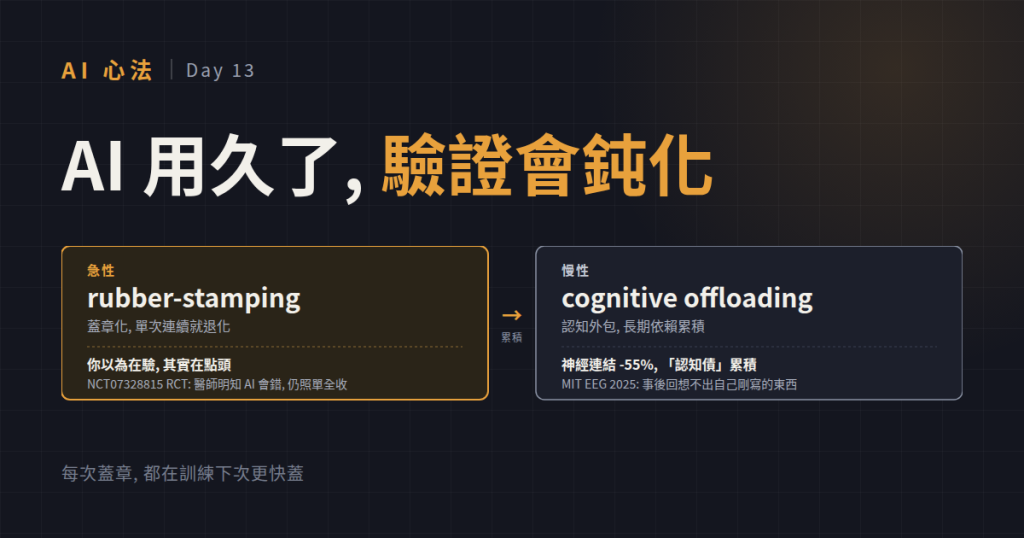
用 AI 用久了, 驗證會鈍, 分兩層講:
兩者不是兩件事, 是同一個機制在不同時間尺度上的顯現. Microsoft 2025 那份 survey 給了因果橋樑: 越信任 AI, 就越少實際去動腦; 每一次蓋章 = 訓練自己下次更快蓋 = 累積成長期的認知外包.
三份 2024-2025 的研究都指同一件事: 你以為在驗, 其實在點頭.
醫師知道 AI 會錯, 還是照單全收. 這是最硬的證據.
研究代號: NCT07328815 (2025). RCT = 隨機對照試驗, 兩組隨機分配, 一組拿介入一組拿對照, 是醫學實證裡最硬的證據等級之一.
設計: 72 名 AI-trained 醫師評估 6 個臨床案例, 其中 3 個是蓄意錯的, 配 ChatGPT-5.1 建議. 介入組多兩個提醒: (1) ChatGPT 平均準確度 (讓你知道它不是萬能), (2) 三個 LLM (Claude / Gemini / GPT-4o) 意見不合時的紅綠燈警示.
結果: 介入組 82.8% vs 對照組 75.6%, 差 +7.6pp (P=0.016, 意思是這個差異不是巧合).
意義: 沒警示的組別明明知道 AI 可能錯, 還是照單全收. 因為連續讀 AI 給的合理答案已經把批判性打疲了. 這是 rubber-stamping 的 RCT 級證據.
沒 XAI 的情境 (XAI = explainable AI, 會告訴你「為什麼這樣答」的 AI) — 醫師在 36.1% 被操弄的案例發生 automation bias (白話說 = AI 說什麼就信什麼). AI 錯的時候, 醫師跟著錯的機率是基準的 4.89 倍.
新手更慘: 從 79.7% 正確率掉到 19.8%, 只因 AI 給了誤導答案.
有 XAI 的時候, bias 從 36.1% 降到 17.8% — 有幫助但沒消失.
Copilot 建議的接受率從第一個月 28.9% 爬到第六個月 34%. 接受率隨使用時間爬升.
這個曲線跟航空業對 automation complacency (自動化自滿, 白話 = 用習慣自動化後的鬆懈) 累積半世紀的事故資料幾乎一樣. 你越熟 Copilot, 越傾向直接吞掉它給的補完.
三份 2025 研究從腦神經、行為、理論框架三個角度都指同一方向.
Kosmyna et al., 2025. EEG = 腦波檢測, 用貼在頭皮上的電極測腦電活動.
54 位受試者分三組 (LLM / 傳統搜尋 / 純腦子) 寫議論文, 全程戴 EEG. 結果:
論文自己創了個詞叫 "cognitive debt" (認知債): 用 AI 省下的思考, 累積成一筆日後要還的認知額度. 概念跟技術債一樣, 只是這次是你自己的腦子.
Lee et al., CHI 2025. 319 名知識工作者, 936 次真實 GenAI 使用的調查:
這份 survey 提供了「急性 → 慢性」的因果橋樑: 每次蓋章都在訓練「不動腦」變成默認.
Cleverly 2025 不是實證研究, 是提出 cognitive inheritance (認知繼承) 框架 — AI 的偏誤如何透過長期依賴被放大、複製到集體判斷. 值得看的是問題定型, 不是數據.
不是喊「多動腦」就行. 下面 5 招各有 2024-2025 的實驗數據或半世紀航空業經驗做靠山.
| 招式 | 白話說 | 相關研究背景 |
|---|---|---|
| 多 AI 對照 (ensemble) | 用 2-3 個 model 跑同題, 意見不合就升紅旗 | NCT07328815 RCT (+7.6pp 準確度) |
| 讓 AI 說原因 (XAI) | 讓 AI 顯示「為什麼這樣答」而不是只給結論 | Radiology 2023 (bias 從 36.1% → 17.8%) |
| 自己先寫再問 (pre-commit) | 打開 AI 前, 先寫下自己的假設或答案, 再問 AI, 再對比 | Generation effect (自己想的比較記得住) + Kosmyna 建議 |
| 純腦子日 (brain-only) | 固定比例 (例如每 3-4 個任務) 完全不用 AI, 純腦子完成 | Kosmyna「認知債」建議, 防長期累積 |
| 對抗性自測 | 定期餵 AI 已知錯的 output / 案例, 練自己抓錯 | 航空業慣例 (weekly failure drill), 醫療 RCT 已在試 |
共通模式: 都是主動把「自己動腦的機會」種回工作流裡. AI 太好用, 不會有機會自動出現.


 iThome鐵人賽
 看影片追技術