鐵人賽寫到倒數第二篇,前面談過的搜尋、商品資料整理,到最近幾篇介紹的 Agent,其實都建立在同一套基礎架構上。這一篇想退一步,把這套底層攤開來看:網站和後端放在哪裡、Agent 和資料整理 worker 用什麼方式執行、十幾個排程工作怎麼分工,以及新程式上線之前,staging 和 GitHub Actions 怎麼替我把關。
每個程式要一直開著,還是做完就關?
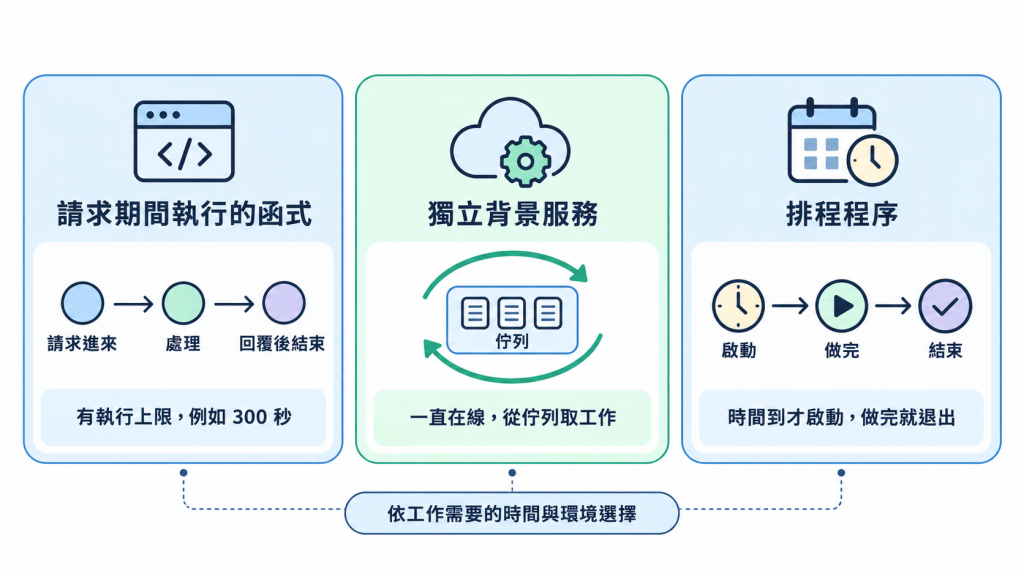
挑平台之前,我會先問每個程式一個問題:它需要一直開著嗎?依照答案,大致可以分成三種執行方式:
-
請求進來才執行的函式:也就是常聽到的 serverless function。有請求才啟動,不用自己管伺服器,但每次執行都有時間上限。以 Vercel 為例,免費的 Hobby 方案最長 300 秒,付費的 Pro 方案最多可以設到 800 秒。適合網站和很快就能回覆的 API。
-
一直在線的服務:隨時待命,可以馬上接請求,或持續從佇列(等待處理的工作清單)取出工作來做;但沒事做的時候,也一樣在計費。
-
時間到才啟動的排程程序:啟動、做完、結束,適合固定時間執行的資料整理、檢查和報告。
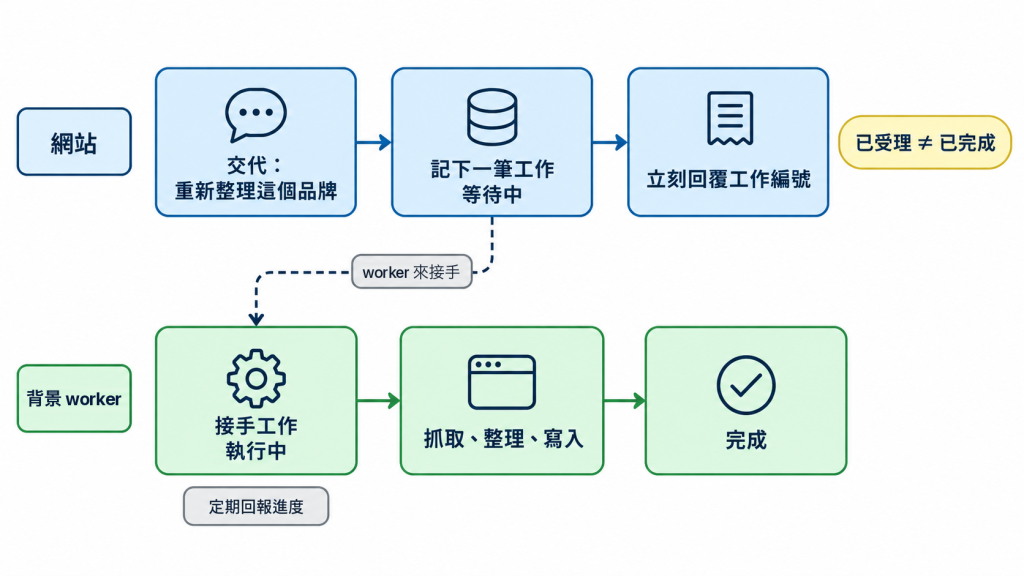
不管放在哪一種,要跑好幾分鐘的工作都不該塞在一次網頁請求裡,否則畫面得一直轉圈,等太久還會被平台中斷。比較好的做法是背景工作(background job):網站收到要求後,先在資料庫記下一筆工作、立刻回覆工作編號,再交給在背景執行的 worker 慢慢做。工作紀錄存在資料庫,程式重新啟動也不會遺失進度,隨時可以拿工作編號回來查。worker 每隔一段時間回報自己還在跑,太久沒有回報的工作就會被取消;失敗的工作重試之前,先比對資料是不是已經寫進去了,同一件商品才不會出現兩筆。
網站和後端:為什麼全部放在 Railway?
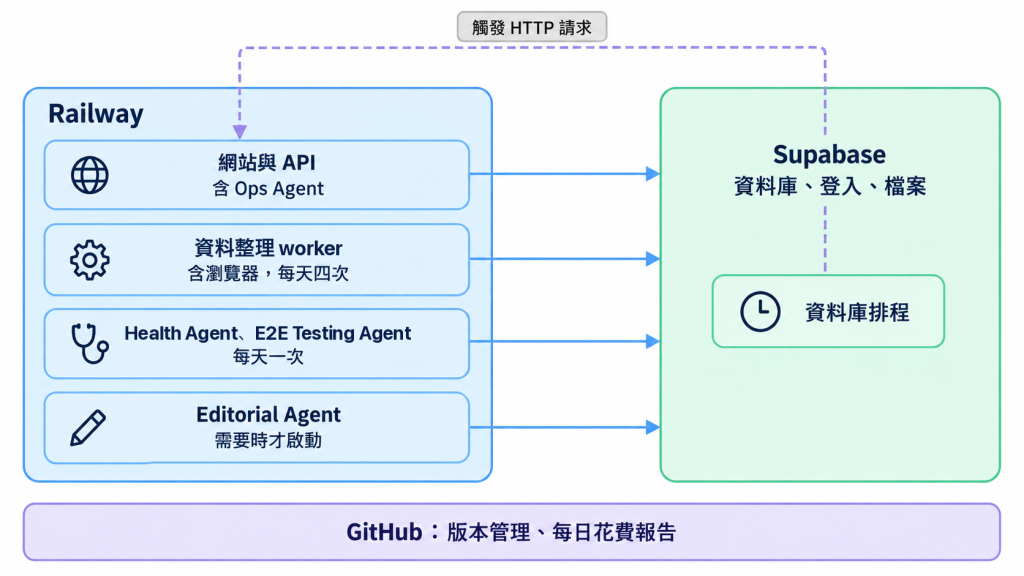
網站用 Next.js 寫成,後端的 API 也直接寫在同一個專案裡,沒有另外架一台後端伺服器。資料庫、登入和檔案儲存交給 Supabase,網站本身和其他服務則都放在 Railway。
我選 Railway,是看中它這幾個特性(以下為 2026 年 10 月查詢的官方文件):
-
一個專案裡可以開好幾個服務:網站、worker 和各個 Agent 都是獨立的服務,各自部署,也能各自設定要一直開著、用排程啟動,還是閒置時休眠。
-
執行環境由自己決定:可以用自己的 Dockerfile 建置,裝得下瀏覽器;服務是持續執行的程序,不像 serverless function 有單次執行的時間上限。
-
內建多套環境:同一個專案可以另外開一套 staging 環境,設定和正式環境分開。
-
依實際用量計費:依照用到的 CPU、記憶體和流量計費,Hobby 方案每月 5 美元,內含 5 美元的用量。服務用得少,費用就跟著降下來。
如果你正在挑平台,常見的選擇大致可以這樣比較:
-
Vercel:以網站和前端框架為主,適合放網站與短時間的 API;要留意函式的執行上限。
-
Railway:適合需要好幾種服務的專案;依用量計費,要留意資源用量和服務之間的連線設定。
-
Render:把網頁服務、背景工作和排程分成不同的服務類型;要核對各類型的限制和費用。
-
自己管主機:環境完全由自己決定,但更新、防護、備份和監控也都要自己來。
Agent 和 worker:依照使用頻率,決定執行方式
Railway 上依照工作的性質,拆成幾個服務:
-
網站與 API:回覆使用者的請求。Ops Agent 也在這裡接收 Slack 訊息;需要改程式的重工作,則交給 Claude Code Routine,用的是我原本就有的訂閱方案。
-
資料整理 worker:執行環境裡裝了瀏覽器,每天由排程啟動四次,把佇列裡的工作做完就結束。
-
Health Agent 和 E2E Testing Agent:各自是一個排程服務,每天清晨執行一次,跑完就退出。
-
Editorial Agent:平常處於休眠,需要寫文章的時候才被叫醒。
資料整理 worker 原本是一直開著的服務,後來我改成用排程啟動:手動派送一個月不到二十次,不值得為了這點即時性讓它整天開著。現在需要手動派送時,就請 Railway 立刻執行一輪,只是要多等一兩分鐘,讓執行環境啟動。
Editorial Agent 這類偶爾才用到的服務,則打開 Railway 的 serverless 設定:服務大約五到十分鐘沒有對外流量,就會進入休眠,不再佔用運算資源;有請求進來再喚醒,代價是第一次回應比較慢。以另一個只在修程式時才會被叫起來的服務來說,打開這個設定之後,每月費用從大約 2.5 美元降到 1.5 到 2 美元。
排程工作:Railway、Supabase 和 GitHub Actions 各自負責什麼?
整個專案目前有十幾個排程工作,分散在三個地方:
-
Railway 的排程:要開瀏覽器、跑比較久的工作,像是每天四次的資料整理,以及清晨的 Health Agent 和 E2E Testing Agent。
-
Supabase 的資料庫排程:跟資料本身有關的例行工作,像是刪掉超過保存期限的紀錄、每晚替商品產生搜尋用的向量(embedding)。需要網站處理的,就定時呼叫網站的 API。
-
GitHub Actions:不屬於網站本身的工作,像是每天清晨把前一天的花費整理成報告貼到 Slack,以及每五天連一次 staging 的資料庫,免得免費方案因為閒置太久被暫停。
不過,排程不一定準時,各平台的規則也不太一樣(以下為 2026 年 10 月查詢的官方文件):
-
Railway:排程以 UTC 時間計算,實際執行可能差幾分鐘;程序做完要自己結束,如果上一輪還沒結束,新的一輪會直接被跳過。
-
GitHub Actions:負載高的時候,排程可能延遲。
-
Vercel:免費的 Hobby 方案一天只能跑一次,實際觸發時間可能落在設定時間之後的一小時內。
Railway「上一輪沒結束就跳過」的規則有個副作用:只要有一輪卡住,之後每一輪都會被跳過。所以 worker 要替自己設一個時限,而且要比排程的間隔短。我的資料整理 worker 每 6 小時啟動一輪,跑超過 4 小時就不再接新工作;到了 5 小時 45 分還沒結束,就取消手上的工作、直接退出,讓下一輪能正常啟動。
Staging 和 GitHub Actions:上線前的兩道關卡
新程式不會直接上線。我的網站有兩套環境:正式環境,以及正式上線前用來測試的 staging。staging 有自己的 Railway 環境、自己的 Supabase 專案和自己的程式分支,資料庫和金鑰都跟正式環境分開。如果只是換了一個網址,背後還連著正式的資料庫,測試時一樣可能改到正式資料。資料庫排程也只在正式環境執行,staging 上全部關閉。
從寫好程式到上線,會經過這幾步:
-
新功能先合併到 staging:每個 PR 都由 GitHub Actions 跑一輪檢查,確認程式碼品質、能不能成功建置;有改到資料庫結構時,還會比對 staging 的資料庫和程式裡的定義是否一致。同一個 PR 推了新的修改,還沒跑完的舊檢查就直接取消,省下執行時間。
-
再從 staging 合併到正式版:這個 PR 有兩道自動關卡:只接受來自 staging 的合併;而且要等 staging 上跑的確實是這次要合併的版本,再對它跑完整的 E2E 測試,桌機和手機都要通過。
-
最後由我核准:自動關卡都通過之後,還要經過我核准,才會部署到正式環境。




 iThome鐵人賽
 看影片追技術