

30 天前,我在 Day 01 寫下開始這個系列的原因:身為資料科學家,我想用一個真的 Side Project 補上 AI Agents 這一塊,同時藉著每天寫一篇,強迫自己把學到的東西重新整理一次。
最後一篇,我想沿著這 30 天走過的路回頭看一次:每一段遇到了什麼問題、做了哪些決定,以及哪些事該交給模型,哪些事應該留在寫好的程式裡。
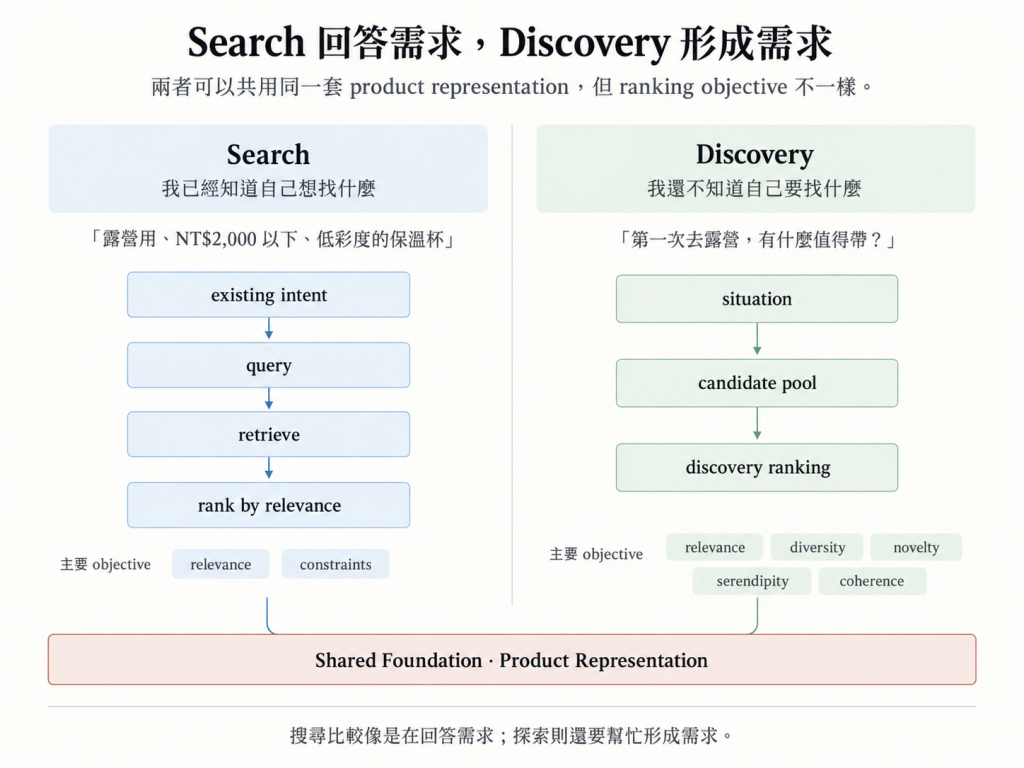
一開始,我沒有急著挑模型或框架,而是先把「讓小品牌被找到」拆成三個問題:資料要怎麼進得來、知道自己要找什麼的使用者怎麼搜尋、還說不出需求的使用者又怎麼探索。搜尋是在回答需求,探索則還要幫忙形成需求,但兩者都建立在同一份整理好的商品資料上。這個拆法也決定了之後的順序:先有資料,才有搜尋和探索。
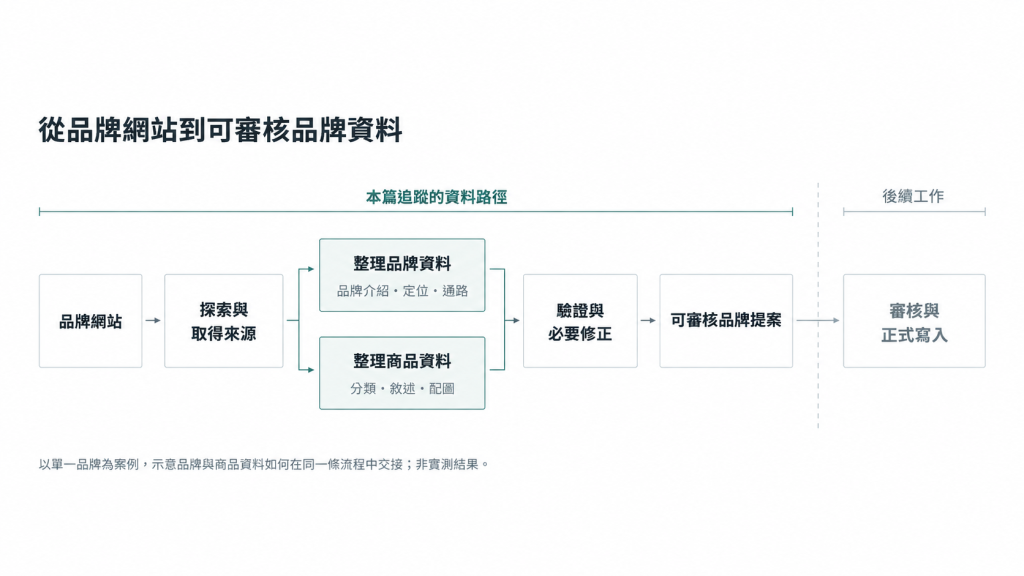
資料是整個系列花最多篇幅的一段。品牌和商品的資訊散落在不同網站上,格式各不相同,所以第一步是先定義結構:用 taxonomy 決定商品要分成哪些類別,用 Structured Outputs 把模型的輸出固定成程式接得住的格式。流程本身則拆成幾個模組:路徑已知的步驟交給一般的程式或固定的 workflow,只有需要依照當下資訊決定下一步的地方,才交給 Agent。
格式對了,也不代表資料能用。分類、商品敘述和配圖各有不同的做法和取捨,每一種都需要評估:先固定一份測試資料和評分方式,改了提示詞或換了模型之後,才知道結果是不是真的變好。最後,我把整條流程從一個品牌網站一路走到可審核的資料,確認每一段都接得起來。
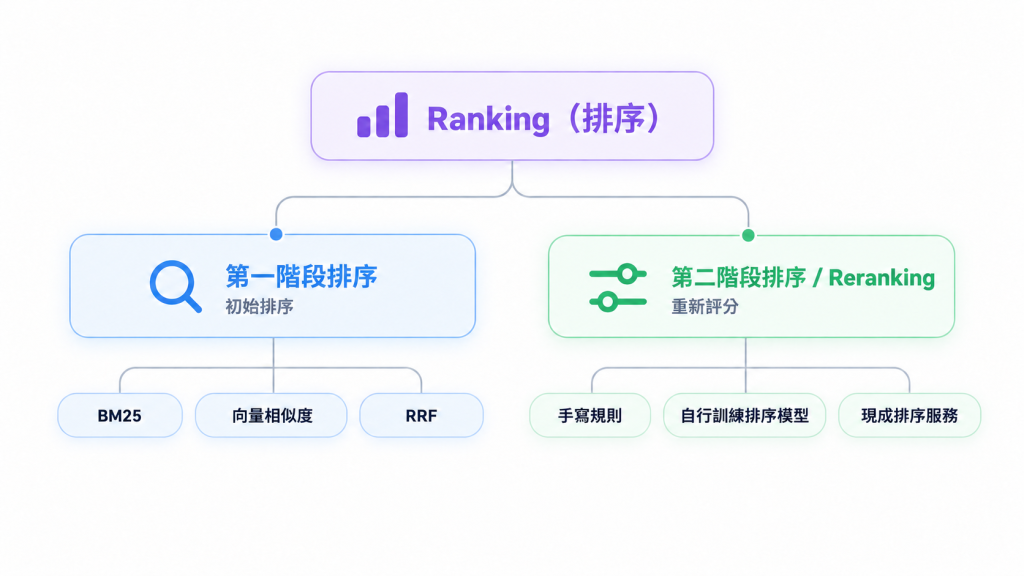
有了資料,接下來是讓使用者找得到。使用者輸入一句自然語言,系統要保留語意,也要整理出分類和材質這些條件;找候選時,向量檢索和關鍵字檢索各有擅長的地方,所以兩條路一起跑再合併;找回候選之後,再決定誰排在前面。排序這段我試過自己訓練排序模型,第一版的數字確實比較好,但重新評估之後,差距已經小到分不出來,最後決定先不換。
不是每個人都說得清楚自己想要什麼,所以除了搜尋,我也做了情境選物文章、商品照片牆和推薦,讓不同階段的使用者都有入口。搜尋上線之後,還要把使用者卡住的地方記錄下來、接回改進;資料更新之後,也要確認搜尋跟得上。
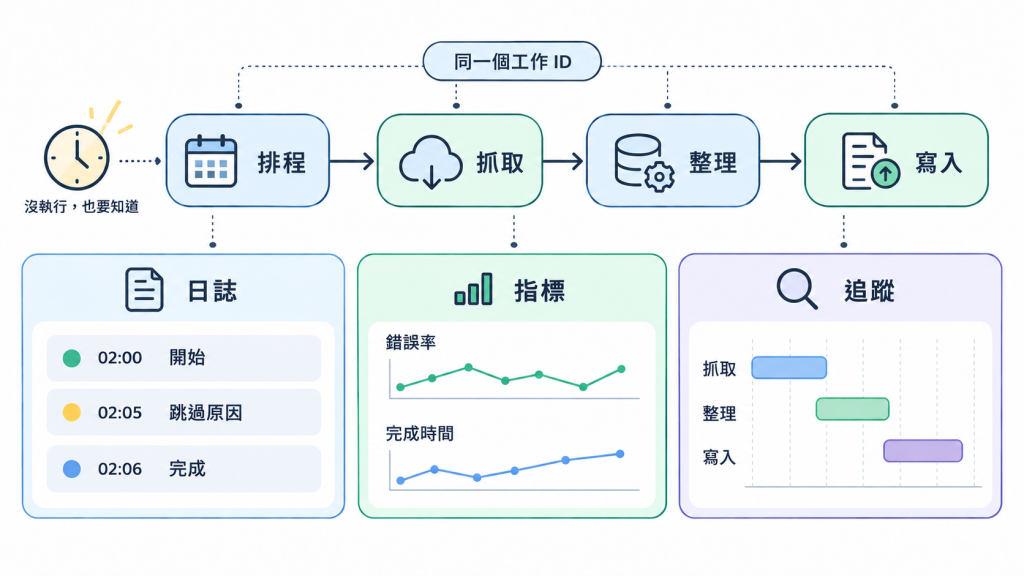
功能做出來,離能拿給別人用還有一段距離。上線前後,我補上了這幾件事:
最後幾篇,我把系列一開始想學的 Agent 放進了日常營運。Editorial Agent 從一個題目開始,自己查資料、挑商品、寫出選物文章的初稿,定方向和最後拍板留給我;Ops Agent 待在 Slack 裡,讓我不用打開電腦就能查資料、重跑工作;Health Agent 和 E2E Testing Agent 每天主動把網站巡一遍,把發現的問題送回來給我判斷。這些服務背後,是一套依照使用頻率安排的基礎架構:有的用排程啟動、做完就結束,有的閒置時休眠、用到才喚醒。
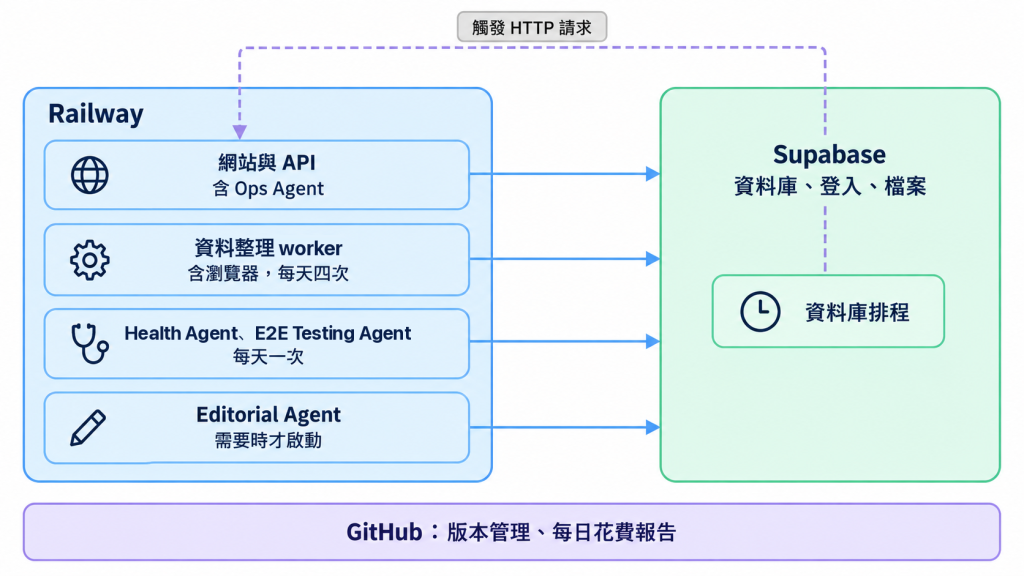
這些 Agent 都只負責真正需要判斷的部分,其他步驟仍然交給寫好的程式。需要判斷的地方才交給模型,系統比較好預測,出了問題也比較好查。這也是我對 Day 01 那個問題「AI Agent 應該負責哪些 decision?」目前最直接的答案。
走完這 30 天,我發現「做完」有三種意思,各自回答不同的問題:
三種證據可以互相支持,但不能互相取代:程式跑得起來,不代表比原本的做法好;數字進步了,也不代表使用者真的因此找到想要的東西。寫到最後,前兩種證據我累積了不少,最缺的還是第三種,所以產品接下來的第一步,是先找人帶著真實的需求試用一輪。
如果你也在用 AI 做產品,可以拿最近完成的一個功能,問自己三個問題:它真的跑得起來嗎?在固定的測試案例下,有沒有跟原本的做法比較過?有沒有人真的用它完成想做的事?答不出來的那一題,通常就是下一步該補的地方。
30 天的鐵人賽就到這裡,謝謝一路讀到最後的你,我們後會有期!


 iThome鐵人賽
 看影片追技術