一個人經營網站,每天都有一堆零碎的小事:某個品牌的資料整理失敗了要重跑、想知道這週新增了幾件商品、上線前想再跑一次測試,或是想手動跑一個 Workflow。這些事都不難,麻煩在於每次都得打開電腦、登入後台、查資料庫,電腦不在手邊的時候,往往只能先記著,之後再做。現在我只要在 Slack 上 @ Ops Agent 說一句話,就能遠端請它執行特定的任務,上一篇的 Editorial Agent 也是這樣叫起來的。這是怎麼做到的?這一篇就來好好聊聊 Ops Agent。
Claude Tag:在 Slack 裡直接叫 Claude 做事
Anthropic 在 2026 年 6 月推出了 Claude Tag:在 Slack 頻道裡 @Claude 交代一件事,它會在雲端開一個工作環境動手處理,邊做邊在討論串裡更新進度,做完再把結果貼回討論串。
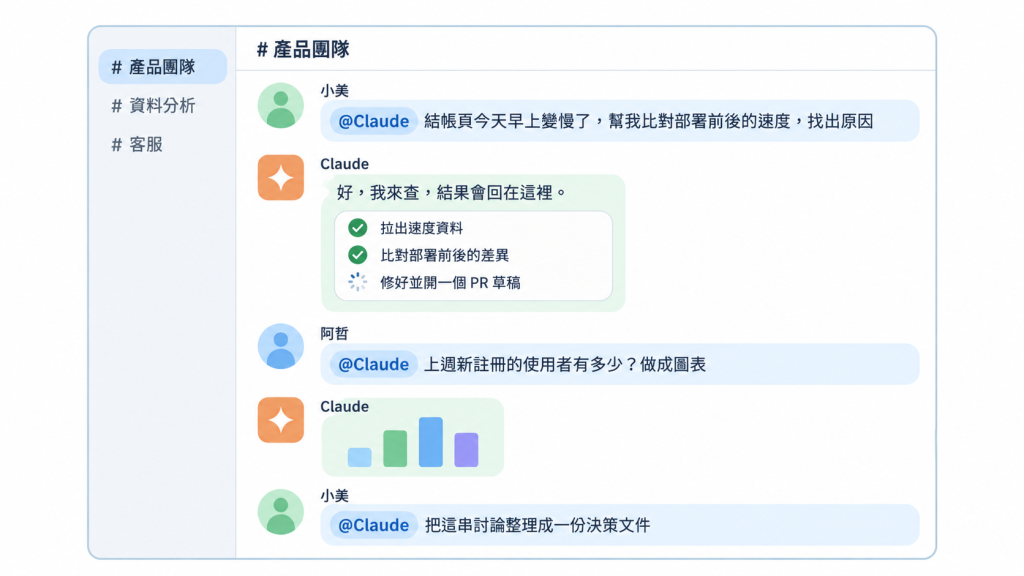
官方的使用情境頁面列了很多例子:查問題、撈數據、把一串討論寫成文件,甚至修好錯誤、開一個 PR(Pull Request,把程式修改送給人審核、決定要不要合併的申請),都能直接在頻道裡請 Claude 處理。可惜 Claude Tag 只開放給 Team 和 Enterprise 這兩種團隊方案,一人團隊常用的 Pro 和 Max 方案都不包含這個功能。於是我開始想:能不能自己做一個簡化版,達到差不多的效果?這就是這篇的主角 Ops Agent。
自己做一個 Slack 裡的 Agent,要從哪裡開始?
動手之前,先想清楚使用情境:什麼樣的事適合交給 Ops Agent?我自己最常用的有這幾種:
-
查資料:系統正不正常、某個品牌的資料長什麼樣子、最近出了哪些錯誤,問一句就有答案,不用登入後台一頁一頁翻。
-
重跑失敗的工作:某個品牌的資料整理跑到一半失敗了,可以請它從頭再跑一次,或從失敗的地方接著跑。
-
手動跑一個 Workflow:Workflow 是一段事先寫好的自動化流程。像是上線前想再跑一次 E2E 測試(用程式模擬使用者走過網站,確認功能正常),說一聲就能開始。
-
啟動另一個 Agent:例如請上一篇的 Editorial Agent 開始寫一篇新文章。
-
追查和修正問題:某個錯誤一直出現,想知道原因或直接修好,就交給 Claude Code(Anthropic 的 AI 寫程式工具)去調查、改程式。
-
隨手開 ticket:在外面想到一個 bug 或待辦事項,直接在 Slack 說一聲,就能在 Linear(我用來管理待辦的專案管理工具)開好一張 ticket,不用擔心回到電腦前就忘了。
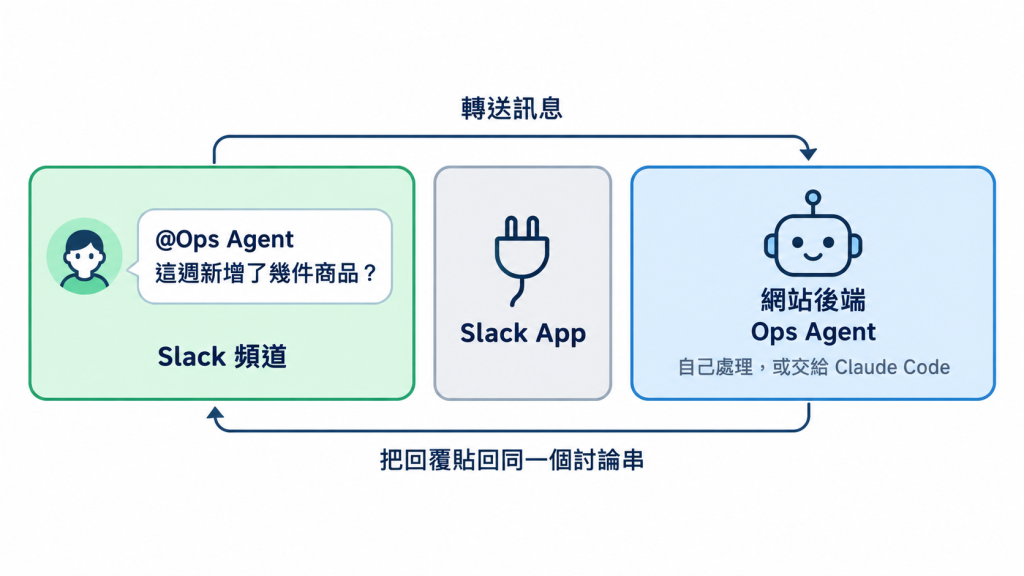
Ops Agent 的運作流程是這樣的:我在 Slack 頻道裡 @ 它交代一件事,Slack 會透過一個自己建立的 Slack App,把這則訊息轉給網站的後端;Ops Agent 在後端判斷要自己用工具處理,還是交給 Claude Code,做完再把結果回覆在同一個討論串裡。
實際的設定細節之後有機會再另外寫一篇;這裡先講大方向,設定步驟大致如下:
- 在 Slack 的開發者後台建立一個 App,開好它需要的權限:讀取有人 @ 它的訊息、在頻道裡發訊息、加表情回應和上傳檔案。
- 打開事件訂閱(Event Subscriptions),填入網站後端專門接收 Slack 訊息的 API 網址。之後只要有人在頻道裡 @ 它,或在它參與的討論串裡回覆,Slack 就會把訊息送到這個網址。
- 打開互動功能(Interactivity),再填一個網址。Ops Agent 送出的訊息如果帶有按鈕(例如執行操作前送出的確認卡片),按鈕被按下時,Slack 會把是誰按了哪個按鈕送到這裡。
- 把 App 安裝到工作區,準備好兩組金鑰:後端用來發訊息的 Bot Token,以及用來確認訊息真的來自 Slack 的簽章密鑰(Signing Secret)。兩組都只存在後端的環境變數裡,前面資安那篇談過原因。
- 把 App 邀請進指定的頻道,再在後端設好哪些人可以使用它。
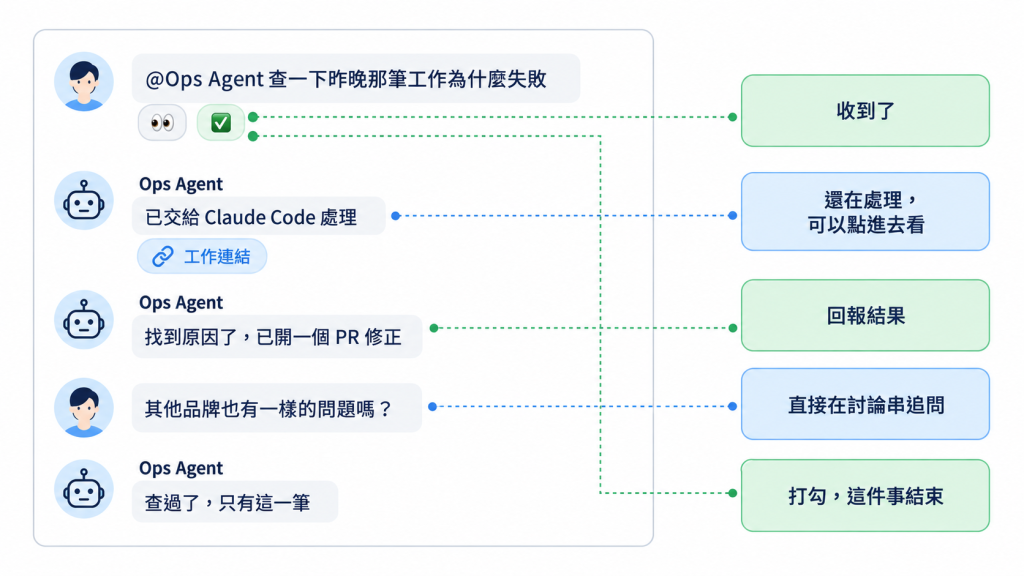
接上 Slack 後在實際執行時我遇到了一個問題:交給雲端的工作常常要跑上好幾分鐘,我需要知道它是不是還在做;結果出來之後,也希望能接著追問,而不是每次都從頭交代一遍。因此我設計了以下幾個細節:
- 當 Ops Agent 收到訊息時,會先在我的訊息上加一個表情,讓我知道它收到了、已經開始處理。
- 工作如果交給了 Claude Code,它會貼上工作連結,我隨時可以點進去看進度,做完之後,結果也會回到同一個討論串。
- 想追問的時候,直接在同一個討論串裡回覆就好,不用再 @ 它一次,它會讀前面的對話,知道我在問什麼。
整個過程看起來像這樣:
Ops Agent 什麼事自己做,什麼事交給 Claude Code?
Ops Agent 用的是一個又小又便宜的模型,複雜的工作則交給 Claude Code。這樣分工有三個原因:
-
小模型的處理速度快:日常透過 Ops Agent 處理的問題大多很單純,例如系統是否正常運行、商品的資訊是否有誤等,小模型很快就能答完。在 Slack 裡問問題,回得快比答得深更重要;需要深入研究的工作,則交給 Claude Code。
-
複雜的工作有更適合的環境:追查錯誤原因、修改程式這類工作,需要讀大量程式碼、處理複雜的邏輯,交給能力更強的模型比較適合。我用的是 Claude Code 的 Routine 功能:事先設定好一個在雲端執行的任務,Ops Agent 只要寫清楚要做什麼,就能把它叫起來。Ops Agent 自己不做這些事,也就不需要握著一大堆金鑰和 API 權限,萬一金鑰外洩,影響的範圍也比較小。
-
訂閱方案比 API 按次計費便宜:Ops Agent 每呼叫一次模型,都要付一次 API 的費用;交給 Claude Code Routine 的工作,用的則是我本來就有的 Claude 訂閱方案。
Ops Agent 自己能做哪些事,取決於我給它哪些工具(Tools)。我只給了它幾樣:查系統狀態、查品牌和工作紀錄、用唯讀的方式查資料庫、看最近的錯誤紀錄,再加上兩個特別的工具:一個用來提出需要確認的操作,一個用來把複雜的工作交給 Claude Code。
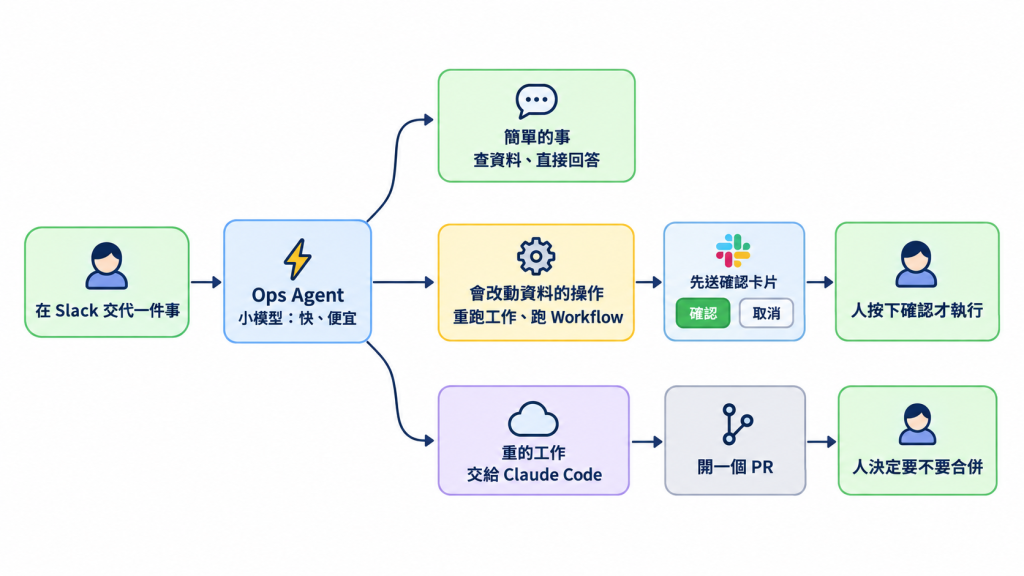
最終 Ops Agent 會有三種不同的結果:
-
直接回答:查到結果就回在討論串裡。
-
執行操作:重跑工作、跑一個 Workflow、啟動 Editorial Agent 這類會動到資料或啟動工作的事,執行前會先送出一張確認卡片,寫清楚要做什麼、對哪個品牌或哪筆工作,等我按下確認才會執行,也就是上一篇談過的 Human-in-the-loop。
-
交給 Claude Code:叫起一個 Routine,在討論串裡貼上工作連結。
整個分工是這樣:
沒有人開口的時候,誰來發現問題?
Ops Agent 再方便,也要等我開口才會動。可是很多問題根本不會有人主動提起:某個品牌的資料悄悄過期了、網站上的某個按鈕壞了、半夜跑的工作失敗了,常常要等到有人抱怨才發現。
下一篇的 Health Agent,會每天主動替網站做一次健康檢查,巡過一遍資料、跑一輪 E2E 測試;找到的問題,再透過 Ops Agent 交給 Claude Code 去修。


 iThome鐵人賽
 看影片追技術