
Day 22 把圖存進了記憶體,接下來要在圖裡「逛一圈」:從某個頂點出發,沿著邊走,把走得到的頂點一個一個拜訪(visit,也就是讀取或印出它)。這件事稱為圖的追蹤,也常稱為走訪。Day 22 留下的兩個問題,圖是否連通、時間要花多少,也要靠它來回答。
樹的走訪(Day 15)從根節點出發,一定走得完整棵樹,也不會繞回來。圖就沒這麼單純:
所以圖的追蹤要多做一件事:記錄哪些頂點已經拜訪過,有時還要換個起點重來。今天介紹兩種常用的方法:深度優先搜尋(DFS)和廣度優先搜尋(BFS)。n 代表頂點數,e 代表邊數。沒有特別註明時,圖是無向圖,用 Day 22 的相鄰串列存放,相鄰頂點由小到大排列。
下面這張圖有 5 個頂點、7 條邊,頂點 1、2、3 之間繞成一個環。兩種方法都從頂點 1 出發,相鄰頂點由小到大,橘線是追蹤時用來首次發現新頂點的邊;灰線仍會被檢查,但不會帶來新頂點:
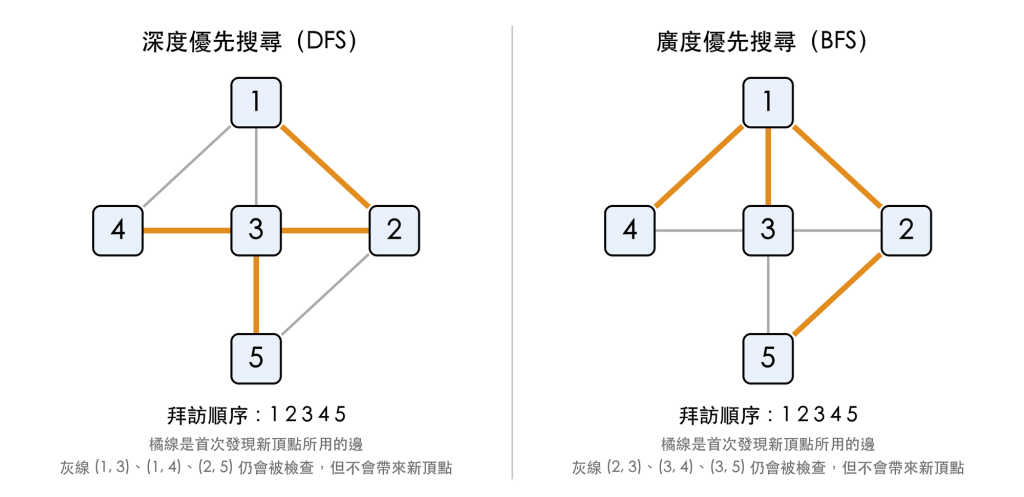
從 1 出發,DFS 和 BFS 的拜訪順序恰好都是 1 2 3 4 5,但首次發現新頂點所用的邊不一樣:DFS 用了 (1, 2)、(2, 3)、(3, 4)、(3, 5),BFS 用了 (1, 2)、(1, 3)、(1, 4)、(2, 5)。順序相同,只是這張圖加上「由小到大」的排法碰巧如此,換個起點就不一樣了,後面會看到。下面一步一步看這兩條路是怎麼走出來的。
做法很簡單:準備一個長度為 n 的陣列,記錄每個頂點是否已被發現,一開始全部是「否」。第一次發現一個頂點,就改成「是」;檢查相鄰頂點時,已經是「是」的就不再重複安排。這樣每個頂點只會拜訪一次,也不會在環裡繞圈。
這個標記常稱為「已拜訪」標記,但標記與實際處理頂點的時機可以不同:DFS 走到新頂點時就標記並拜訪;BFS 則在加入佇列時就先標記,表示它已被發現、正在等待處理。本文把 BFS 從佇列取出時的處理稱為「拜訪」。
深度優先搜尋(depth-first search, DFS)的規則是:
「退回上一個頂點」需要記得自己是從哪裡來的,這就要靠堆疊(後進先出):走到新頂點就 push,退回就 pop,堆疊頂端永遠是現在所在的頂點。
| 步驟 | 動作 | 堆疊(底 → 頂) | 已拜訪的順序 |
|---|---|---|---|
| 1 | 從 1 出發 | 1 | 1 |
| 2 | 1 的相鄰頂點 2、3、4 都還沒拜訪,由小到大,先走 2 | 1 2 | 1 2 |
| 3 | 2 的相鄰頂點 1 已拜訪,3、5 還沒拜訪,先走較小的 3 | 1 2 3 | 1 2 3 |
| 4 | 3 的相鄰頂點 1、2 已拜訪,4、5 還沒拜訪,先走較小的 4 | 1 2 3 4 | 1 2 3 4 |
| 5 | 4 的相鄰頂點 1、3 都已拜訪,退回 3 | 1 2 3 | 1 2 3 4 |
| 6 | 3 剩下的相鄰頂點 5 還沒拜訪,走到 5 | 1 2 3 5 | 1 2 3 4 5 |
| 7 | 5 的相鄰頂點 2、3 都已拜訪,依序退回 3、2、1,它們都沒有剩下的未拜訪頂點 | (清空) | 1 2 3 4 5 |
注意步驟 4:3 的相鄰頂點裡有 1 和 2。如果沒有已拜訪標記,就會走回 1,再走 2、3,沿著 1、2、3 這個環一直繞下去。有了標記,它們就被略過了。最後退回 1 和 2 時,它們的其他相鄰頂點(3、4、5)也都早就拜訪過,所以邊 (1, 3)、(1, 4)、(2, 5) 雖然會被檢查,卻不會用來首次發現新頂點。
如果這張圖本身是一棵樹,DFS 先處理目前頂點、再往下走,其實就是 Day 15 的前序走訪。
廣度優先搜尋(breadth-first search, BFS)的規則是:
這裡用的是佇列(先進先出):先被發現的頂點先排隊,也先被拜訪。所以離起點一條邊的 2、3、4 會先拜訪,接著才輪到離起點兩條邊的 5,看起來就是一圈一圈往外擴。
| 步驟 | 取出(拜訪) | 加入佇列的相鄰頂點 | 佇列(前 → 後) | 已拜訪的順序 |
|---|---|---|---|---|
| 1 | 起點 1 先放進佇列 | — | 1 | — |
| 2 | 1 | 2、3、4 | 2 3 4 | 1 |
| 3 | 2 | 5(1、3 已標記) | 3 4 5 | 1 2 |
| 4 | 3 | 無(1、2、4、5 已標記) | 4 5 | 1 2 3 |
| 5 | 4 | 無(1、3 已標記) | 5 | 1 2 3 4 |
| 6 | 5 | 無(2、3 已標記) | (空) | 1 2 3 4 5 |
步驟 3 很關鍵:2 的相鄰頂點 3,在步驟 2 就已經被 1 加進佇列了,所以不會再加一次,邊 (2, 3) 雖然被檢查,卻不會用來首次發現新頂點。這也是為什麼要在加入佇列時就標記,而不是等到取出才標記;不然 3 會被加入佇列兩次。
| 比較項目 | DFS | BFS |
|---|---|---|
| 做法 | 一路追到底,沒路了再退回 | 先拜訪離起點近的,一圈一圈往外 |
| 用的資料結構 | 堆疊(遞迴時是呼叫堆疊) | 佇列 |
| 從 1 出發的拜訪順序 | 1 2 3 4 5 | 1 2 3 4 5 |
| 從 1 出發首次發現新頂點所用的邊 | (1, 2)、(2, 3)、(3, 4)、(3, 5) | (1, 2)、(1, 3)、(1, 4)、(2, 5) |
| 改從 4 出發的拜訪順序 | 4 1 2 3 5 | 4 1 3 2 5 |
從 1 出發時兩種順序相同,換成從 4 出發就不同了:DFS 從 4 先走到 1,再一路往深處走到 2、3、5;BFS 則是先拜訪 4 的相鄰頂點 1、3,再往外一圈拜訪 2 和 5。
前幾天說過,無向圖中任意兩個頂點之間都有路徑,才是連通圖。用追蹤來判斷很直接:從任一頂點出發追蹤一次,如果拜訪到的頂點數剛好是 n,就是連通圖;少於 n,代表有頂點走不到,不連通。
回到 Day 21、22 的那張 6 個頂點的圖。從 A 出發追蹤,只會拜訪 A、B、C、D,E 和 F 沒有被標記,所以這張圖不連通。接著挑一個還沒拜訪的頂點 E 重新出發,拜訪 E、F,就找到了第二個連通元件:
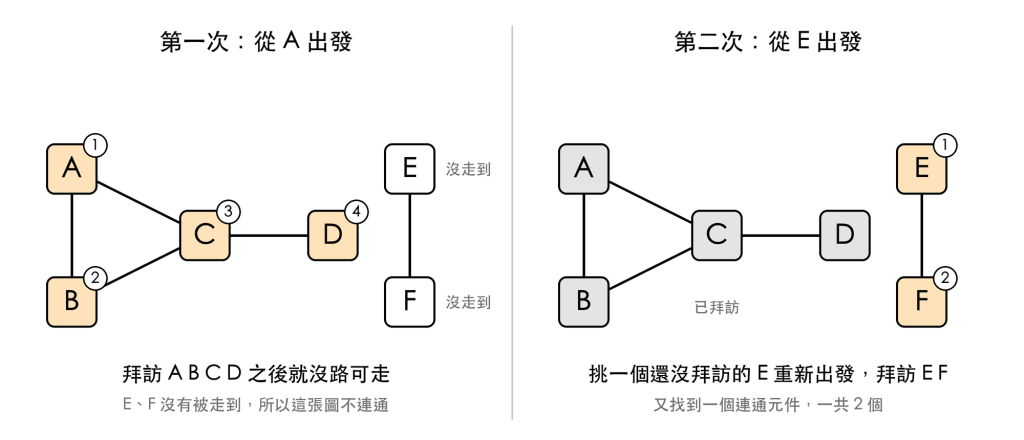
這樣一直重複,直到每個頂點都被標記為止。每從一個尚未拜訪的頂點開始追蹤,就找到一個連通元件;開始追蹤的總次數(包含第一次出發)就是連通元件的個數。這張圖從 A、E 各出發一次,共有 2 個連通元件。這裡用 DFS 或 BFS 都可以,結果一樣。
因為有已拜訪標記,每個頂點只會拜訪一次。接下來要看的,是怎麼找到相鄰頂點,這正是 Day 22 比較過的差別:
判斷連通、數連通元件也是一樣:每個頂點仍然只拜訪一次,頂多再多掃一遍標記陣列(O(n)),所以用相鄰串列是 O(n + e),用相鄰矩陣是 O(n²),正好呼應 Day 22 的結論。
額外空間(不含圖本身)也一樣:標記陣列是 O(n),堆疊或佇列最多同時放 n 個頂點,也是 O(n),所以額外空間是 O(n)。
圖的追蹤是從起點出發,把走得到的頂點各拜訪一次。因為圖可能有環、也可能不連通,所以要用已拜訪標記,必要時換起點重來。DFS 一路追到底再退回來,靠堆疊記住來時的路;BFS 先拜訪離起點近的頂點,靠佇列一圈一圈往外擴。從任一頂點追蹤一次,就能判斷圖是否連通,從尚未拜訪的頂點開始追蹤的總次數(包含第一次出發)就是連通元件的個數。
今日重點:
到目前為止,圖上的邊只有「有」或「沒有」。但現實中的路有遠有近:捷運站之間的車程、水管的長度、網路線的成本,每一條都不一樣。下一篇要讓每條邊帶上一個數字,來解決兩個很實際的問題:怎麼用最少的成本把所有地方連起來最小成本生成樹,還有從 A 到 B 該走哪條路最近最短路徑。


 iThome鐵人賽
 看影片追技術