
圖上的邊除了表示兩個頂點相連,還可以帶著一個數字,稱為權重(weight)。權重可以是造價、距離、時間或費用,帶有權重的圖就是加權圖(weighted graph)。
用同一張加權圖,可以回答兩個問題。假設圖上的 6 個頂點是 6 間機房,邊是可以拉網路線的路徑,數字是每條線的造價:
數字也可以代表路程或延遲。以下範例使用連通的無向圖,權重互不相同,也沒有負數。n 代表頂點數,e 代表邊數。
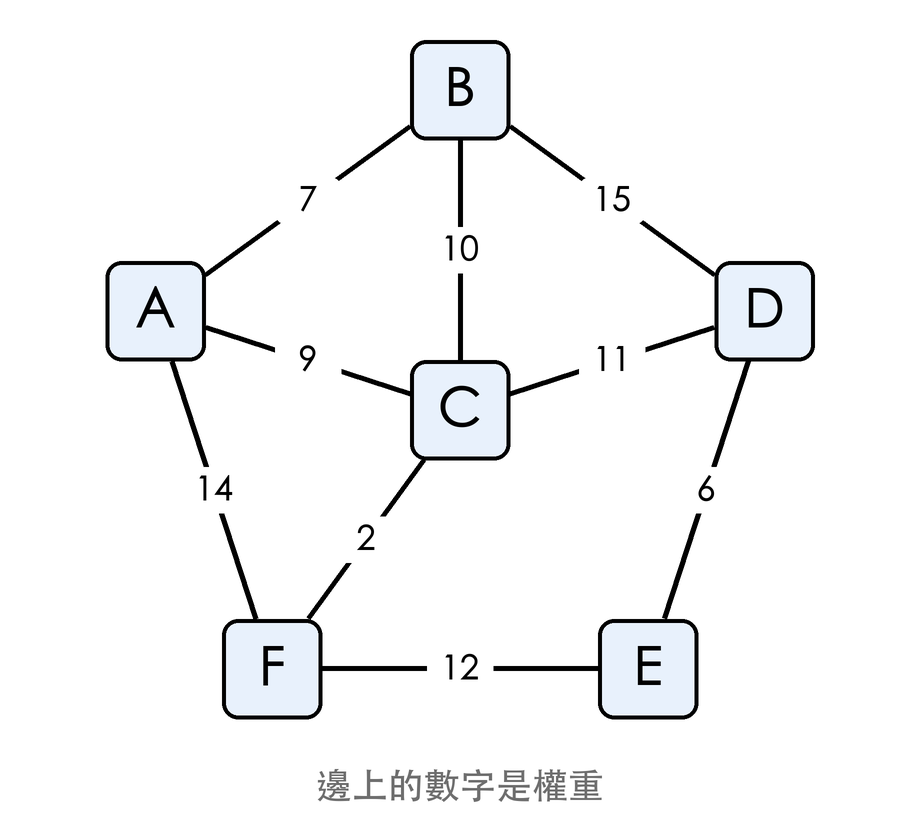
相鄰矩陣原本用 1 表示有邊,加上權重後,格子改放權重。沒有邊的格子放 ∞,避免把 0 誤當成最便宜的邊(實際寫程式時,用一個夠大的數代替);對角線放 0,表示自己到自己不用花成本。相鄰串列的每個節點,除了記相鄰頂點,再多記一個權重。
生成樹是連通圖的一個子圖:它包含全部 n 個頂點,而且本身是一棵樹,所以剛好有 n − 1 條邊。
一張圖可以有很多棵生成樹。在加權圖裡,邊的權重總和最小的那一棵,稱為最小成本生成樹。範例有 6 個頂點,要挑 5 條邊,讓總造價最小。權重互不相同時,最小成本生成樹只有一棵;權重有相同時,可能有好幾棵。
常見的做法有兩種:Prim 演算法和 Kruskal 演算法。它們選邊的過程不同,但會得到同一棵樹。
Prim 演算法的規則是:
| 步驟 | 樹內的頂點 | 候選邊 | 挑選的邊 | 累計成本 |
|---|---|---|---|---|
| 1 | A | A-B(7)、A-C(9)、A-F(14) | A-B(7) | 7 |
| 2 | A、B | A-C(9)、B-C(10)、A-F(14)、B-D(15) | A-C(9) | 16 |
| 3 | A、B、C | C-F(2)、C-D(11)、A-F(14)、B-D(15) | C-F(2) | 18 |
| 4 | A、B、C、F | C-D(11)、E-F(12)、B-D(15) | C-D(11) | 29 |
| 5 | A、B、C、D、F | D-E(6)、E-F(12) | D-E(6) | 35 |
要注意步驟 4:A-F(14) 已經不在候選邊裡了,因為 A 和 F 都在樹內,再加這條邊會形成環(A、C、F 繞成一圈)。每一步只看「一端在樹內、一端在樹外」的邊,就不會形成環。
Kruskal 演算法的規則是:
這裡的連通元件,指的是目前已經選出的邊所形成的:一開始還沒選任何邊,每個頂點各自是一個連通元件;每加入一條邊,就把兩個連通元件接在一起。
排好的邊依序是:C-F(2)、D-E(6)、A-B(7)、A-C(9)、B-C(10)、C-D(11)、E-F(12)、A-F(14)、B-D(15)。
| 步驟 | 檢查的邊 | 兩端是否在同一個連通元件 | 結果 | 加入後的連通元件 |
|---|---|---|---|---|
| 1 | C-F(2) | 否 | 加入 | {C, F}、{A}、{B}、{D}、{E} |
| 2 | D-E(6) | 否 | 加入 | {C, F}、{D, E}、{A}、{B} |
| 3 | A-B(7) | 否 | 加入 | {C, F}、{D, E}、{A, B} |
| 4 | A-C(9) | 否 | 加入 | {A, B, C, F}、{D, E} |
| 5 | B-C(10) | 是,都在 {A, B, C, F} | 跳過(會形成環 A、B、C) | 不變 |
| 6 | C-D(11) | 否 | 加入 | {A, B, C, D, E, F} |
步驟 6 之後已經選了 5 條邊,也就是 n − 1 條,所以結束,後面的 E-F(12)、A-F(14)、B-D(15) 不用再看。總成本是 2 + 6 + 7 + 9 + 11 = 35。
Prim 的選邊順序是 A-B、A-C、C-F、C-D、D-E,Kruskal 是 C-F、D-E、A-B、A-C、C-D,順序完全不同,但選出來的 5 條邊一模一樣,總成本都是 35。
Kruskal 若能有效率地判斷與合併連通元件,主要時間花在排序 e 條邊,總時間是 O(e log e)。
Prim 要做 n − 1 輪。用相鄰矩陣時,替每個樹外頂點記錄「目前接到樹的最小邊權重」,每輪掃一遍挑出最小的,再用剛加入的頂點那一列更新紀錄,每輪花 O(n),總時間是 O(n²)。如果用相鄰串列,再用最小累堆(樹根存放最小值)挑出最小者,可以達到 O(e log n)。
加權圖裡,一條路徑的長度是路徑上所有邊的權重總和。未加權圖用邊數計算路徑長度,相當於每條邊的權重都是 1,這時用廣度優先搜尋(BFS,一層一層往外拜訪頂點)就能找到最短路徑。
最短路徑問題是:給定一個起點(例如 A),求它到其他每個頂點的最短路徑。Dijkstra 演算法的規則是:
下表每一列是挑出一個頂點後,各頂點目前的距離(A 的距離一直是 0,所以省略):
| 步驟 | 挑出(確定)的頂點 | B | C | D | E | F | 這一步更新了什麼 |
|---|---|---|---|---|---|---|---|
| 0 | 起點 A,距離 0 | ∞ | ∞ | ∞ | ∞ | ∞ | 還沒開始 |
| 1 | A | 7 | 9 | ∞ | ∞ | 14 | B、C、F 從 ∞ 改成 7、9、14 |
| 2 | B | 7 | 9 | 22 | ∞ | 14 | D 從 ∞ 改成 22;經 B 到 C 是 17,不比 9 好 |
| 3 | C | 7 | 9 | 20 | ∞ | 11 | D 從 22 改成 20;F 從 14 改成 11(A→C→F = 9 + 2) |
| 4 | F | 7 | 9 | 20 | 23 | 11 | E 從 ∞ 改成 23(11 + 12) |
| 5 | D | 7 | 9 | 20 | 23 | 11 | 經 D 到 E 是 26,不比 23 好,沒有更新 |
| 6 | E | 7 | 9 | 20 | 23 | 11 | 全部確定,結束 |
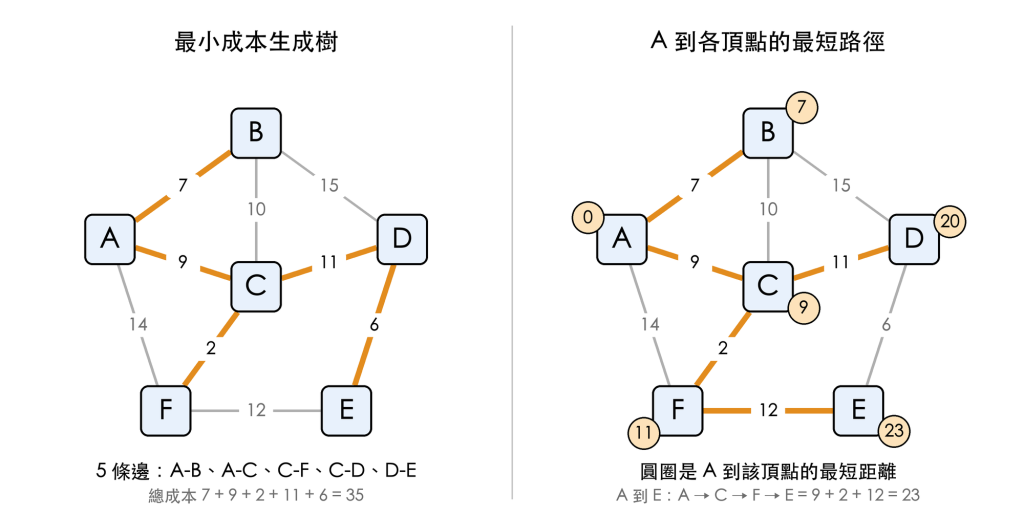
A 到 B、C、D、E、F 的最短距離,依序是 7、9、20、23、11。要知道實際怎麼走,就順著「前一個頂點」往回找:E 的前一個頂點是 F,F 的前一個是 C,C 的前一個是 A,所以最短路徑是 A → C → F → E,長度 9 + 2 + 12 = 23。如果直接走 A → F → E,長度是 14 + 12 = 26,反而比較遠。
為什麼每次挑目前距離最小的頂點,就能把它確定?因為其他還沒確定的頂點,目前距離都不小於它;在權重不是負數的前提下,經由那些頂點繞過來,也不會得到更短的路徑,所以它的距離不會再變小。如果有負權重,這個推論就不成立,所以 Dijkstra 演算法只能用在沒有負權重的圖。
時間方面,每次用陣列掃描找距離最小的頂點要 O(n),最多做 n 次;加上更新相鄰頂點的距離,用相鄰矩陣時總時間是 O(n²)。如果用相鄰串列加上累堆來挑最小的,可以降到 O(e log n)。
同一張圖,兩個問題的答案並不一樣:
| 比較項目 | 最小成本生成樹 | 最短路徑(Dijkstra,起點 A) |
|---|---|---|
| 想知道什麼 | 用最少的總成本,把所有頂點連起來 | 從起點到每個頂點的距離都最短 |
| 用到的邊 | A-B、A-C、C-F、C-D、D-E | A-B、A-C、C-F、C-D、E-F |
| 邊的權重總和 | 35 | 41 |
| A 到 E | 在樹上要走 A-C-D-E,共 26 | 最短是 A-C-F-E,共 23 |
兩棵樹只差一條邊:最小成本生成樹用便宜的 D-E(6),最短路徑卻用 E-F(12)。生成樹在乎的是整體最省,所以選 D-E;最短路徑只在乎從 A 出發的距離,到 E 走 F 比較近。所以最小成本生成樹上兩個頂點之間的路,不一定是最短路徑。
Prim 和 Dijkstra 的過程很像:都是每次從還沒加入的頂點中,挑一個「最好」的,再往外長。差別在「最好」的標準:Prim 看的是連到現有那棵樹的單一邊權重,Dijkstra 看的是從起點走過來的總距離。
加權圖的邊帶著權重,相鄰矩陣的格子改放權重(沒有邊放 ∞),相鄰串列的節點多記一個權重。最小成本生成樹,是用最少的總權重把所有頂點連起來的那棵生成樹:Prim 從一個頂點長大,每次挑一端在樹內、一端在樹外的最小邊;Kruskal 把邊由小到大檢查,兩端已在同一個連通元件的就跳過,兩者會得到同一棵樹。最短路徑則是求起點到每個頂點的最短距離:Dijkstra 每次確定距離最小的頂點,再用它去更新相鄰頂點的距離。兩個問題要的東西不同,答案也可能不同。
今日重點:
下一篇開始介紹排序:一副亂序的撲克牌,你會怎麼把它排好?電腦也有不同的排序方法,我們會比較它們的做法與執行時間。


 iThome鐵人賽
 看影片追技術