
Day 05 給單兵 Agent 掛了記憶,Session ID 設成 thread_id。拆成一位主管加三位專員之後,問題變成:這個記憶元件該掛在誰身上。
直覺上「每個 Agent 都給記憶」聽起來最保險。我把兩種接法都做出來跑了一遍,結論是接在專員身上完全沒有好處,而接在主管身上的好處比我以為的小很多,原因今天會講清楚。
同一組記憶元件接在不同位置,實測的差別如下圖。
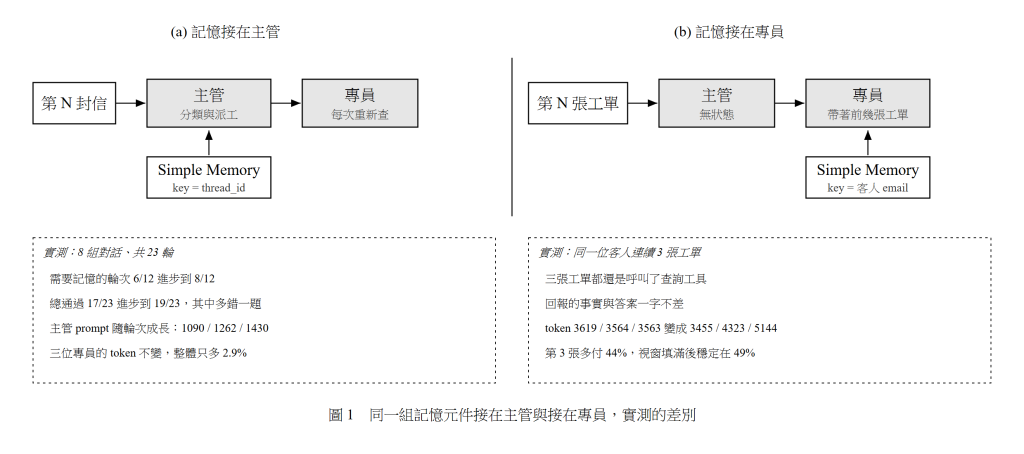
這是整天的關鍵,我到做完實驗才真正想通。
n8n 的 Simple Memory 掛在 Agent 的 ai_memory 插槽上。它存的是這個 Agent 自己的輸入訊息和輸出訊息,下次同一個 session key 進來的時候,把最近幾組插在系統提示和這次的輸入之間。
所以主管的記憶裡會有什麼?主管的輸入是來信原文,輸出是分類結果:
intent、intent_confidence、secondary_intents、needs_human、human_reason、
sentiment、clean_question、verbatim_question、extracted.order_id、questions_asked
裡面沒有 W1 查到的訂單資料,沒有 W2 找到的 FAQ 條目,也沒有 W3 最後寫出去的那封信。因為那些是主管派工之後才發生的事,不經過主管這個 Agent 的輸出。
記住這件事,後面兩個實驗的結果就全部說得通了。
W1 加一個 Simple Memory,session key 用客人的 email:
{
  "sessionIdType": "customKey",
  "sessionKey": "={{ $json.facts_known.customer_email || $json.task_id }}",
  "contextWindowLength": 5
}
測試是同一位客人連續三張工單,第三張故意問第一張已經查過的東西:
第 1 張:查出訂單 A10293 的狀態與物流單號
第 2 張:查出訂單 A10296 的狀態與物流單號
第 3 張:查出訂單 A10293 的預計到貨時間
我原本預期第三張會出事。A10293 的資料明明在記憶裡,有記憶的 W1 應該會直接從記憶抄,不去呼叫工具,但 source 還是寫 orders!A10293 看起來像真的查過。這是我覺得最危險的一種失敗,因為 Day 21 的驗收層抓不到。
沒有發生。 兩個版本的每一張工單都呼叫了 get_order_by_id:
| 無記憶 | 有記憶 | |
|---|---|---|
| 第 1 張 tokens | 3619 | 3455 |
| 第 2 張 tokens | 3564 | 4323 |
| 第 3 張 tokens | 3563 | 5144 |
| 每張的工具呼叫次數 | 1、1、1 | 1、1、1 |
| 回報的 facts 筆數 | 2、1、1 | 2、1、1 |
代理層記到的工具參數也一模一樣,第三張仍然是 get_order_by_id({"order_id":"A10293"})。兩個版本的答案連文字都幾乎相同。
為什麼沒出事?我的理解是 TaskEnvelope 每次都明確寫著要查哪一筆、要哪些欄位,W1 的 prompt 也寫死「facts 必須來自工具回傳」。模型沒有需要自己判斷「這個我是不是已經知道了」的空間。
所以記憶對 W1 的唯一效果是帳單。第三張工單多付 44%,而且這還沒到頂——我另外跑過一次記憶視窗已經填滿的狀態,三張工單分別是 5355、5394、5309,比無記憶版高 49%,之後就穩定在那裡不再成長。
換句話說,專員的記憶是一筆固定開銷,換來零個可測量的好處。 我原本準備好要寫的那個恐怖故事沒有發生,但不發生也不構成留下它的理由。
另外一個比較安靜的代價:有記憶的專員不是冪等的。同一張工單在不同時間跑,輸入相同但模型看到的訊息不同。Day 15 那份 20 題考卷是建立在「同一題丟進去會得到同樣的結果」上的,專員一旦有記憶,考卷的分數就取決於考試順序。
主管那邊掛一個 Simple Memory,session key 用 thread_id,視窗 6 組,三位專員都不掛。
測試集是 8 組多輪對話、共 23 輪,每輪標註「這一輪需不需要記得前文」。23 輪裡有 12 輪需要。
| 無記憶 | 有記憶 | |
|---|---|---|
| 總通過 | 17/23 | 19/23 |
| 需要記憶的輪次 | 6/12 | 8/12 |
| 完全沒產生草稿的輪次 | 4 | 3 |
| 主管每輪 tokens 中位數 | 1210 | 1384 |
| 全部 Agent 的 tokens 總和 | 138203 | 142212 |
淨增加兩題。成本方面,主管自己多付 14%,但因為主管只佔整條流程五分之一的 token,整體只多 2.9%。
主管的 prompt 長度確實隨輪次成長,第 1、2、3 輪分別是 1090、1262、1430;無記憶版則是 1090、1087、1088。視窗設 6 組,所以它會成長到第六輪為止。
C7 是一組保固案。第 1 輪問「磨豆機壞掉了可以保固嗎」,第 2 輪補上「訂單是 A10303,把手鬆掉轉不動」,第 3 輪問「要附哪些資料?」
第 3 輪這句話單獨看完全沒有主詞。無記憶版判成 other、轉人工、沒有草稿。有記憶版判成 return_refund,同時派了 W1 和 W2,回信寫出保固要訂單編號加故障照片、一般退貨要訂單編號加退貨原因。這一題是記憶的功勞。
C3 那一題比較有意思,值得拆開看。第 1 輪問「A10307 到哪裡了?」,第 2 輪問「那我另一筆舊的呢?」
無記憶版判成 other 轉人工。有記憶版判成 order_status,派給 W1,回信列出 A10295 已送達、A10307 已出貨,請客人確認是哪一筆。評分器要求提到 A10295 或「已送達」,所以算通過。
但是注意主管實際寫出來的 clean_question 是「詢問另一筆舊訂單的進度」——它並沒有把「另一筆舊的」解出是 A10295。真正找出 A10295 的是 W1,因為工單裡帶著 customer_email,W1 用 email 查就把這位客人的兩筆單都撈回來了。
所以記憶在這裡做的事,不是解析代詞,而是讓主管不要放棄。它知道這串信在講訂單,於是照樣派工,剩下的交給專員和「請您確認是哪一筆」這句話。這跟我原本想像的「記憶解析代詞,解析完變成明確參數傳下去」不一樣。
C8 的第 2 輪,客人說「還是沒到,已經又過兩天了」。
無記憶版判成 order_status,查到物流單號照實回覆,通過。有記憶版判成 complaint,轉人工,沒有草稿,不通過。
這是記憶造成的。主管看到的不只是這一句,還有前一輪「A10304 還沒到,可以幫我看一下嗎」,累積起來它讀成客訴。
要說這是錯誤也可以,要說它合理也可以——同一位客人連續兩次反映沒收到,轉給真人處理未必是壞事。但標準答案要求回覆物流單號,所以它就是扣一分。記憶讓主管對累積的情緒變敏感,而這個敏感是雙向的。
C1 第 3 輪「那另外那筆呢?」,兩個版本都判成 other 轉人工。
C2 第 2 輪「濾杯那筆」,兩個版本也都是 other 轉人工。
這兩題的共同點,就是開頭那件事:解這兩句話需要的資訊,從來沒有進過主管的記憶。
C1 第 1 輪的時候,「這位客人有兩筆單」是 W1 查出來的事實,寫進了寄給客人的草稿,但主管自己的輸出裡只有 intent、clean_question 那些欄位。所以第 3 輪它的記憶裡找不到任何「另外那筆」可以指向的東西。
C2 更明顯。「濾杯那筆」要靠商品名稱才能對應到訂單,而商品名稱在 W1 回報的 items 裡。主管第 1 輪的回覆草稿列的是訂單編號和狀態,連商品名稱都沒寫進去——客人看到那封信其實也不知道哪一筆是濾杯,他是看著自己的購買紀錄問的。
這兩題不是「記憶不夠多」造成的,是記憶裡本來就不會有那些內容。把視窗從 6 組加到 20 組不會有任何改變。
順帶一提,C2 第 2 輪有記憶版寫出的 clean_question 是「詢問濾杯訂單的出貨狀態」,比無記憶版的「客戶詢問關於濾杯訂單的狀況」精確,但 intent 還是 other;C3 第 2 輪幾乎一樣的情境卻判成 order_status。同樣的輸入型態給出不同的分類,這是分類那一步本來就有的抖動,不是記憶的功過。
把兩個實驗放在一起,我現在的判斷是:
記憶接在專員身上沒有好處。它不會讓專員變聰明,只會讓它變貴、變得不可重現。專員應該是一個函式,輸入決定輸出。
記憶接在主管身上有好處,但好處有一個明確的天花板:它只能幫主管讀懂那些「主管自己說過的話」就足以還原的句子。超出這個範圍的代詞,加多少記憶都沒用。
這 23 輪裡,需要記憶的 12 輪,有記憶答對 8 輪。剩下 4 輪有 2 輪就卡在這個天花板上。
要突破它,該記的不是對話,而是案件本身的狀態:這個 thread 查過哪些訂單、哪些問題還沒解決、我們承諾過什麼。那是一張可以寫進資料表的東西,也可以給人類直接看。這件事和 Day 25 的人工審批要用的東西幾乎是同一份資料,我會在那邊一起做,今天不先寫沒跑過的數字。
至於長期記憶——「這位客人是誰、買過什麼」——那本來就不是記憶插槽的事。W1 已經可以用 customer_email 查,它是一個工具,不是一段對話。C3 那一題就是靠這個撈出第二筆訂單的。
專員的記憶:三張工單,有記憶版每一張還是呼叫了查詢工具,回報的事實一字不差,只有 token 從 3563 長到 5144(第三張多 44%,視窗滿了之後穩定在 49%)。我原本擔心的「從記憶抄答案、source 卻寫得像真的」沒有發生,但它也沒有省下任何東西。
主管的記憶:23 輪多對兩題,需要記憶的輪次從 6/12 進步到 8/12,整體成本只多 2.9%。值得加。
但要知道它的極限。主管的記憶裡只有它自己的輸入和輸出,專員查到的東西從來不會回流進去,所以「那另外那筆呢」「濾杯那筆」這種要靠查詢結果才能解讀的代詞,無論記憶視窗開多大都解不了。
還有一個反方向的代價:有記憶之後,主管把連續兩輪的抱怨讀成客訴並轉人工,丟掉了一分。這個行為在真實客服裡未必是錯的,但它說明記憶會改變主管的判斷,不只是補上資訊。
明天處理東西壞掉的時候怎麼辦:工具回錯誤、模型吐出不合格式的東西、子流程逾時,保險絲該設在哪一層。


 iThome鐵人賽
 看影片追技術