
主管讀完一封信之後,會產出三種形式的同一件事:整理過的 clean_question、客人的原句 verbatim_question,以及完整的來信原文。
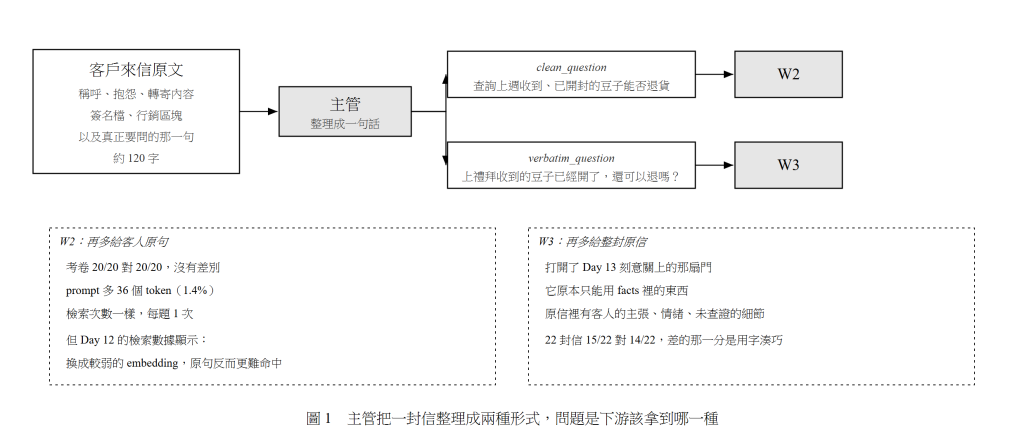
專員該拿到哪一種?下圖是這三種形式的關係。
這個問題從 Day 09 訂契約的時候就懸著。我當時選了最省的做法——只傳整理過的那一句——理由是「只傳必要的資訊」。今天把另外兩種也做出來,跑數字看看那個理由站不站得住。
結論是兩邊都沒有可測量的差別,而我追下去發現,這個「沒差別」的前提比結論本身更值得講。
W2 原本收到的是主管改寫過的問題,例如「查詢上週收到、已開封的咖啡豆是否可以退貨」。客人實際寫的是「上禮拜收到的豆子已經開了,還可以退嗎?」
改寫過的版本名詞比較完整,對檢索理論上有利。但改寫也可能漏掉關鍵字,所以我做了一個版本,兩個都給。
同一份 20 題考卷:
| 只給改寫後的問題 | 再加上客人原句 | |
|---|---|---|
| 考卷 | 20/20 | 20/20 |
| prompt tokens 中位數 | 2491 | 2527 |
| 檢索次數中位數 | 1 | 1 |
沒有任何一題的結果改變,多付 36 個 token。
不過這個結論有個前提。Day 12 量過檢索命中率,當時用的是 nomic-embed-text:
| 查詢用的句子 | 進前 4 |
|---|---|
| 改寫後的問題 | 9/15 |
| 客人原句 | 7/15 |
那時候原句明顯比較差,口語、夾雜情緒、名詞不完整。換成 bge-m3 之後兩種都是 15/15,才變成「給不給都一樣」。
所以這個實驗真正證明的是:檢索夠強的時候,多給一份原句不會造成干擾。如果檢索弱,它不只是沒幫助,還可能把查詢帶偏。
這個比較有意思,因為它牴觸 Day 13 給 W3 定的規矩:
你只能使用 facts 與 derived 陣列中提供的資訊。
你沒有任何查詢工具,你不知道 facts 以外的任何事實。
把原信交給它,等於把這扇門打開。原信裡有客人的主張(「我根本沒收到」)、情緒、以及各種沒查證過的細節。如果 W3 開始引用這些,Day 11 到 Day 14 建立的那條「事實必須有來源」的鏈就斷了。
另一方面,Day 13 最難解的那個毛病是答非所問——客人問保固,回信講到貨日期。主管的摘要如果漏掉了重點,W3 無從得知。給它原信也許能補上。
我一開始拿 Day 20、Day 21 用的那 8 封退貨信來跑,結果兩邊都是 8/8、合規違規都是 0、草稿平均字數差 4 個字,什麼都看不出來。
回頭看才發現測試集選錯了。那 8 封都是兩三句話的直球問題,像「A10298 的耶加雪菲喝起來太酸了不喜歡,已經開封了,可以退嗎?」。這種信的摘要跟原文幾乎一樣長,當然測不出差別。
要測「摘要會不會漏東西」,得用摘要和原文差很多的信。我去翻評估集,符合條件的只有一封——EV14,393 個字,開頭是「東西咧???」,後面接一整段轉寄的出貨通知信,裡面夾著行銷區塊和簽名檔。50 封信裡只有這一封真的髒。
這是評估集的問題,不是系統的問題。我在 Day 27 整理評估集時會補一批有雜訊的信。
我改用 22 封不需要轉人工的信,意圖涵蓋查單、知識、退貨,長度從 25 字到 393 字。兩個版本的差別只有 W3 有沒有拿到原信。
| 只給 facts 和摘要 | 再加上整封原信 | |
|---|---|---|
| 完整通過 | 14/22 | 15/22 |
| 部分通過 | 7 | 6 |
| 危險錯誤 | 1 | 1 |
| 合規違規總數 | 0 | 0 |
| 草稿字數中位數 | 106 | 113 |
| W3 的 prompt tokens 中位數 | 1229 | 1273 |
差一分。我去看那一題,兩個版本其實都答對了:
摘要版:…未開封且外包裝完整的咖啡豆可在到貨 7 天內申請退貨,但您的訂單已到貨 22 天。
原信版:…由於您的訂單於 2026-08-23 送達,目前已超過 7 天的退貨期限,因此無法為您辦理退貨。
評估集的判準要求出現「超過」「已過」或「已逾」,摘要版寫的是「已到貨 22 天」,意思完全一樣但字面沒中。這一分是用字湊巧,不是能力差距。
另一個旁證:兩個版本的分類結果有一題不同,但分類那一步兩邊用的是同一個 prompt、同一個模型,輸入也一模一樣。同樣的設定跑兩次就會有一題跳動,這就是單輪、小樣本的雜訊水準。一分的差距落在這個範圍內。
我原本最擔心的是 W3 拿到原信之後,開始引用客人自己說的話當成事實。這件事沒有發生:兩個版本的合規檢查違規總數都是 0,沒有出現無來源的數字,草稿也沒有變長(中位數只多 7 個字)。
Day 13 寫的那條「你沒有任何查詢工具,你不知道 facts 以外的任何事實」看來有效,即使原信就擺在它面前。
這次跑 22 封,有 4 封查單信被判部分通過,原因都是漏講物流單號。
追下去是 Day 20 接力流程的設計問題。那條流程為了算推論,把派給 W1 的欄位寫死了:
need_csv = 'status,items,delivered_at,eta'
這幾個欄位是算「到貨幾天了」需要的,但裡面沒有 tracking_no。所以客人問「我的包裹到哪了」的時候,W1 根本沒被要求回報物流單號,W3 自然寫不出來。
Day 18 的 Switch 版是依意圖決定欄位的:退貨類要 status,items,delivered_at,查單類要 status,carrier,tracking_no,eta。我在 Day 20 做接力時為了簡單,把它改成一組固定值,結果就漏了。
兩個版本都有這個問題,所以不影響今天的比較,但它說明了接力設計的代價:為了讓推論步驟拿到它要的欄位,我固定了 need,而固定的 need 對其他意圖來說就是漏單。正確的做法是依 intent 決定要哪些欄位,推論步驟需要的欄位另外加上去,而不是取代。
把兩個實驗放在一起,我現在的判斷是這樣。
傳摘要的好處不在省 token。W3 的 prompt 從 1229 變 1273,差 3.6%,這個數字小到不該影響任何決定。真正的好處是責任清楚:W3 手上只有查證過的東西,它就不可能引用沒查證的東西;出事的時候也只需要檢查 facts 對不對,不用回頭讀原信判斷它是不是自己加料。
傳原文的好處是補救摘要的失誤。但這個好處只在摘要真的會漏東西的時候才存在,而我的測試集裡幾乎沒有這種信。
所以我維持原本的做法:W3 只拿 facts 和摘要。不過我會改一件事——主管的輸出裡有一個 questions_asked 欄位,記錄客人總共問了幾件事,這個欄位現在只有稽核員在用。它比整封原信便宜得多,又能擋住「摘要漏掉第二個問題」這種失誤。下週做評估集時,我會把「回信有沒有回應到每一個 questions_asked」加進判準。
至於 W2 的原句,留著。它幾乎不花錢,而且萬一哪天換了比較弱的 embedding,它是個可以立刻切換的備案。
兩個實驗都是沒有差別:W2 多給客人原句,20 題考卷 20/20 對 20/20;W3 多給整封原信,22 封信 15/22 對 14/22,而那一分追下去是用字湊巧。給 W3 原信沒有讓它開始編造,合規違規兩邊都是 0。
真正的收穫有兩個。第一,W2 那個「沒差別」依賴於檢索夠強,Day 12 用較弱的 embedding 時原句的命中率反而更低。第二,我的測試集裡只有一封信的摘要和原文差很多,所以這個題目其實沒有被好好測到,Day 27 要補。
另外抓到一個 Day 20 留下的 bug:接力流程把派給 W1 的欄位寫死,漏了物流單號,害 4 封查單信答不完整。
明天談記憶歸誰管:主管記、專員記,還是都不記。


 iThome鐵人賽
 看影片追技術