
前面十三天都在把東西做對。今天把它弄壞。
我關心的不是「怎麼不要壞」,而是壞掉之後我多久會知道、知道的時候手上有什麼。這兩件事比重試機制重要得多,而且實測下來差距非常大:同樣是「檢索不能用」,一種壞法會讓每題慢一百倍但狀態寫得清清楚楚,另一種壞法快得跟平常一樣、流程全部成功、考卷只剩 6/20。
Day 04 就在 n8n 和 Ollama 中間放了一個計量代理,所有模型呼叫都經過它。這次給它加了故障注入:
if (req.url === "/__fault" && req.method === "POST") {
  const body = await readBody(req);
  fault = { mode: "none", remaining: 0, only_label: null, rate: undefined, ...JSON.parse(body || "{}") };
  res.writeHead(200, { "content-type": "application/json" });
  return res.end(JSON.stringify(fault));
}
三種模式:embed_down 讓 embedding 呼叫回 500、chat_503 讓對話呼叫回 503、chat_slow 拖時間。only_label 可以只打某一位專員——代理本來就是靠 system prompt 的字串認出是誰在呼叫,所以「只讓 W1 的模型掛掉,主管和其他人正常」是做得到的。
這比把 Ollama 關掉乾淨:範圍可控、可重複、不影響其他實驗。
W2 的工具是向量庫檢索。它有兩種壞法。
第一種是大聲壞:embedding 服務回 500。第二種是安靜壞:服務活著、模型活著,但索引是空的——Simple Vector Store 存在記憶體,n8n 一重啟就沒了,忘記重建就是這個狀態。
我把兩種都跑了同一份 20 題考卷:
| 正常 | 索引是空的 | embedding 回 500 | |
|---|---|---|---|
| 考卷 | 20/20 | 6/20 | 6 題全部 error |
| W2 回報的狀態 | ok | 20 題都是 not_found | 6 題都是 error |
| 每題耗時中位數 | 1.9 秒 | 3.2 秒 | 205 秒 |
| 每題 embedding 呼叫次數 | 1~2 | 1~2 | 13~15 |
embedding 回 500 的時候,W2 六題全部回報 status = "error",答案寫得明明白白:
無法從 FAQ 知識庫中獲取咖啡豆開封後的保存方式,因搜尋工具目前無法連線。
我原本預期的是另一回事。我以為工具壞掉的時候,Worker 會把它當成「查不到」,回報 not_found——那是合法的狀態值,驗收層看不出異常。這個猜測沒有成立:錯誤訊息會原樣進到 Agent 的對話裡,而 error 本來就在 Day 11 定的狀態列舉裡,模型選得出來。
真正的問題是時間。每題 205 秒,正常是 1.9 秒。
原因在 embedding 呼叫次數:正常 1~2 次,壞掉的時候 13~15 次。n8n 的 LangChain 元件在 Ollama 客戶端外面包了一層 p-retry,失敗會自己退避重試。從代理的時間戳看得到間隔:
約 2 秒、3 秒、7 秒、11 秒、27 秒、49 秒
一次工具呼叫就這樣燒掉將近兩分鐘,而 Agent 還會再試第二次工具呼叫,於是一題就是三分半。
這一層重試我沒有設定過,它預設就在那裡。 如果你在 n8n 的節點上再開一層 Retry On Fail,那是疊在這之上的。50 封信遇到這種故障,執行會堆在那裡好幾個小時。
索引是空的時候,檢索回傳 0 條。Day 12 幫 faq_search 寫的工具說明裡有一句:
注意:這個工具「總是」會回傳最相關的幾條,即使它們與問題無關。
你必須自己判斷回傳的內容是否真的回答了問題。
模型照做了。它拿到空的結果,判斷「FAQ 裡沒有」,回報 not_found,而且 confidence 寫 1。
20 題全部這樣。notes 欄位還很認真地寫著換了兩組關鍵字都查不到:
已嘗試使用「運費 免運門檻」及「運費」兩個關鍵字搜尋,均無結果。
考卷 6/20。而那 6 題過關的,全部都是標準答案本來就是「FAQ 沒有寫」的題目——換句話說,系統沒有答對任何一題,只是有 6 題剛好猜中了「我不知道」。
從外面看,這段時間裡每一次執行都是成功的、每題 3.2 秒、HTTP 全部 200、沒有任何錯誤訊息。not_found 是一個合法的狀態值,它把「索引掛了」這件事完整地蓋住了。
「查不到」和「索引是空的」在 Worker 眼裡長得一模一樣,所以不要叫 Worker 去分辨,直接問向量庫:
const CANARY = [
  { q: "咖啡豆開封之後要怎麼保存", must: "密封" },
  { q: "運費怎麼算,滿多少免運", must: "1500" },
];
兩句答案已知的問題,打到檢索端點,檢查回傳條數和關鍵字。實測結果:
正常的索引:OK   回傳 4 條,含「密封」=true
空的索引:  FAIL 回傳 0 條,含「密封」=false
兩次 embedding 呼叫,不到一秒。我現在把它放在每次跑實驗之前,以及 n8n 重啟之後。
這是今天最便宜也最有用的一樣東西。 它不防止故障,它只是讓一種原本完全看不見的故障變得看得見。
接下來把故障放在模型上:chat_503,只打 W1。主管正常分類,派工給 W1,W1 的模型回 503。
同一個故障在兩種設定下的結果如下圖。
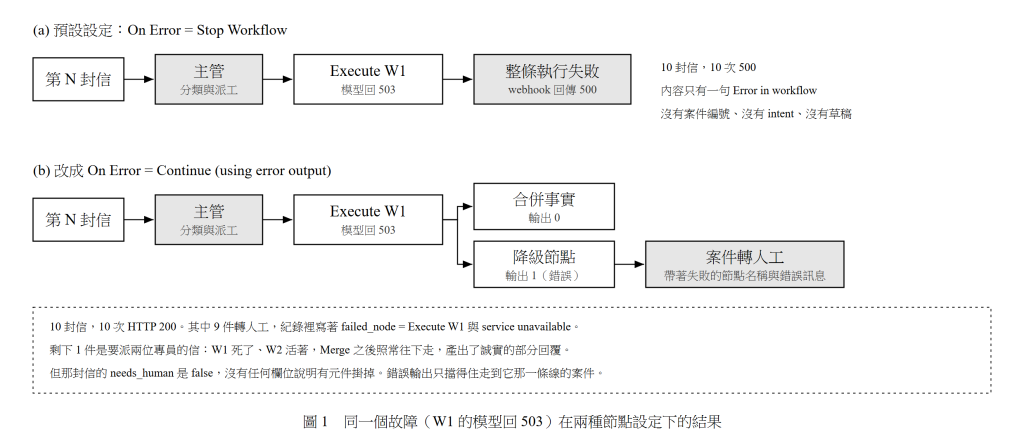
n8n 每個節點的 Settings 裡有一個 On Error,預設是 Stop Workflow。用預設值跑 10 封查單信:
10 封信,10 次 HTTP 500
回應內容:{"message":"Error in workflow"}
十次全滅,每次大約 1.6 秒。回應裡沒有案件編號、沒有 intent、沒有 clean_question,什麼都沒有。主管明明已經成功分類了,那份結果也跟著一起消失。
要知道是哪一封信、為什麼失敗,只能去 n8n 的 Executions 裡一筆一筆翻。
把 Execute W1、W2、W3 的 On Error 改成 Continue (using error output),節點會長出第二個輸出,錯誤從那裡出來。我接一個 Code 節點:
// n8n 的錯誤輸出項目 = 原本的輸入 json 再加一個 error 欄位(字串),
// 沒有帶節點名稱,所以用 $prevNode 取。
const e = $input.first().json;
const c = $('Classify Guard').first().json;

return [{
  json: {
    case_id: c.case_id,
    route: 'human',
    final_action: 'escalate',
    degraded: true,
    failed_node: $prevNode?.name ?? 'unknown',
    error_message: String(e.error ?? '').slice(0, 300),
    intent: c.intent,
    needs_human: true,
    human_reason: '系統故障,已轉人工',
    clean_question: c.clean_question,
    facts: [],
    worker_statuses: ['error'],
    draft: null,
  },
}];
那兩行註解是實測得來的。我第一版寫 e.error.message,拿到的是空字串——錯誤輸出的項目不是一個錯誤物件,是原本的輸入再多一個 error 字串欄位,而且裡面沒有節點名稱,要用 $prevNode 拿。
同樣 10 封信重跑:
10 封信,10 次 HTTP 200
9 件:final_action=escalate,failed_node=Execute W1,
      error_message=service unavailable,intent 和 clean_question 都在
第 10 封是 EV13:「想問 A10294 出貨了嗎?另外淺焙的豆子可以做冰滴嗎?」一信兩問,route = both,要同時派 W1 和 W2。
W1 死了走錯誤輸出,W2 活著繼續走。兩條線在 Merge 之後會合,流程照常往下跑,最後產出了這封信:
李小美 您好,

感謝您的來信。

關於訂單 A10294 的出貨狀態,我這邊幫您確認後,最晚 24 小時內回覆您。淺焙咖啡豆
酸質明亮且有花果香氣,適合手沖、冰滴與冷萃。

祝您有個美好的一天,
好豆選物 客服小豆
這封信其實寫得對。unresolved 裡記著「訂單 A10294 的出貨狀態」,W3 照 Day 13 的規矩把查不到的部分寫成「幫您確認後回覆」,沒有編造任何東西。
但是 needs_human 是 false,worker_statuses 只有 ["knowledge:partial"]。整份案件紀錄裡沒有任何一個欄位說明有元件掛掉。 從資料上看,它跟「W1 正常執行但查不到資料」完全一樣。
錯誤輸出只擋得住走到它那一條線的案件。分支一多,死掉的那條被接走了,活著的那條會帶著殘缺的事實繼續往前,而且看起來很正常。
正確的做法是讓降級節點也把狀態寫回主線——例如在 Combine Facts 之前補一個「有沒有哪一支專員走了錯誤輸出」的欄位。這是 Day 25 要做人工審批時一定要有的資訊,我會在那邊補。
再往上一層:如果連主管的模型都不能用,上面那些都沒意義,因為 intent 和 clean_question 根本產不出來。
這一層我接的是純樣板。主管節點開 Retry On Fail(3 次、間隔 2 秒),三次都失敗之後走錯誤輸出,接一個完全不呼叫模型的 Code 節點:
const draft = [
  `${m.from_name} 您好`,
  '',
  `我們已經收到您的來信(主旨:${m.subject}),客服人員會在一個工作日內回覆您。`,
  '',
  '祝您有個美好的一天,',
  '好豆選物 客服小豆',
].join('\n');
實測 3 封信:代理記到主管被呼叫 3 次、3 次都是 503,然後輸出 final_action = "ack_only"、failed_node = "Supervisor"、error_message = "service unavailable",加上一封寫著客人名字和原本主旨的收件確認。整件事花 4.2 秒,其中 4 秒是兩次重試的等待,模型 token 是 0。
在一個全靠 AI 的流程裡留一條完全不碰 AI 的路,成本大概就是這二十行。
做完之後回頭看,今天其實把四種結果都實際觀察到了:
| 什麼情況 | 實際看到的 | |
|---|---|---|
| 完整回覆 | 都正常 | 前面十三天 |
| 部分回覆 | 一位專員死、另一位活 | EV13,誠實寫出「幫您確認後回覆」 |
| 轉人工 | 唯一的專員死了 | 9 封,帶著失敗節點與錯誤訊息 |
| 收件確認 | 主管死了 | 3 封,0 個模型 token |
第二層不是我今天寫的。它是 Day 20 的 unresolved 加 Day 13 給 W3 的規矩,本來就存在。今天只是把「整條流程消失」改掉,它就自己浮出來了。
前面是「掛掉就是掛掉」。更常見的是間歇性失敗——限流、偶發 503。
我把 W1 的模型設成 40% 機率回 503,跑同一份 20 題考卷,一個版本不開節點重試,一個版本開 Retry On Fail(3 次、間隔 2 秒):
| 正常 | 40% 失敗,無節點重試 | 40% 失敗,重試 3 次 | |
|---|---|---|---|
| 考卷 | 20/20 | 10/20 | 20/20 |
| HTTP 200 | 20/20 | 10/20 | 20/20 |
| 每題耗時中位數 | 1.9 秒 | 0.8 秒 | 5.6 秒 |
| token 總和 | 67328 | 48858 | 83599 |
要說明的是,「無節點重試」那一欄並不是只打一次——我的測試腳本本來就會在收到 5xx 時整個請求重打,最多三次。即使外層已經重打三次,還是有一半的題目答不出來,而節點層重試讓它回到滿分。
差別在重試的位置。外層重打是整封信從頭來過,中間成功的步驟全部重做;節點層重試只重跑失敗的那一個節點,前面的結果留著。
代價是 token 多 24%、每題中位數從 1.9 秒變 5.6 秒。重試會重跑整個 Agent 迴圈,包含已經呼叫過的工具,所以多付的不只是等待時間。
那個 0.8 秒也值得看一眼:失敗的時候比成功還快。如果你只看平均延遲,故障期間的數字會變好看。
這是第七次了,而且這次很有意思:它只有在系統壞掉的時候才會出現。
索引空掉那一輪,W2-09、W2-12、W2-15 被判「出現禁止內容」,例如禁止說「可以退貨」。但 W2 實際寫的是:
在官方 FAQ 知識庫中找不到關於「已開封咖啡豆是否可以退貨」的相關規定。
它是在複述問題,不是在斷言。Day 18 已經為同樣的問題在 checkMentions 加過處理——比對禁止內容之前,先把含「是否」的子句拿掉——但那隻手只裝在評估集的評分器上,考卷的評分器沒有。
平常不會發現,因為答得出來的時候,W2 的答案裡不會出現「是否」。一個只在故障時才觸發的評分器 bug,剛好在故障實驗裡才現形。
補上之後,索引空掉那一輪從 5/20 變成 6/20。我把之前所有用過考卷的結果都重新評了一次(Day 15 的三份、Day 12 的三種設定、Day 22 的一份),分數全部沒有變。
error,但因為 LangChain 客戶端內建的退避重試,每題從 1.9 秒變成 205 秒。安靜壞(索引是空的):每題 3.2 秒、流程全部成功、考卷 6/20,而且那 6 題全部是標準答案本來就是「不知道」的題目。not_found 是合法狀態,它會把基礎設施故障蓋得乾乾淨淨。解法不是叫 Worker 自己分辨,是用兩句答案已知的問題直接問向量庫,兩次 embedding 呼叫就夠。failed_node 和錯誤訊息的轉人工案件。needs_human 是 false,沒有任何欄位記得有東西掛掉。明天做人工審批:哪些案件該讓人看過再寄,以及人要看到什麼才有辦法判斷。今天留下的那個缺口——案件紀錄裡沒有「有元件掛掉」這件事——會在那邊補上。


 iThome鐵人賽
 看影片追技術