
Day08-14 建好的 HTTP request 分流方式,是精確比對 x-canary: true 這種明確的 Header/Cookie。今天要加入新的分流方式:比例分流,按照設定的百分比(例如 10%),讓一部份 一般流量 自然流進 Canary。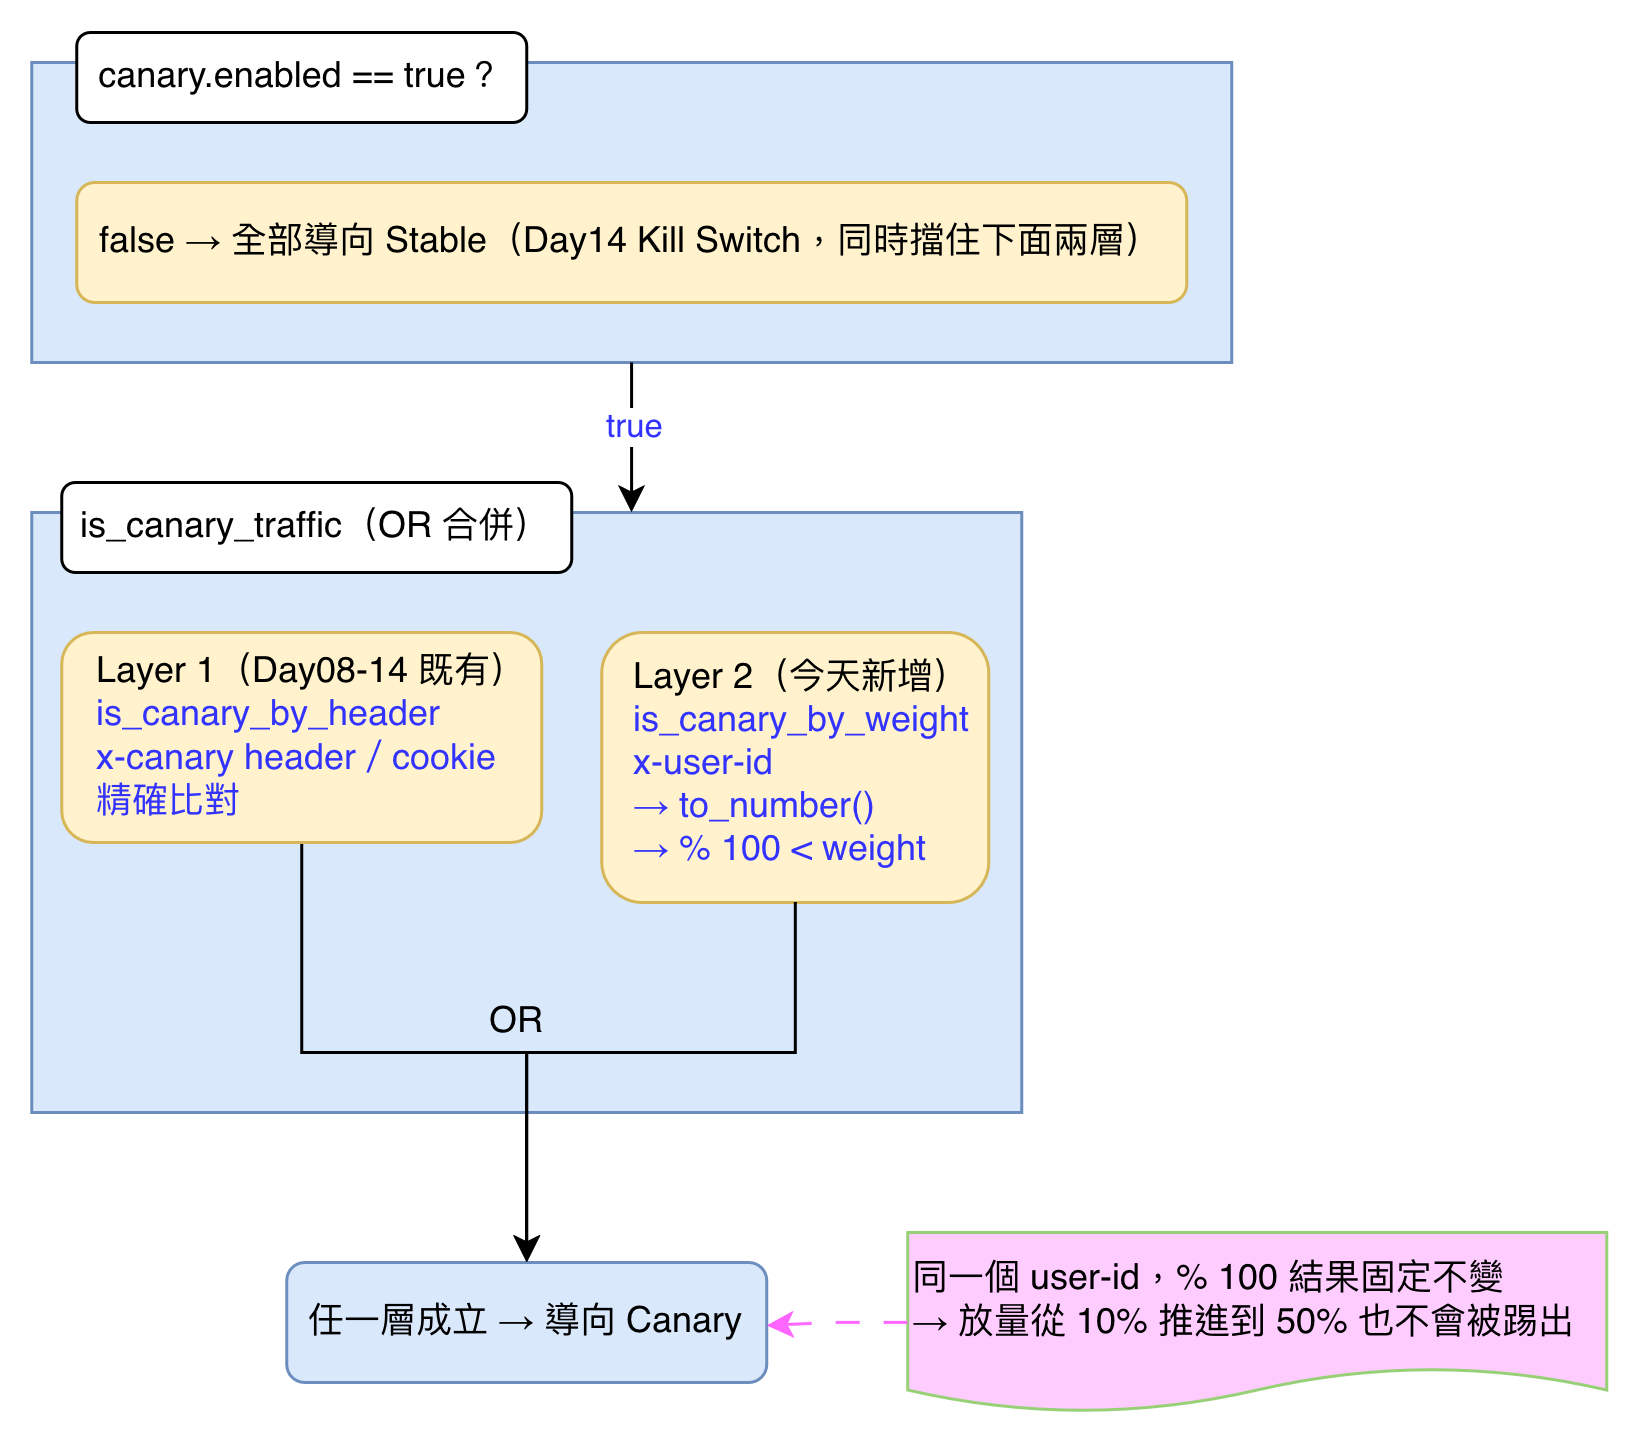
QA 團隊使用的 測試流量 是可預期和可控制的。然而,極端邊界值、奇怪的封包格式、異常的連線中斷,這些只有在 不受控制 的 真實流量 中才會現形。我們把真實流量的 10% 導入 Canary,能提早觀察 CPU、Memory、連線池這些元件的真實負載曲線,避免等到 100% 全量切換才發現錯誤,以此控制「爆炸半徑」(Blast Radius)。
我設計了一個簡單的分流策略:在每個 HTTP request 裡,加入能代表訪客身份的 識別值,用來表示「誰」發出了這次的 HTTP request。把這個 識別值 轉成數字,對 100 取餘數,跟一個特定的數字比大小,小於就判定送往 Canary,大於就不做處理,走預設路由。
如果同一個使用者每次訪問 demo-app,都會在 Canary/Stable 之間來回跳,一旦出錯,很難分清是 Canary 的新 bug,還是 Stable 本身的 bug。所以我們要確保同一個使用者每次訪問 demo-app 都能進到同一個 Stable / Canary Pod,我們稱這種情況叫「訪問具有 黏滯性」。這正是 識別值 必須滿足的條件。
在本專案裡,我們把這個識別值用 HTTP Header 的方式夾帶,叫做 x-user-id。帶有不同 x-user-id 的請求,視為不同訪問者發出的請求。我們會用腳本建立 100 個 x-user-id(1001~1100),模擬 100 個不同的訪客,每個人各發送 10 次請求。然後對 x-user-id 取餘數,餘數小於設定的 weight(例如 10)的 HTTP request 會被導入 Canary。這樣設計的訪問具有黏滯性,即使放量從 10% 推進到 50%,原本落在 Canary 裡的使用者不會被踢出 Canary。
我知道這樣設計滿取巧的,在真實環境裡分流的依據會更複雜,需考慮更多條件,例如:匿名性的 HTTP request 如何處理、字串型的 user-id 如何處理⋯⋯。為了避免模糊重點,所以我盡可能簡化方式。
具體步驟:
canary.json 的 enabled 是不是 true;是的話才讀取這次請求 Header 裡的 x-user-id。to_number() 把 x-user-id 字串轉成數字。weight 比大小,小於 weight 才判定為 Canary。is_canary_by_weight {
data.canary.enabled == true
user_id := to_number(input.request.headers["x-user-id"])
user_id % 100 < data.canary.weight
}
精確比對跟比例分流用 Rego 裡「同名規則 OR 合併」的寫法接起來,我們在 Day09-14 合併 Header/Cookie 兩個條件用的時候用過這方法。這次改動的 canary-routing.rego(下面的合併規則)和 canary.json(weight 欄位)都在同一個檔案 manifests/infra/opa/dayNN/opa-deployment.yaml 裡,是這個 ConfigMap 底下的兩個 data key,K8s 會把它們掛載成 OPA Pod 裡的兩個獨立檔案:
is_canary_traffic { is_canary_by_header }
is_canary_traffic { is_canary_by_weight }
在同一個 canary.json 裡多加一個 weight 欄位:
{"canary": {"enabled": true, "weight": 10}}
要讓今天的改動生效,把 opa-app.yaml(定義 opa ArgoCD Application 的 Git 檔案)的 source.path 從目前指到的舊快照,切到今天新增的快照資料夾(這個版本副本數也從 1 台調到 2 台)。
scripts/verify-day23-hash-modulo.sh 會執行以下步驟與判斷:
x-user-id(1001~1100),各發送 10 次請求:每個人的 10 次是否都落在同一個版本(黏滯性),以及 100 人裡落在 Canary 的比例是否接近 weight(比例分流)x-canary: true Header 是否仍然直接進 Canarycanary=true Cookie 是否仍然直接進 Canary把 canary.json 的 enabled 改成 false,重跑驗證腳本:這時候即使 QA 帶對 x-canary: true Header 或 canary=true Cookie(原本無條件會進 Canary),也應該被導向 Stable——證明 enabled=false 是全域總開關,同時擋下 Layer 1(精確比對)跟 Layer 2(比例分流)兩種機制,不是只管今天新加的比例分流。驗證完把 enabled 改回 true,恢復正常運作。


 iThome鐵人賽
 看影片追技術