
前一天的時候我們講到
這數十萬筆的對話,格式又複雜,很難快速整理內容
因此這個時候就挺適合拿出一些 Vibe Coding 魔法
Do Re Mi So
第一步,先不急著做工具
而是請 Codex 把這一大包資料,先整理成方便後續處理的形式
整理之前
是 14,170 個檔案、19 種格式,散在 715 個資料夾裡,最深的有 7 層
整理之後
變成一份 135,134 筆的對話資料
其中文字訊息 130,964 筆、通話紀錄 3,313 筆
後面工具裡的統計、搜尋、前後文、時間軸
都是從這一份資料長出來的
Vibe Coding 小技巧:
對於一次性的需求,可以直接產出最後結果就好。
但對於需要反覆對照的需求,可以先做一些前處理會比較好。
資料整理好之後,才是把它做成工具
我請 Codex 做了一個「對話證據檢視器」
一個只在自己電腦上跑的網頁
畫面左下角寫著「僅限本機・資料未部署、未上傳」
昨天擔心的「不敢把資料傳到外部服務」,這樣就不是問題了
接下來,就照著實際使用的順序
看看它是從哪幾個角度設計的
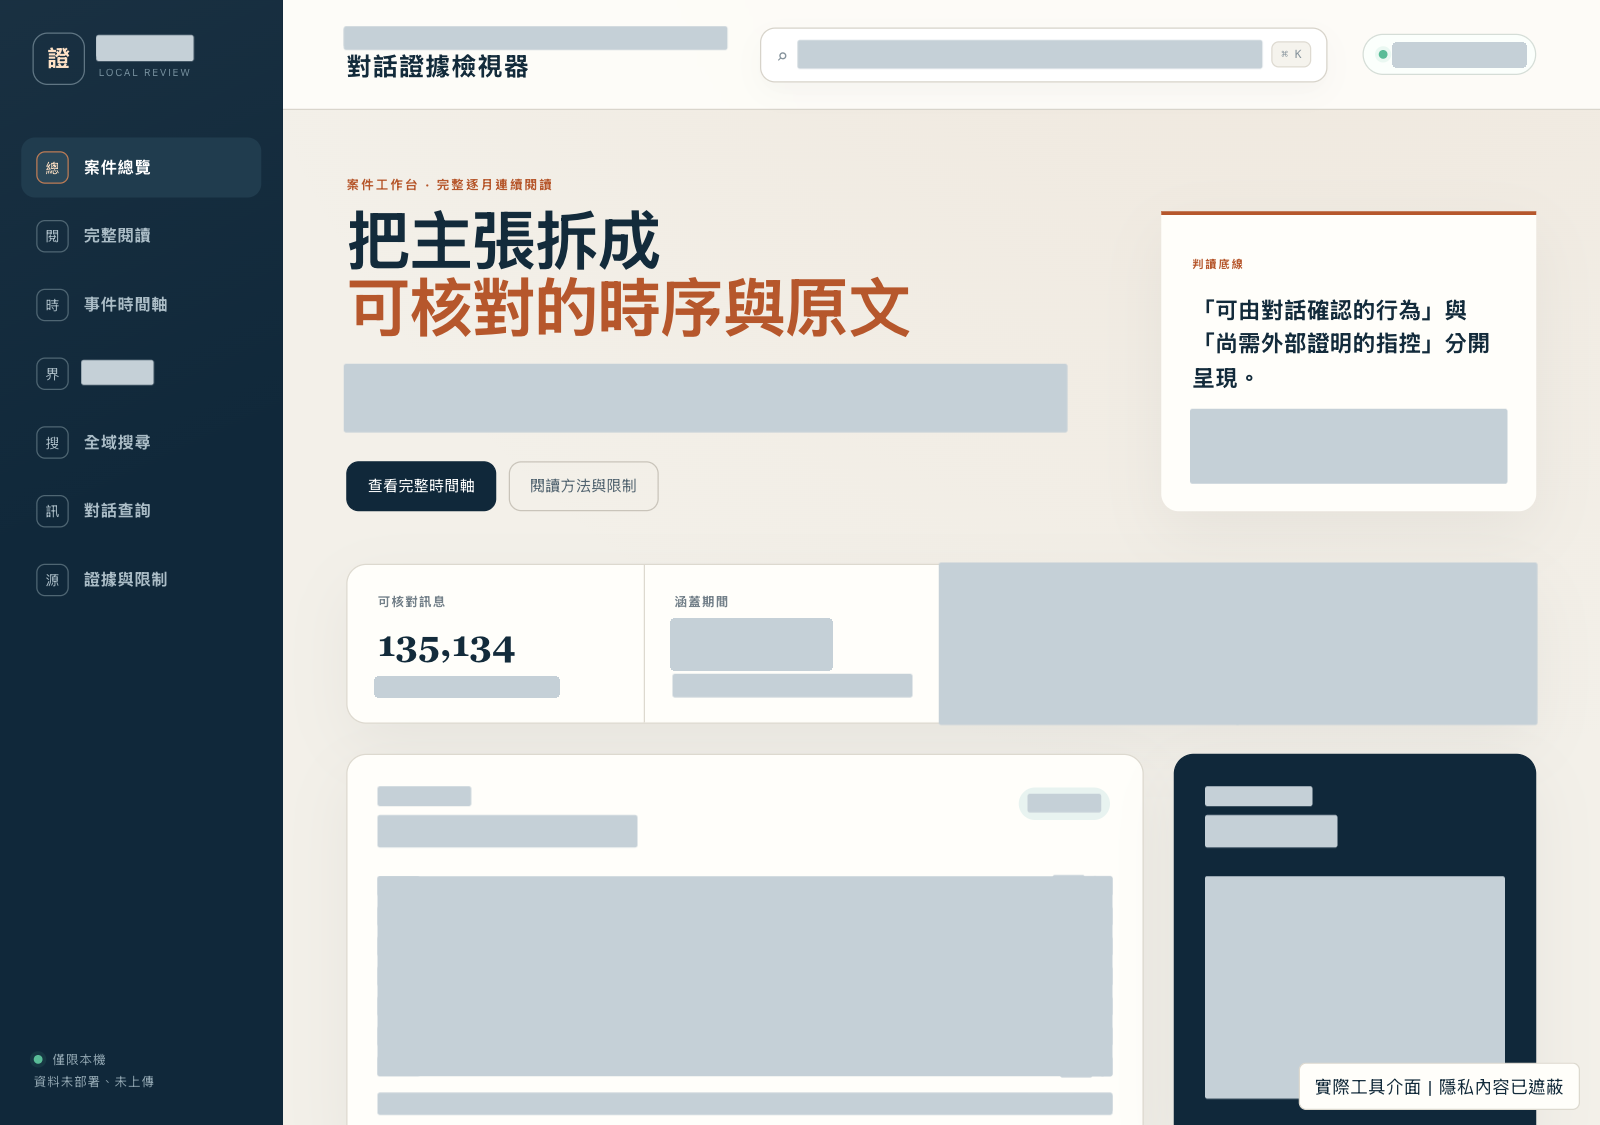
打開來的第一頁,是整個案件的總覽
可以核對的訊息有 135,134 筆,一頁就看得到規模
上面那行大字「把主張拆成可核對的時序與原文」
大概就是這整個工具想做的事
昨天說的「滑了很久都找不到」的問題
現在變成了可以直接輸入關鍵字,一次搜全部多少筆
還可以再篩說話者、紀錄類型、起訖月份
實際畫面大概這樣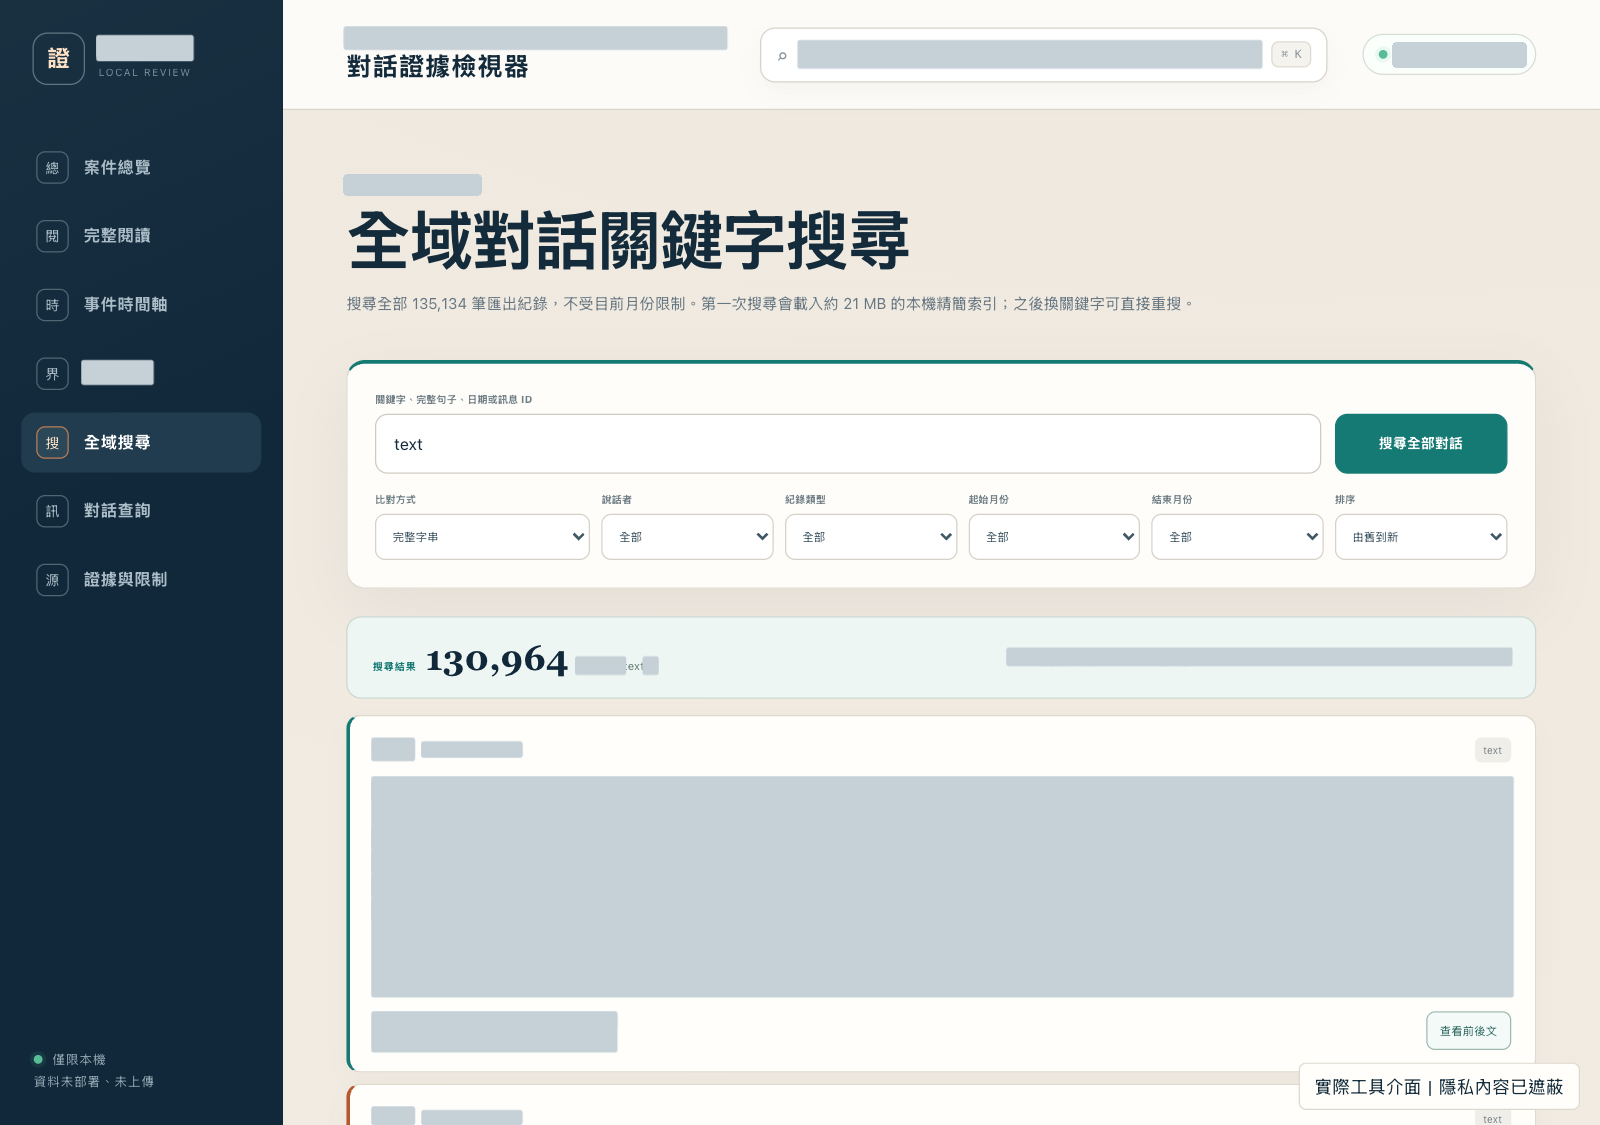
而且工具的價值不只於此
找到之後的部分才是重點
因為大多數時候,我們的每一個單一則對話都是很局部片面的
單獨拿出來常常看不懂
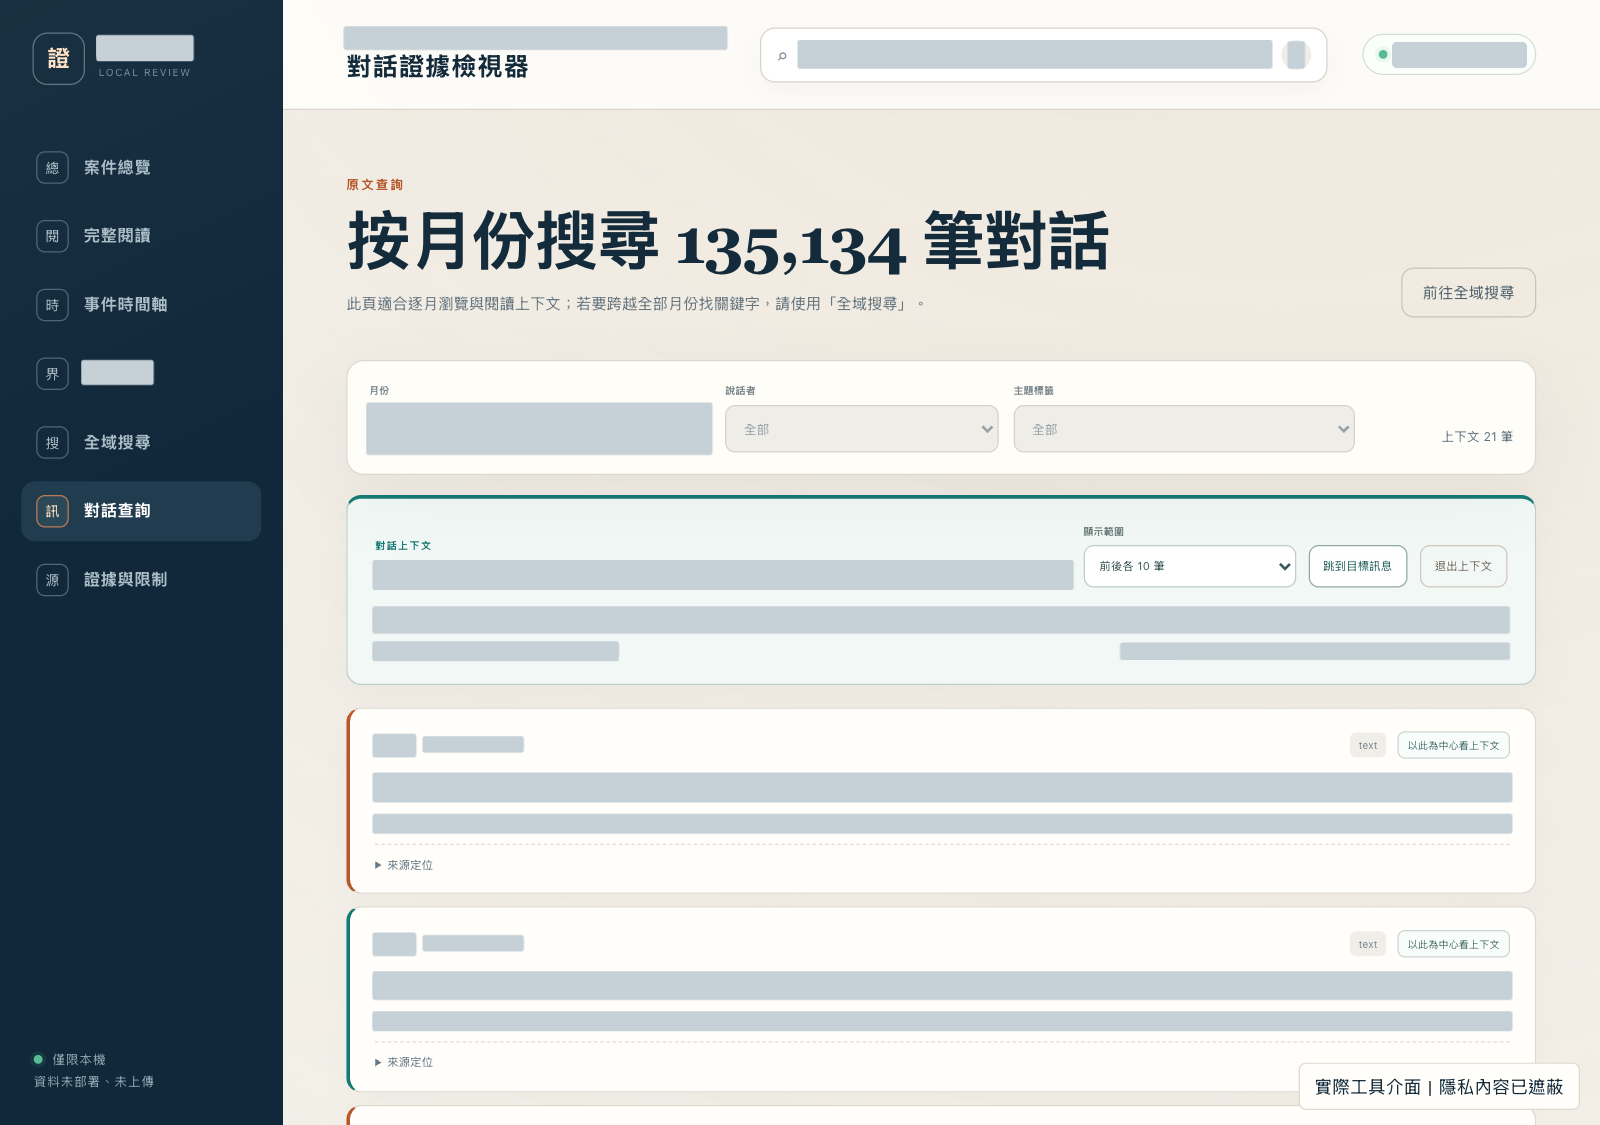
所以每一筆搜尋結果旁邊,都額外加了一個「查看前後文」
選前後各 10、30、100、300 筆,或是同一天的全部對話
更方便了解當時對話脈絡
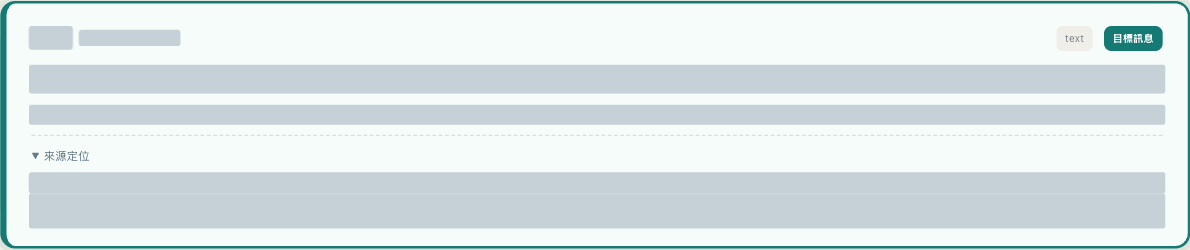
而每一筆也都可以展開「來源定位」
對回它原本是在哪個檔案裡(避免 AI 幻覺的最後防線,還是要人類自己檢查最重要的部分
最後則是事件時間軸
在時間軸上整理出大大小小的事件,並且可以依階段、主題來篩
這樣就不用從頭讀完十幾萬筆,也能先看到重點在哪裡
而這邊主要就是盡可能做好前面的各種雜訊整理
真正的判斷,還是留給律師的專業見解
我們當時和律師聊的時候,律師看到這個一臉震驚表示也太方便XDD
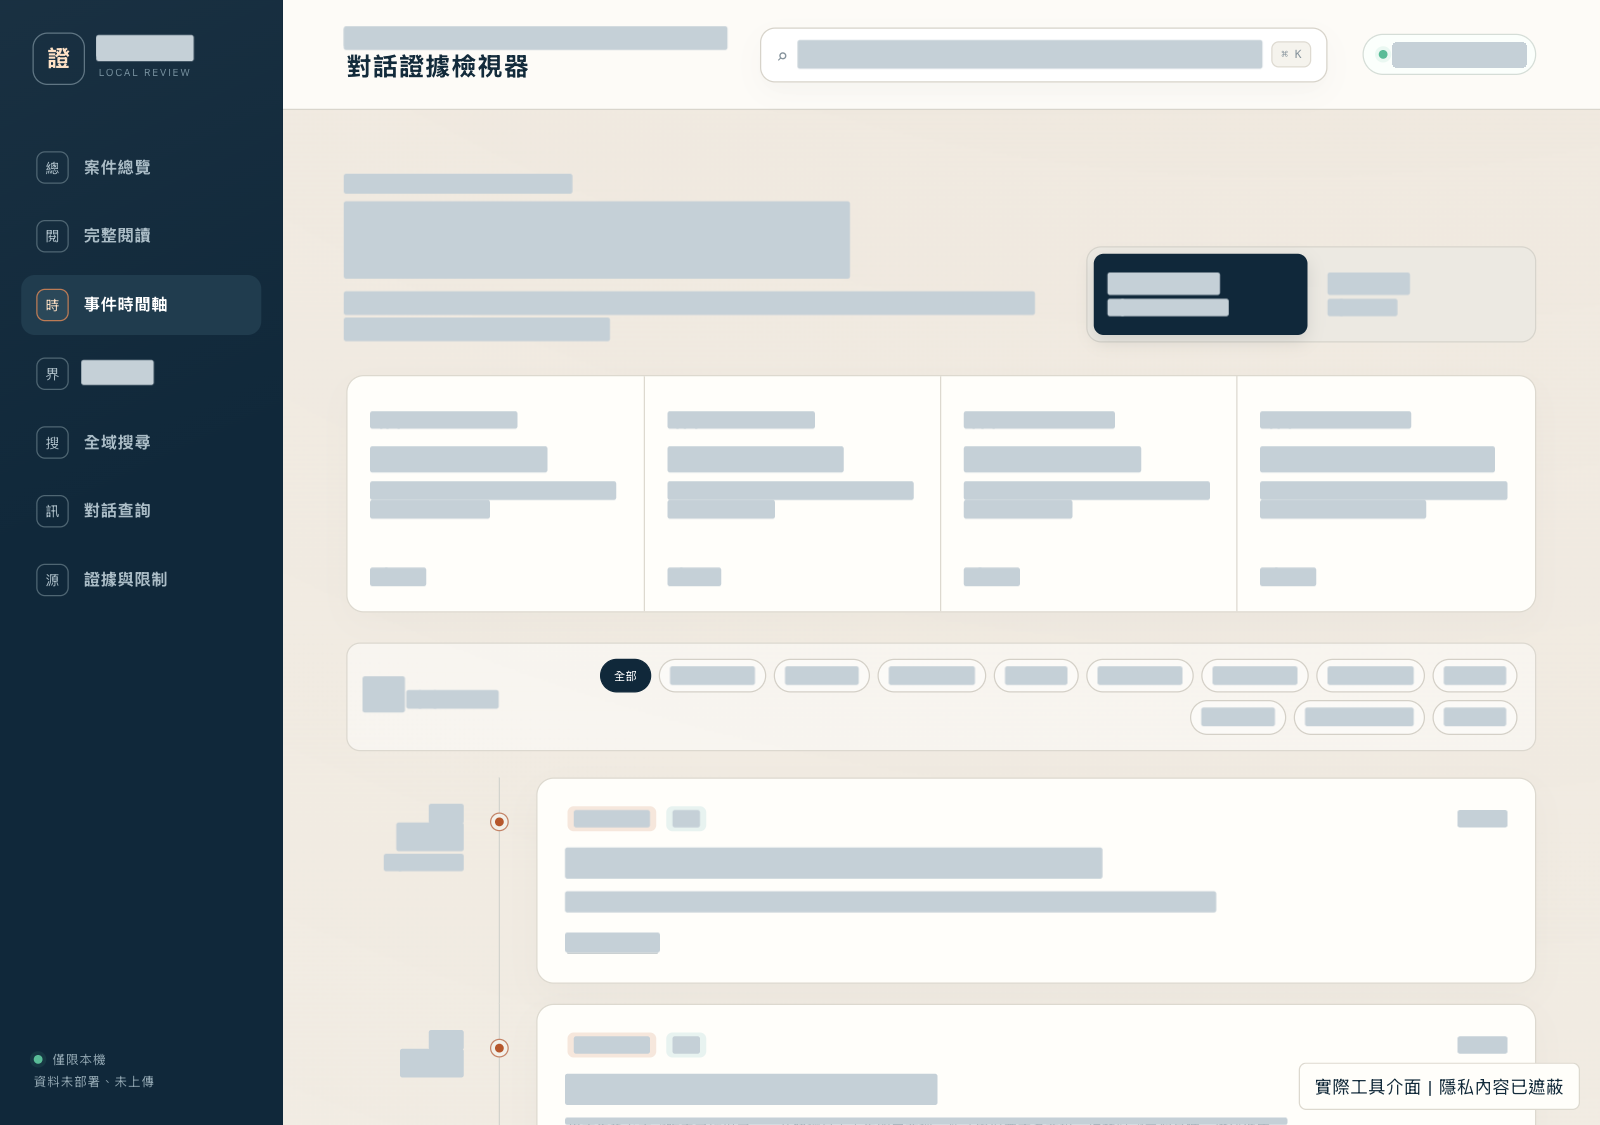
把散落的檔案,換成搜得到、看得到前後文、篩得出重點的形式
而且讓每一筆都能對得回原文(這個很重要
已經到怎麼多個個案例了,這次就不細講提示詞了
因為比起花了多少次,更想講的其實是省下了什麼
這個工具處理的,主要是對話的文字
以盤點內容為主,而背後的價值判斷還是要有其他的專業介入
生活中的各種資料其實一直都在
但換了個形式,就可以變的很不一樣
C011 的煩惱:滑不完的對話紀錄
工具的部分,就此宣布解決!
(而官司的部分,就交給專業的律師了。希望大家都好好的不要遇到那種一天到晚不成熟只會情緒勒索和威脅人身安全的危險情人了...)


 iThome鐵人賽
 看影片追技術