
在資安與資料治理的實務中,最危險的誤解就是將「去識別化」看作一場大型的「搜尋與取代」遊戲。許多企業以為只要把姓名換成「王小明」、電話中間三碼打上星號,這筆資料就算「洗乾淨」可以對外發布了。
然而,這種處理方式僅能擋住「瞄一眼」的旁觀者,在有心攻擊者眼中,這類資料與裸奔無異。為什麼即便遮掉了所有名字與帳號,你依然能被精準鎖定?真正的去識別化並非文字表面的修飾,而是一場關於「資料關聯性」與「資訊熵」的深度防禦。
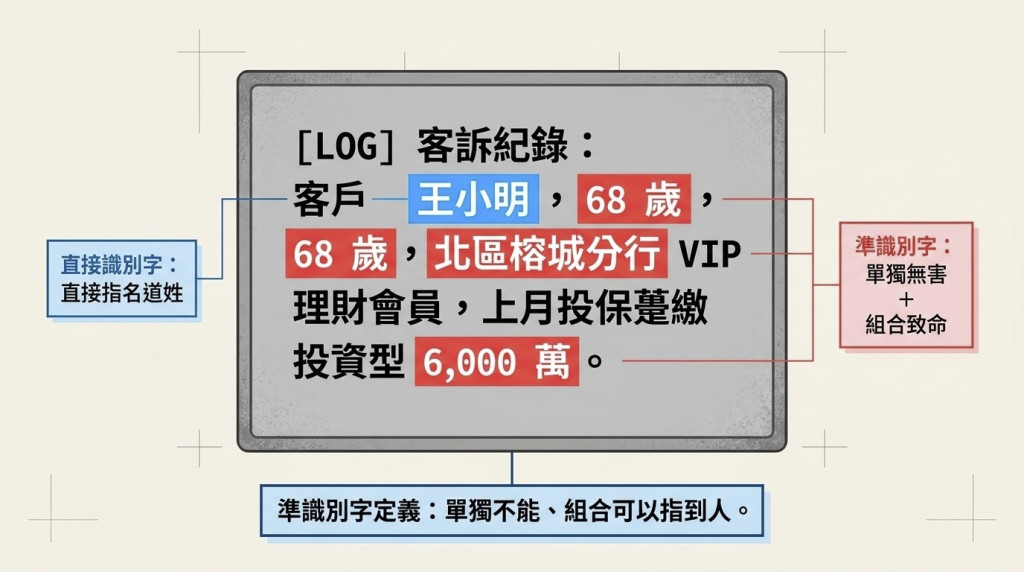
要看穿去識別化的漏洞,我們必須先拆解資料的「識別維度」:
這種「組合識別」是現代資料治理中最難纏的對手。即便你把名字刪了,只要準識別字的組合過於獨特,攻擊者依然能拼湊出完整的人格圖像。
為了對抗識別風險,我們通常有四種戰略工具。但請記住,每種技術都有其代價,特別是針對「準識別字」的處理:
| 手法 | 可逆性 | 適用場景 | 殘餘風險 |
|---|---|---|---|
| 遮罩 (Masking) | 不可逆 | 單純的介面展示、報表列印 | 僅處理表面特徵,無法應對關聯攻擊 |
| 假名化 (Pseudonymization) | 可逆 | 需跨紀錄追蹤同一人(如行為路徑分析) | 高風險。依賴「映射表」還原,若表外洩則全線崩潰(規則 R5 將映射表視為高敏感) |
| 泛化 (Generalization) | 不可逆 | 解決準識別字組合風險的核心手段 | 犧牲精確度。例如將 68 歲模糊化為「60-70 歲」區間 |
| 欄位刪除 (Deletion) | 不可逆 | 成本最低、最徹底的防禦 | 失去該維度的分析價值。若任務用不到,應優先刪除 |
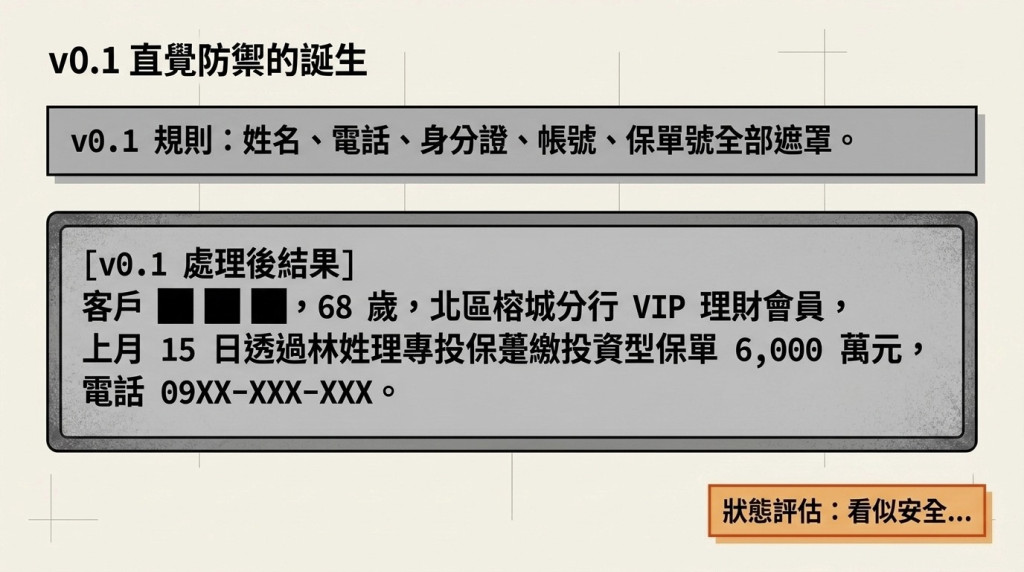
在初階的規則(v0.1 版)中,開發者往往只要求遮蔽直接識別字。然而,這種天真的邏輯在面對「極端值」時會瞬間失效。
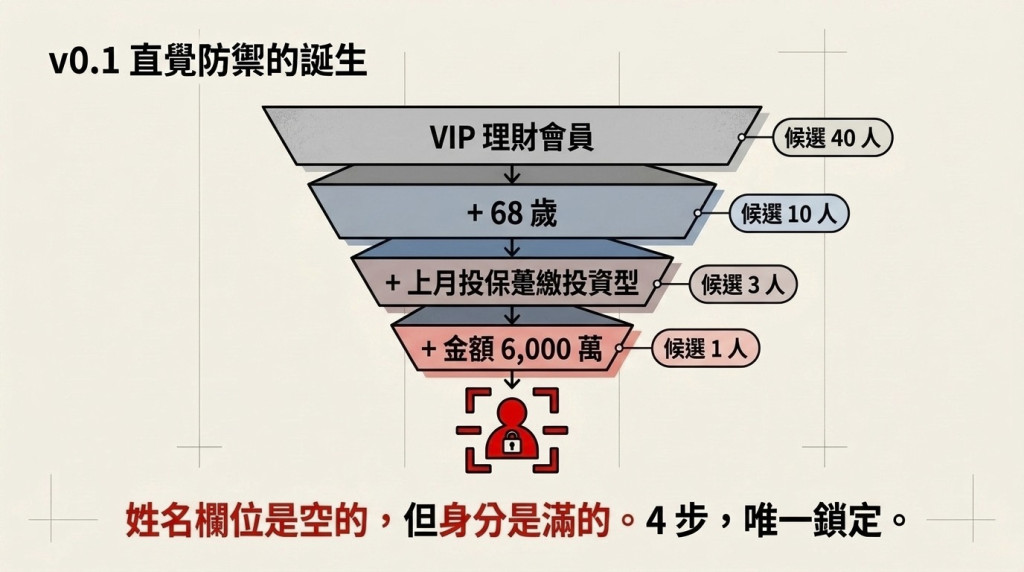
讓我們模擬一場針對 v0.1 規則的「重識別攻擊」(Re-identification Attack)。某份客訴紀錄處理後如下: 「客戶王小明,68 歲,北區榕城分行 VIP,上月投保躉繳投資型保單 6,000 萬元。」
攻擊者只需四步就能唯一鎖定本人:
> 「姓名欄位是空的,身分是滿的。」
這揭示了一個諷刺的資安悖論:在 Day 7 的異常值偵測中,這筆 6,000 萬的交易是我們極力保護的「寶貴數據」;但在去識別化的場景中,「極端值」卻是致命的識別特徵。當一筆資料在群體中顯得越「有價值」(越極端),它就越容易成為被攻擊的標籤。
去識別化是否合格,不能只靠檢查程式碼是否執行。在規則 R4 中,我們定義了核心的「逆向測試義務」:去識別化的驗收標準是「攻不破」,而不僅僅是「處理過」。
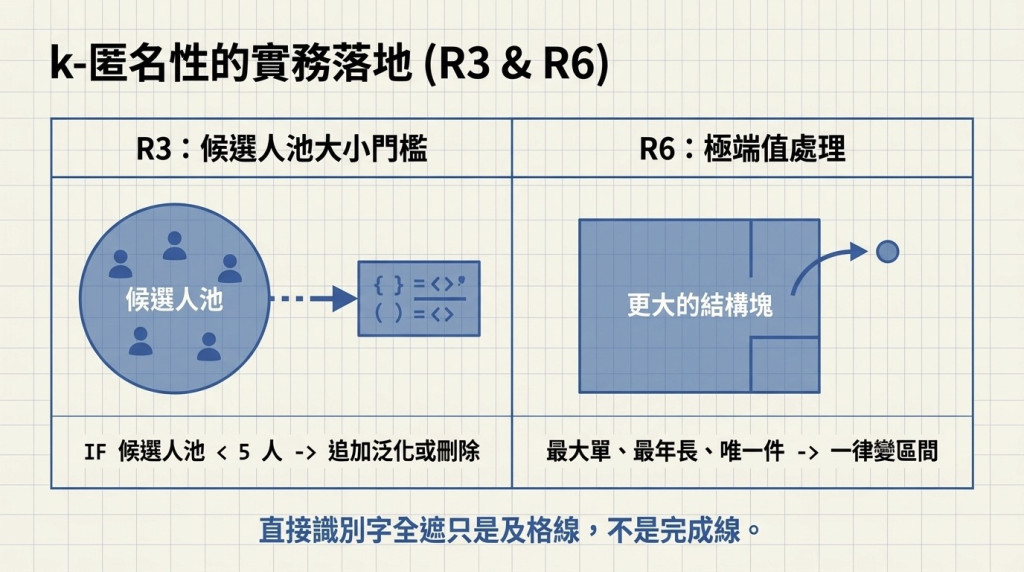
為了達到這個目標,企業應採納以下兩大實務準則:
在 v1.0 的修正版中,上述的客訴紀錄會被重製為:「60-70 歲、北區、5,000 萬以上金額、刪除具體日期與理專姓氏」。此時,攻擊演練將無法將範圍縮小到 5 人以內。
去識別化絕非一套靜態的設定清單,而是一個動態評估、反覆淬鍊的過程。從直接識別字的「及格線」,到準識別字管理的「進化線」,我們必須意識到:資料的安全性來自於其「不可預測性」。
在追求數據驅動決策的時代,我們必然會觸碰到數據價值與個人隱私的臨界點。身為資料治理者,我們必須回答那個終極問題:我們是否準備好,為了達到「攻不破」的安全標準,而在必要時犧牲資料的「精確度」?
這不僅是技術的權衡,更是企業在數據時代對於「責任」的最終承諾。


 iThome鐵人賽
 看影片追技術