
CloudWatch、CloudTrail、AWS Config 是系統上線後的三個監控服務,各自回答一個問題:
三個服務通常在同一次事件中一起使用。舉例:下午 2 點,網站回應變慢,同時有大量來自不明 IP 的連線。從發現異常到查清楚原因,每一步用到一個服務的功能。
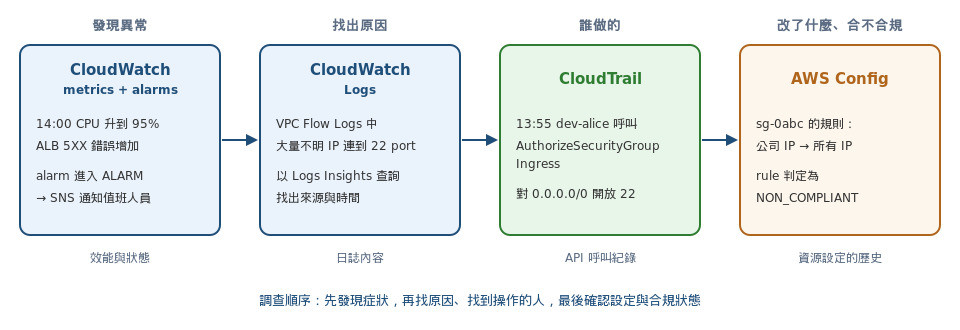
用途:系統不正常時自動發現,並通知人或直接處理,不必有人一直盯著監控畫面。
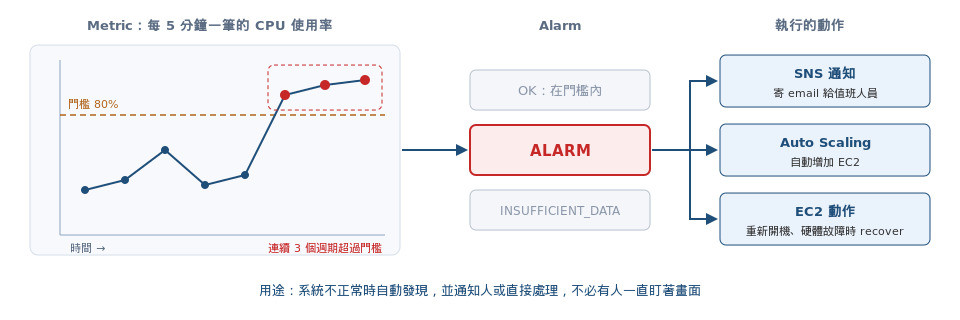
14:00,值班人員收到通知:網站的 EC2 CPU 使用率連續 15 分鐘超過 80%。這個通知來自 CloudWatch 的 alarm,alarm 監看的對象是 metric。
Metric 是一組依時間記錄的數值,例如每 5 分鐘一筆的 CPU 使用率。AWS 服務會自動把自己的 metric 送進 CloudWatch,不需要任何設定。但 AWS 只看得到虛擬機「外面」的狀態,EC2 的 metric 因此分成兩類:
| 類型 | 例子 | 怎麼取得 |
|---|---|---|
| 預設提供 | CPU 使用率、網路流量、狀態檢查(status check) | 自動提供 |
| 預設沒有 | 記憶體使用率、磁碟空間使用率 | 這些在作業系統內部,要在 EC2 上安裝 CloudWatch agent 送出;agent 也能裝在地端伺服器上 |
預設的 EC2 metric 每 5 分鐘一筆(basic monitoring);開啟 detailed monitoring 後改為每 1 分鐘一筆,另外收費,Auto Scaling 需要更快反應時會開啟。應用程式自己的數字,例如每分鐘的訂單數,可以用 PutMetricData API 送出,成為 custom metric。
Alarm 監看一個 metric,條件寫成「連續幾個週期超過門檻」,例如「CPU 連續 3 個 5 分鐘都超過 80%」,避免短暫的尖峰造成誤報。alarm 有三種狀態:OK(在門檻內)、ALARM(超過門檻)、INSUFFICIENT_DATA(資料不足,例如 metric 停止送出)。進入 ALARM 時可以執行的動作:
| 動作 | 例子 |
|---|---|
| 發送 SNS 通知 | 寄 email 給值班人員、觸發 Lambda |
| Auto Scaling | 觸發 scaling policy 增加或減少 EC2 |
| EC2 動作 | 停止、終止、重新開機,或 recover:底層硬體故障時,把 instance 移到另一台主機,保留原本的 instance ID 與私有 IP |
多個 alarm 可以組成 composite alarm,例如「CPU 高而且錯誤率高才通知」,減少單一指標造成的誤報。
這次事件中,alarm 只能說明「CPU 很高」,說明不了原因。下一步要看日誌。
用途:metric 只有數字,日誌記錄實際發生了什麼,用來找出異常的原因。
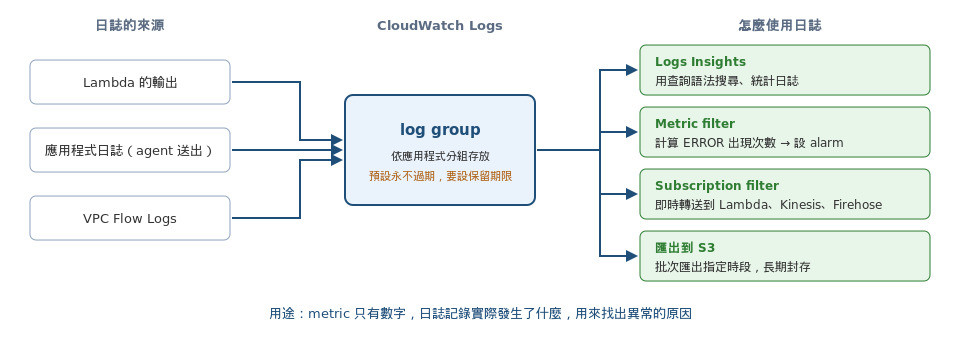
Metric 只有數字,要知道實際發生了什麼,要看日誌。CloudWatch Logs 集中存放各種日誌,例如 Lambda 的輸出、應用程式日誌(透過 CloudWatch agent 送出),以及記錄 VPC 內 IP 流量的 VPC Flow Logs。日誌依 log group 分組,例如一個應用程式一個 log group。
值班人員用 Logs Insights 查詢 VPC Flow Logs,找出過去一小時連到 EC2 次數最多的來源:數百個不明 IP 從 13:56 起持續連到 22 port(SSH)。22 port 原本只對公司 IP 開放,代表 Security Group 的規則被改過了。
CloudWatch Logs 的其他常考功能:
| 功能 | 用途 |
|---|---|
| 保留期限 | 預設永不過期,日誌會一直累積並持續收費,應依需求設定,例如 30 天或 1 年 |
| Metric filter | 從日誌內容產生 metric,例如計算出現 ERROR 的次數,再對這個 metric 設 alarm |
| Subscription filter | 日誌一寫入就即時轉送到 Lambda、Kinesis Data Streams 或 Firehose,用於即時處理,或持續存到 S3 |
| 匯出到 S3 | 把指定時段的日誌批次匯出到 S3,不是即時的,適合長期封存 |
日誌指出了規則被改過,但沒有記錄是誰改的。下一步要查 API 操作紀錄。
用途:記錄每一次對 AWS 的操作是誰做的,用於資安調查與稽核。
下圖是同一次修改中,CloudTrail 與下一節的 AWS Config 各自記錄的部分:CloudTrail 記錄「動作」,Config 記錄動作前後「資源的狀態」。
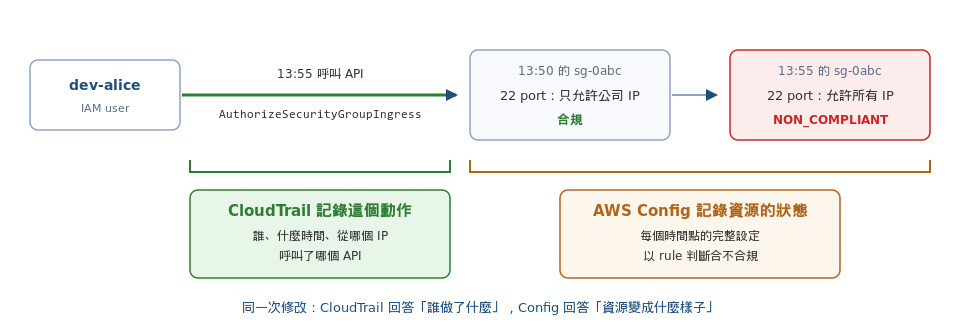
在 AWS 上的每一個操作,不論來自主控台、CLI 還是程式,最後都是一次 API 呼叫。CloudTrail 記錄這些呼叫:哪個 IAM 身分、什麼時間、從哪個 IP、呼叫了哪個 API、參數和結果。
值班人員在 CloudTrail 的 event history 中篩選 AuthorizeSecurityGroupIngress(新增 Security Group inbound 規則的 API),找到 13:55 IAM user dev-alice 對 0.0.0.0/0 開放 22 port 的紀錄。Event history 預設啟用,可以查詢過去 90 天的管理事件,不需要任何設定。
事件調查之外,CloudTrail 的設定還有幾個常考的地方:
| 功能 | 說明 |
|---|---|
| Trail | 要保存超過 90 天或集中分析,就建立 trail,把事件持續寫到 S3(也可同時送到 CloudWatch Logs)。trail 可以涵蓋所有 Region;organization trail 涵蓋 Organizations 中的所有帳號 |
| 管理事件與資料事件 | 管理事件是對資源本身的操作(建立 EC2、修改 Security Group),預設記錄。資料事件是對資源內容的操作,例如讀寫 S3 物件、呼叫 Lambda 函式,數量龐大,預設不記錄,要在 trail 上另外啟用並付費 |
| Log file integrity validation | 為寫到 S3 的日誌檔產生數位簽章的摘要檔,可以驗證日誌寫入後有沒有被修改或刪除 |
| CloudTrail Insights | 偵測 API 呼叫量的異常,例如某個 API 突然被大量呼叫 |
如果這次被刪除的是 S3 bucket 中的物件,event history 就查不到:刪除物件屬於資料事件,必須事先在 trail 上啟用才會被記錄。
CloudTrail 回答了「誰在什麼時間呼叫了哪個 API」。至於規則改動前後的完整內容、這個設定違反了哪條公司規定,要看 AWS Config。
用途:保存每個資源的設定歷史,並持續檢查設定是否符合公司規定。
AWS Config 持續記錄每個資源的設定,形成時間軸。在 Config 中打開 sg-0abc 的時間軸,可以看到 13:55 前後的完整規則:inbound 的 22 port 從「只允許公司 IP」變成「允許所有 IP」。三個月前任何一個時間點的設定,也都能這樣查到。
Config 的另一半是 Config rules:定義合規的設定應該是什麼,Config 在設定變更時或定期評估每個資源。公司已啟用「Security Group 不能對 0.0.0.0/0 開放 22 port」的 rule,所以 13:55 規則一被修改,sg-0abc 就被判定為不合規(NON_COMPLIANT)。
| 項目 | 說明 |
|---|---|
| Managed rules | AWS 預先寫好的規則,例如「EBS volume 必須加密」「Security Group 不能對 0.0.0.0/0 開放 22 port」 |
| Custom rules | 用 Lambda 撰寫自己的判斷邏輯 |
| Remediation | 不合規時,自動執行 Systems Manager Automation 文件修正,例如自動移除過度開放的規則 |
| Aggregator | 把多個帳號、多個 Region 的合規狀態彙整到一個帳號查看 |
Config 不會阻止變更發生,它是在變更之後記錄、評估、通知或修正;要在事前阻止,靠的是 IAM policy 或 SCP。另外,Config 是以 Region 為單位啟用與記錄的。
這次事件從規則被修改到值班人員收到通知,中間隔了 5 分鐘以上,而且是等到 CPU 升高才發現。把上面的服務組合起來,下次可以在變更發生時就處理:
| 目的 | 做法 |
|---|---|
| 規則一被修改就通知 | EventBridge rule 比對 CloudTrail 記錄的 AuthorizeSecurityGroupIngress 事件,立即送到 SNS |
| 違規的規則自動移除 | Config rule 搭配 remediation,自動移除對 0.0.0.0/0 開放的 22 port |
| 從一開始就不允許這種修改 | IAM policy 或 SCP 拒絕開發人員修改正式環境的 Security Group |
三個服務的分工,以及考題中對應的關鍵字:
| 服務 | 記錄的對象 | 考題關鍵字 |
|---|---|---|
| CloudWatch | metric 與日誌 | CPU、記憶體、延遲、告警、日誌查詢 |
| CloudTrail | API 呼叫 | 誰刪除了、誰修改了、稽核紀錄 |
| AWS Config | 資源的設定 | 合規、設定歷史、自動修正不合規的資源 |
摘要:CloudWatch 看效能和狀態,CloudTrail 看誰做了什麼,Config 看設定變成什麼樣子、合不合規。EC2 的記憶體要靠 CloudWatch agent;CloudTrail 的資料事件要另外開啟;Config 只在事後評估,不會阻止變更。
某公司的 Java 應用程式部署在 Auto Scaling group 中的 EC2 上,效能瓶頸在記憶體:記憶體使用率超過 80% 時,回應時間會明顯變慢,但這時 CPU 使用率通常只有 30% 左右。目前的 scaling policy 以 CPU 使用率為依據,尖峰時沒有及時增加 instance。
哪一個方案能以最低的維運負擔,讓 Auto Scaling 依記憶體使用率擴展?
某公司 Amazon S3 bucket 中的一批合約檔案在某天夜裡被刪除。帳號已啟用 CloudTrail 的 event history,但調查人員在裡面找不到任何刪除這些物件的紀錄。法務部門要求從現在起,所有對這個 bucket 中物件的刪除都要能查出是哪個 IAM 身分在何時執行,並將紀錄集中保存。
哪一個方案能以最少的設定滿足這項要求?
某公司以 AWS Organizations 管理 40 個帳號。資安政策規定:EBS volume 必須加密,Security Group 不可對 0.0.0.0/0 開放 22 port。資安團隊需要持續查看所有帳號的合規狀態與變更歷史,提供給稽核人員;開放 22 port 的規則被建立時,要自動移除。
哪一個方案的維運負擔最低(LEAST operational overhead)?
某公司把應用程式日誌送到 Amazon CloudWatch Logs,每天約 200 GB,log group 的保留期限維持預設值。工程師只會用 Logs Insights 查詢最近 30 天的日誌;但法規要求日誌要保存 7 年,超過 30 天的日誌只有在稽核時才可能需要取出,取出可以等上數小時。
哪一個方案最符合成本效益(MOST cost-effective)?
某公司在一台 EC2 上執行無法做成叢集的授權軟體,這台 instance 使用 EBS volume,不使用 instance store;當初依公司的啟動範本停用了 EC2 預設的 simplified automatic recovery。過去發生過底層硬體故障,instance 無法回應,直到隔天早上才有人發現並處理。公司要求改以 CloudWatch alarm 控制恢復:硬體故障時 instance 要自動在其他硬體上恢復,並保留原本的私有 IP;同時通知維運團隊。
哪兩項做法能最快(as quickly as possible)達成這些要求?(選擇兩項)
StatusCheckFailed_System 建立 CloudWatch alarm,並設定 EC2 的 recover 動作自動恢復 instanceStatusCheckFailed_Instance 建立 CloudWatch alarm,並設定 EC2 的 recover 動作自動恢復 instance記憶體使用率是作業系統內部的數字,EC2 預設的 metric 沒有它,必須安裝 CloudWatch agent 才會送出。把安裝與設定寫進 launch template,Auto Scaling 新開的每台 instance 都會自動送出記憶體 metric;再以這個 metric 建立 target tracking policy,Auto Scaling 就會讓平均記憶體使用率維持在目標值附近,不需要額外維護任何程式。
B 是常見的誤解:detailed monitoring 只是把既有 metric 的頻率從 5 分鐘改為 1 分鐘,並不會多出記憶體使用率。C 用 CPU 間接推估,題目說記憶體壓力出現時 CPU 只有 30%,兩者沒有穩定的關係,門檻降到 25% 還會讓非尖峰時段也維持過多的 instance。D 能運作,但要自己維護 cron 腳本、S3 與 Lambda 的整條流程,還繞過了 Auto Scaling 內建的擴展政策,維運負擔最高。
刪除 S3 物件屬於 CloudTrail 的資料事件,預設不記錄,所以 event history 裡找不到。建立一個 trail,把事件寫到集中的 S3 bucket,並在 trail 上針對這個 bucket 啟用 S3 資料事件,之後每一次 DeleteObject 都會記錄呼叫者的 IAM 身分、時間與來源 IP。
A 的 Config 記錄的是 bucket 本身的設定(例如是否啟用 Versioning),不會記錄個別物件被誰刪除。C 的 request metrics 只有數量,能知道「刪除變多了」,但不知道是誰刪的。D 是最有誘惑力的干擾項:建立 trail、集中保存的方向都對,但 management events 只記錄 bucket 層級的操作,例如建立或刪除 bucket、修改 bucket policy;DeleteObject 這類物件層級的操作屬於資料事件,沒有另外啟用就不會被記錄,這也正是 event history 裡找不到紀錄的原因。
AWS Config 的 managed rules 已經涵蓋這兩項檢查(EBS 加密、Security Group 不可開放 22 port),會持續評估並保存每個資源的合規狀態與設定歷史,正是稽核需要的資料;aggregator 把 40 個帳號的結果彙整在一處,SSM Automation 的 remediation 可以在偵測到違規規則時自動移除。全部都是內建功能,不需要撰寫程式。
A 能即時偵測並移除,但檢查與移除的邏輯要自己寫、自己維護,而且沒有現成的合規狀態與設定歷史可以交給稽核。B 只差一步:合規狀態、設定歷史與跨帳號彙整都有了,但違規規則要靠人工移除,不符合「自動移除」的要求。C 的 Trusted Advisor 有檢查開放 port 的項目,但它只是定期報告,沒有自動修正,也沒有資源的設定變更歷史。
最近 30 天要用 Logs Insights 查詢,所以這段時間留在 CloudWatch Logs;保留期限設為 30 天,之後自動刪除,不再支付 CloudWatch Logs 的儲存費。subscription filter 經 Firehose 把每一筆日誌持續寫入 S3,再以生命週期規則轉到 Glacier Deep Archive,這是 7 年長期保存成本最低的方式,題目也接受取出需要數小時。Firehose 會多一筆依資料量計算的傳送費,但遠低於在 CloudWatch Logs 長期存放的費用。
A 最省事,但 7 年的日誌全部以 CloudWatch Logs 的儲存單價存放,資料量每年都在累積,長期下來遠高於 Glacier Deep Archive。(若想降低寫入費,可以考慮 Infrequent Access log class,但它只能在建立 log group 時指定,而且不支援 subscription filter。)B 在 30 天後日誌就被刪除,等到稽核時已經沒有超過 30 天的日誌可以匯出,違反保存 7 年的規定。D 一樣讓日誌永久留在 CloudWatch Logs,又多存一份在 S3 Standard,等於付兩份儲存費。
StatusCheckFailed_System 反映的是底層硬體與網路的問題。對它建立 alarm 並設定 recover 動作,硬體故障時 EC2 會被移到另一台健康的主機上,保留原本的 instance ID、私有 IP 與 EBS volume,通常在幾分鐘內完成。同一個 alarm 再加上 SNS 動作,維運團隊會同時收到通知。兩項分別滿足「自動恢復」與「通知」。(補充:EC2 對支援的 instance 類型預設就會啟用 simplified automatic recovery,硬體故障時不需要 alarm 也會自動恢復;這題因為已停用預設功能,才需要以 alarm 設定。)
C 的 Config 評估的是設定是否合規,不是 instance 的即時健康狀態,偵測與修正都不夠快。D 只差一個字,是最容易選錯的干擾項:StatusCheckFailed_Instance 反映的是 instance 內部(作業系統、網路設定)的問題,搬到其他硬體也解決不了,所以 recover 動作只能搭配 StatusCheckFailed_System 的 alarm。E 可以運作,但要自己維護程式,而且以 AMI 啟動的是一台新的 instance,私有 IP 會改變,違反保留私有 IP 的要求。


 iThome鐵人賽
 看影片追技術