
災難復原(disaster recovery,DR) 處理的是最壞的情況發生後,怎麼把系統和資料救回來。它和高可用(high availability)是兩件事:高可用處理元件故障時服務不中斷,例如 RDS Multi-AZ、跨 AZ 的 Auto Scaling group;但有兩種災難是高可用擋不住的:
這篇依序整理 DR 的兩個衡量指標、四種策略、AWS 上實作它們的服務,最後是把地端資料庫遷移到 AWS 的 DMS。
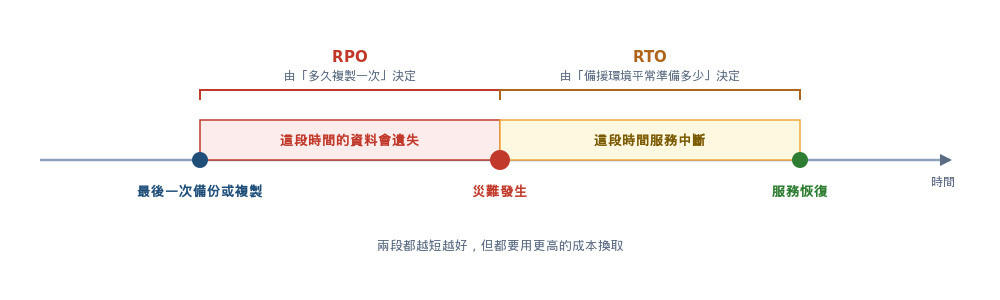
以災難發生的時間點為基準,往前看和往後看各有一個指標:
| 指標 | 定義 | 回答的問題 | 例子 |
|---|---|---|---|
| RPO(Recovery Point Objective) | 可以接受遺失多長時間內的資料 | 救回來的資料停在什麼時間點 | 每天凌晨備份一次,RPO 就是 24 小時:最壞情況會遺失將近一天的資料 |
| RTO(Recovery Time Objective) | 可以接受服務中斷多久 | 多快能恢復服務 | RTO 4 小時:災難發生後 4 小時內要恢復對外服務 |
RPO 由「資料多久複製一次」決定,RTO 由「備援環境平常準備到什麼程度」決定。兩個數字都是業務單位依影響程度訂出來的,數字越小,代表越不能接受遺失和中斷,成本也越高。
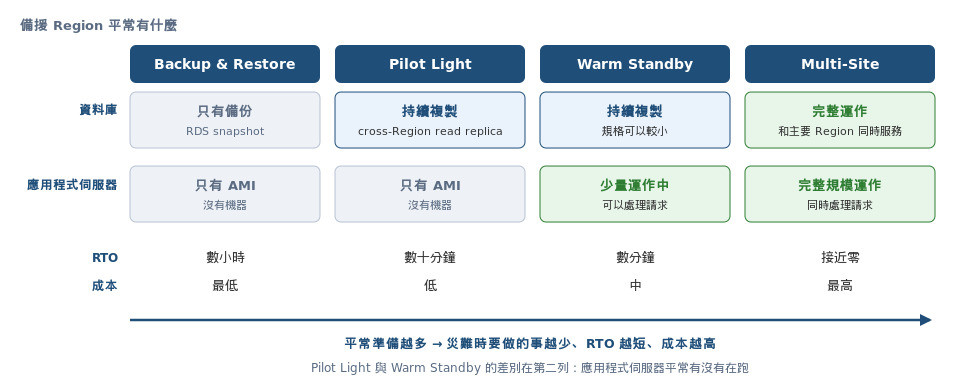
AWS 把 DR 策略分成四種,差別在於平常就在備援 Region 準備好多少東西。以一個「ALB+EC2+RDS」的網站為例:
| 策略 | 備援 Region 平常有什麼 | 災難發生後要做的事 | RPO/RTO | 成本 |
|---|---|---|---|---|
| Backup & Restore | 只有備份(RDS snapshot、AMI、S3 資料的副本) | 從備份建立整套環境:建資料庫、開機器、設定網路 | 數小時 | 最低 |
| Pilot Light | 資料持續複製(例如 RDS cross-Region read replica),機器只有 AMI,不開機 | 把 read replica 升級為主要資料庫,啟動 EC2、擴展到正式規模 | 數十分鐘 | 低 |
| Warm Standby | 一套縮小規模但完整運作的環境(少量 EC2、較小的資料庫),資料持續複製 | 把縮小的環境擴展到正式規模,把流量切過去 | 數分鐘 | 中 |
| Multi-Site(active/active) | 一套完整規模的環境,平常就和主要 Region 一起服務使用者 | 停止把流量送到故障的 Region | 接近零 | 最高 |
從左到右,平常準備的越多,災難時要做的事越少,RTO 越短,成本也越高。選擇的依據是業務訂出的 RPO 和 RTO:先找出能滿足這兩個數字的策略,再在其中選成本最低的。
Pilot Light 和 Warm Standby 最容易混淆,差別在應用程式伺服器平常有沒有在跑:Pilot Light 只有資料庫在複製,伺服器只有 AMI,災難時要先建立伺服器才能開始服務;Warm Standby 的伺服器平常就少量在跑、可以處理請求,災難時只要擴展規模、切換流量。
一套系統要能在另一個 Region 復原,資料、運算、流量入口三層都要準備:
| 層 | 服務與做法 | 複製方式 |
|---|---|---|
| 物件資料 | S3 Cross-Region Replication(CRR) | 新物件非同步複製到另一個 Region 的 bucket |
| 關聯式資料庫 | RDS cross-Region read replica;RDS 自動備份複製到另一個 Region | 非同步複製;read replica 可升級為主要資料庫 |
| 關聯式資料庫(Aurora) | Aurora Global Database | 專用的儲存層複製,跨 Region 延遲通常低於 1 秒;故障時可在約 1 分鐘內把次要 Region 升級為主要 |
| NoSQL | DynamoDB global tables(Day 13) | 多個 Region 都可讀寫,雙向同步 |
| 運算 | AMI 複製到另一個 Region;Auto Scaling group 平常設得很小或為 0 | 災難時調高 desired capacity |
| 基礎架構 | CloudFormation 範本 | 用同一份範本在另一個 Region 建出相同的網路、權限與資源 |
| 流量入口 | Route 53 failover 記錄搭配 health check(Day 15) | 主要 Region 失敗時,DNS 改回應備援 Region |
Backup & Restore 只需要把各層的備份(snapshot、AMI、S3 副本)放到備援 Region;Pilot Light 還需要資料庫持續複製;Warm Standby 和 Multi-Site 則需要每一層都在運作。
EBS、RDS、DynamoDB、EFS、S3 各自都有備份功能,但設定分散在各個服務裡,很難確認「每一個該備份的資源都有備份、保留期限都符合規定」。
AWS Backup 用一份 backup plan 集中管理:
| 設定 | 說明 |
|---|---|
| 備份頻率與時段 | 例如每天凌晨 2 點 |
| 保留期限與生命週期 | 例如保留 35 天,30 天後轉到成本較低的 cold storage |
| 套用對象 | 依 tag 指定,例如所有 backup=daily 的資源,新建的資源只要加上 tag 就自動納入 |
| 跨 Region 複製 | 備份完成後自動複製一份到另一個 Region,供 Region 災難時還原 |
| 跨帳號複製 | 搭配 AWS Organizations,把備份複製到另一個帳號的 backup vault |
備份存放在 backup vault 裡。針對勒索軟體與內部人員誤刪,可以啟用 Backup Vault Lock:以 compliance mode 鎖定後,保留期限內任何人都無法刪除備份或縮短保留期限,包括帳號的 root user。再搭配跨帳號複製,即使生產帳號的權限被取得,另一個帳號裡的備份仍然安全。
誤刪資料這類災難,除了還原整份備份,RDS 還有 point-in-time recovery:自動備份搭配交易紀錄,可以還原到保留期限內(最長 35 天)的任一秒,例如回到誤刪資料表的前一刻。
上面的做法適用於已經在 AWS 上、使用受管服務的系統。地端的伺服器,或是自己在 EC2 上安裝的應用程式,要達到「秒級 RPO、分鐘級 RTO」,自己做 Pilot Light 很繁瑣。
AWS Elastic Disaster Recovery(DRS) 在每台來源伺服器上安裝代理程式,把磁碟以區塊層級持續複製到 AWS:
平常:  來源伺服器 ──持續複製──▶ AWS 上低成本的 staging 區(只有小型複寫伺服器和便宜的磁碟)
災難時:從複製的資料啟動完整規模的 EC2,幾分鐘內接手服務
恢復後:把資料反向複製回原本的環境(failback)
平常只需要付 staging 區的費用,不必維持一整套運作中的環境,成本接近 Pilot Light,RPO 卻能達到秒級。
DR 是把系統準備好隨時接手;遷移則是把地端的系統正式搬到 AWS。遷移資料庫的困難在於資料一直有新的寫入:如果先停機、匯出、傳輸、匯入,數 TB 的資料可能要停機好幾個小時。AWS Database Migration Service(DMS) 讓來源資料庫在遷移期間照常運作:
1. Full load:把現有資料整批複製到目標資料庫
2. CDC(change data capture):持續把來源的新變更套用到目標
3. 切換:目標追上來源後,把應用程式改連到目標,停機只發生在這一步
來源與目標是同一種資料庫引擎(例如 MySQL 到 RDS for MySQL)時,DMS 直接搬資料。引擎不同時(例如 Oracle 到 Aurora PostgreSQL),資料表結構、預存程序的語法都不相容,要先用 AWS SCT(Schema Conversion Tool)轉換 schema,再由 DMS 搬資料。
遷移時常一起出現的其他工具:
| 工具 | 用途 |
|---|---|
| AWS Application Migration Service(MGN) | 整台伺服器的遷移。和 DRS 使用相同的區塊層級持續複製技術,切換完成就結束;DRS 則長期持續複製作為備援 |
| AWS Migration Hub | 集中追蹤遷移進度的主控台,彙整 DMS、MGN 等工具的狀態,本身不搬任何東西 |
| AWS Snowball/AWS DataSync | 大量資料搬遷。頻寬有限、資料量又大時,Snowball 把資料載入實體設備寄回 AWS;網路足夠時,DataSync 線上傳輸 |
摘要:DR 的設計從 RPO 和 RTO 兩個數字開始。四種策略依平常準備的程度排列,準備越多 RTO 越短、成本越高,選能滿足數字的策略中最便宜的一個。Multi-AZ 擋不住 Region 故障和誤刪,要靠跨 Region 的複製與有保留期限的備份。
某電商的訂單資料庫是 us-east-1 的 Amazon Aurora MySQL。公司要求 Region 層級的災難發生時,遺失的資料必須控制在數秒內,並在數分鐘內由 eu-west-1 接手寫入。資料庫團隊人力有限,不希望自行維護複寫程序。
哪一個方案的維運負擔最低(LEAST operational overhead)?
某醫療機構以 AWS Backup 保護生產帳號中的 EBS、RDS 與 Amazon EFS。資安稽核指出兩個風險:擁有管理員權限的帳號一旦被入侵,攻擊者可以刪除所有備份;而且備份和生產資源位於同一個帳號。公司要求在 7 年的保留期限內,任何人都無法刪除備份,並且生產帳號遭入侵時仍能從備份還原。
哪兩項做法最能確保這些備份的安全(MOST secure)?(選擇兩項)
某製造公司的資料中心有 120 台 Windows 與 Linux 伺服器,執行多套無法修改程式碼的商用軟體。公司要以 AWS 作為災難復原站點,要求資料遺失控制在數秒內、服務在數分鐘內恢復;平常不希望在 AWS 上維持 120 台運作中的伺服器。
哪一個方案最符合這些需求,而且維運負擔最低?
某公司為 ap-northeast-1 的網站在 ap-southeast-1 建立了 Pilot Light 環境:RDS cross-Region read replica 持續複製,EC2 只有 AMI,Auto Scaling group 的 desired capacity 為 0。最近一次演練中,從啟動 EC2、安裝設定到通過健康檢查花了將近 2 小時。業務單位把 RTO 縮短為 15 分鐘,RPO 維持不變。
哪一個方案能以最低的成本達成新的 RTO?
某公司要把資料中心的 Oracle 資料庫(約 3 TB)遷移到 Amazon Aurora PostgreSQL,資料中心與 AWS 之間已有 1 Gbps 的 AWS Direct Connect。這個資料庫支撐 24 小時營運的訂單系統,遷移期間訂單會持續寫入舊資料庫,最後切換時的停機時間不能超過 10 分鐘。
解決方案架構師應該採取哪兩項做法?(選擇兩項)
Aurora Global Database 以專用的儲存層複寫把資料送到次要 Region,延遲通常低於 1 秒;災難時把 eu-west-1 的次要叢集升級為主要叢集,約 1 分鐘內就能接受寫入。複寫由 Aurora 管理,不需要自己維護任何程序,同時滿足秒級 RPO、分鐘級 RTO 和低維運負擔。
A 的 snapshot 每小時一次,最壞情況會遺失將近一小時的資料,而且從 snapshot 還原整個叢集需要較長時間,RPO 和 RTO 都不符合。B 的 Aurora Replica 都在 us-east-1 內,能處理 AZ 故障,但 Region 故障時一起無法使用。D 技術上可行,但要自己維護 DMS 的複寫執行個體、監控複寫延遲並撰寫切換程序,維運負擔明顯高於內建的 Global Database。
Backup Vault Lock 以 compliance mode 鎖定後,保留期限內任何人都無法刪除復原點或縮短保留期限,包括 root user,管理員帳號被入侵也刪不掉。跨帳號複製則把備份放到另一個獨立的帳號,生產帳號整個被入侵、甚至無法使用時,仍能從那個帳號的 vault 還原。前者解決「被刪除」,後者解決「和生產資源在同一個帳號」,兩者合起來才完整。
C 的 IAM policy 由管理員自己管理,入侵者取得管理員權限後可以直接把這個 policy 移除,擋不住題目描述的攻擊。D 是誤解:AWS Backup 的復原點存放在 backup vault 中,不是使用者可以操作的 S3 bucket,S3 的 Versioning、MFA Delete 與 bucket policy 都管不到它們。E 只設定了保留多久,沒有阻止任何人在期限內手動刪除,也沒有處理同一個帳號的風險。
Elastic Disaster Recovery 在來源伺服器上以區塊層級持續複製磁碟,不需要修改應用程式,RPO 可達秒級;平常 AWS 上只有低成本的 staging 區,災難時才從複製的資料啟動完整規模的 EC2,數分鐘內接手。120 台伺服器都用同一套代理程式與主控台管理,維運負擔低。
A 能達成 RPO 與 RTO,但違反「平常不維持 120 台運作中的伺服器」,而且每套軟體的複寫設定都要各自維護。B 的 AWS Backup 確實能備份地端 VMware 虛擬機,但每小時一次的備份代表最多遺失一小時的資料,還原成 EC2 也需要時間,達不到秒級 RPO 和分鐘級 RTO。C 是遷移工具,做的是一次性搬遷並由 AWS 正式接手,題目要的是平常仍在地端運作、AWS 作為備援。
把 Pilot Light 改成 Warm Standby:Auto Scaling group 平常就維持 2 台已安裝設定好的 EC2,掛在 ALB 後面持續通過健康檢查。災難時不再需要從零啟動和設定,只要調高 desired capacity 擴展規模、由 Route 53 failover 把流量切過來,可以在 15 分鐘內完成。平常只多付兩台 EC2 與 ALB 的費用。
A 是不存在的設定:RDS 自動備份的頻率不能調整(每天一次快照,加上自動每 5 分鐘上傳的交易日誌);而且題目的 RPO 不變,問題出在 EC2 從零啟動、安裝設定要 2 小時,資料庫早就在持續複製,備份再快對 RTO 也沒有幫助。B 是 Multi-Site,RTO 接近零,但平常維持一整套正式規模的環境,成本遠高於達成 15 分鐘所需。D 只省下建立機器的那幾分鐘:這些 EC2 用的是原始 AMI,啟動後仍要執行腳本安裝設定、通過健康檢查,而這正是原本花掉近 2 小時的部分,達不到 15 分鐘;停止狀態的 EBS volume 也持續計費。(如果把軟體預先做進 AMI,啟動時間會大幅縮短,那是另一種可行的設計,但不在選項中。)
DMS 先以 full load 複製現有的 3 TB 資料,再以 CDC 持續套用遷移期間的新訂單,目標資料庫一直追著來源;切換時只要停止寫入、等最後一批變更套用完、把應用程式改連 Aurora,停機可以壓在幾分鐘內。但 Oracle 和 PostgreSQL 是不同的資料庫引擎,資料表定義、預存程序語法不相容,必須先用 AWS SCT 轉換 schema 並在 Aurora 建好物件,DMS 才有地方寫入資料。兩項缺一不可。
A 要在停機狀態下匯出、傳輸、匯入 3 TB,即使經 1 Gbps 專線,光傳輸就要數小時,遠超過 10 分鐘。C 的 Snowball Edge 用於頻寬不足的大量搬遷,運送期間舊資料庫還在寫入新訂單,到貨後的資料已經過時,最後仍要長時間停機補資料。E 是不存在的功能:Aurora PostgreSQL 的 read replica 只能從 Aurora 或 RDS 建立,無法把地端的 Oracle 當作來源,更不能跨引擎複寫。


 iThome鐵人賽
 看影片追技術