
某天有個服務吃光了整台機器的記憶體,旁邊三個不相干的服務跟著陪葬。
問題是:K8s 怎麼會讓這種事發生?
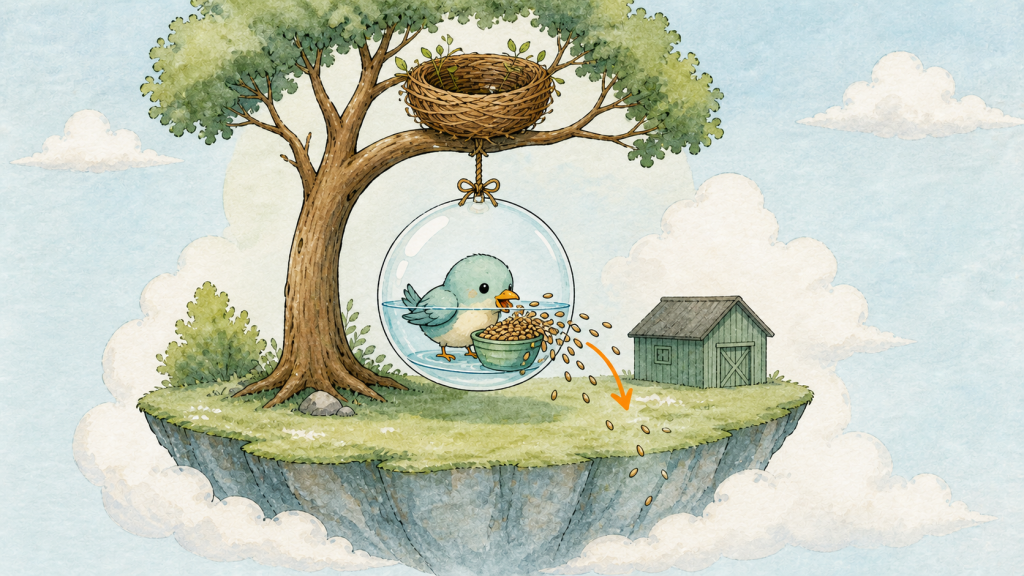
泡泡(Pod)一側掛著資源需求牌(Resource Request),另一側有一條資源上限線(Resource Limit),小鳥(Container)吃到超過上限的那一刻就被拉走。
看圖上那個飯碗,兩條線各有名字。
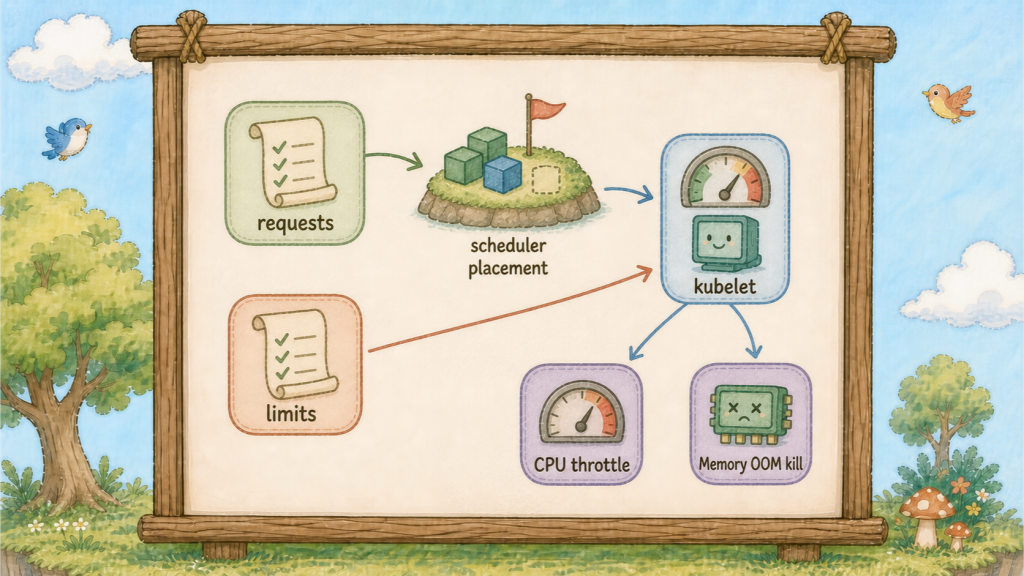
會發生慘案,是因為沒有畫線。不設限制的 Pod ,預設可以吃光整棵樹。
Request(下面那條線):我保證要吃到這麼多
這條線是給選樹官(Scheduler) 看的。
Day 4 講過 Scheduler 決定新泡泡(Pod)掛哪棵樹,它憑什麼決定?就憑這條線。
它把每棵樹上所有泡泡(Pod)的 Request 加起來,跟樹的可分配容量(Allocatable) 比一比,還放得下才把新泡泡(Pod)掛上去。
這裡最容易被誤解:一般資源 fit 判斷主要看 Request;即時實際用量屬於執行期間的觀測值,排程還會考慮 affinity、taint、topology 等條件。
一棵樹上的泡泡(Pod)實際只用了 10% 的 CPU,但 Request 加起來已經滿了,選樹官(Scheduler)就是不會再放新泡泡(Pod)進去,結果是一顆 Pending 狀態的泡泡。
Limit(上面那條線):最多只准吃到這麼多
這條線是給管家松鼠(kubelet) 看的,它負責在樹上執行。
超過會怎樣? CPU 和記憶體的下場完全不同,這個差別非常重要。
CPU 超過 → 被限速(throttle)。
CPU 是可壓縮資源,通常會被限速;但程式仍可能因 timeout、probe failure 或其他錯誤退出。
記憶體超過 → 直接被砍(OOMKilled)。
記憶體是不可壓縮的,沒辦法「少給一點」。超過 Limit 那一刻,容器直接被殺,然後重啟。
記憶體超限直接就是 OOMKilled;CPU 壓力則會被限速,搞不好順便讓服務因為逾時掛掉。
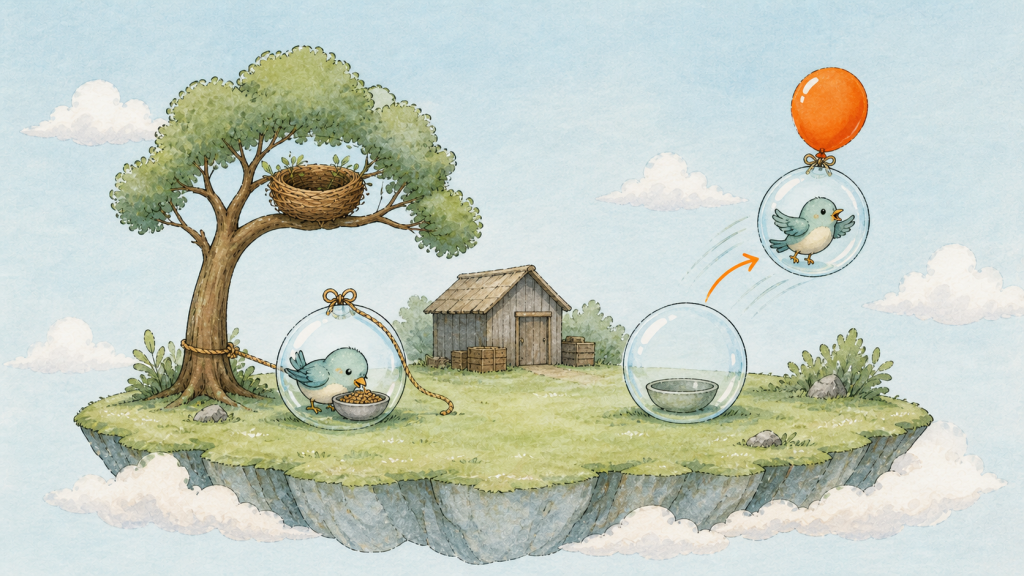
兩顆泡泡(Pod)並排:左邊的資源上限線(Resource Limit)讓小鳥(Container)吃飯速度變慢但還在吃,右邊的小鳥(Container)超過記憶體上限後直接被抓走。
不設兩條線會有兩個地雷:
① 選樹官(Scheduler) 根本不知道你吃多少,直接當你零佔用亂塞,最後大家一起餓死。
② **泡泡(Pod)**一路吃到飽把整台機器榨乾,直接把隔壁鄰居害死。
實務上的起手式:Request 應該應該監控、壓測與容量目標設定;Limit 則要依服務的 burst 特性與失敗代價評估,沒有通用的兩倍規則。
記憶體的 Request 和 Limit 可依服務的穩定用量與 burst 需求評估;超限會有被 OOM 終止的風險。
前二十四天我們的泡泡(Pod)沒畫任何線,愛吃多少吃多少。今天把碗畫上去。
先看看現在的樹被佔用了多少:
kubectl describe node hello-control-plane | grep -A6 "Allocated resources"
CPU Requests 和 Memory Requests 都很低,而且你的 hello 泡泡(Pod)一份都沒佔。選樹官(Scheduler)眼中它們是零。
改 hello-deployment.yaml,在 image 底下加這段:
          resources:
            requests:
              cpu: 50m
              memory: 64Mi
            limits:
              cpu: 200m
              memory: 64Mi
50m 是 0.05 顆 CPU(m 是千分之一顆),64Mi 是 64 MiB。記憶體的 request 和 limit 設一樣,照上面那個建議。
kubectl apply -f hello-deployment.yaml
kubectl rollout status deployment/hello
kubectl describe node hello-control-plane | grep -A6 "Allocated resources"
數字上去了。選樹官(Scheduler)現在知道你佔多少位子。
看看它怎麼被記錄的:
kubectl get pod -l app=hello -o jsonpath='{.items[0].spec.containers[0].resources}{"\n"}'
裝 metrics-server 才看得到實際用量。這也是明天 HPA 要用的東西,今天先裝:
kubectl apply -f https://github.com/kubernetes-sigs/metrics-server/releases/download/v0.7.2/components.yaml
kubectl patch deployment metrics-server -n kube-system --type=json \
  -p='[{"op":"add","path":"/spec/template/spec/containers/0/args/-","value":"--kubelet-insecure-tls"}]'
kubectl wait --for=condition=available --timeout=90s deployment/metrics-server -n kube-system
那個 patch 是 Kind 專用的:Kind 的樹用自簽憑證,不加這個參數 metrics-server 會一直連不上。
等三十秒讓它收集第一批數據,然後:
kubectl top nodes
kubectl top pods
實際用量出來了。 你會發現 hello 泡泡(Pod)的 CPU 幾乎是 0m、記憶體大概 4Mi ── 遠低於你設的 Request。這很正常,Request 是預留的位子,不是實際的消耗。
現在做那個經典實驗:把記憶體撐爆。 建立 oom-demo.yaml,一顆故意吃太多的泡泡(Pod):
apiVersion: v1
kind: Pod
metadata:
  name: oom-demo
spec:
  containers:
    - name: oom-demo
      image: polinux/stress
      command: ["stress"]
      args: ["--vm", "1", "--vm-bytes", "250M", "--vm-hang", "1"]
      resources:
        requests:
          memory: "64Mi"
        limits:
          memory: "64Mi"
stress 這個工具唯一的作用就是把資源吃滿,--vm-bytes 250M 是「配置 250 MB 記憶體」。它的 Limit 只有 64Mi,所以一定會撞牆。
kubectl apply -f oom-demo.yaml
盯著看:
kubectl get pod oom-demo -w
幾秒後:
oom-demo   0/1   OOMKilled   0
oom-demo   0/1   CrashLoopBackOff   1
OOMKilled。 不是變慢,是直接被砍。Ctrl+C 離開。
看死因:
kubectl get pod oom-demo -o jsonpath='{.status.containerStatuses[0].lastState.terminated.reason}{" "}{.status.containerStatuses[0].lastState.terminated.exitCode}{"\n"}'
OOMKilled 137。(要看 lastState 而不是 state,因為它已經被重啟了,現在這一輪還活著 ── 死因記錄在「上一輪」。)

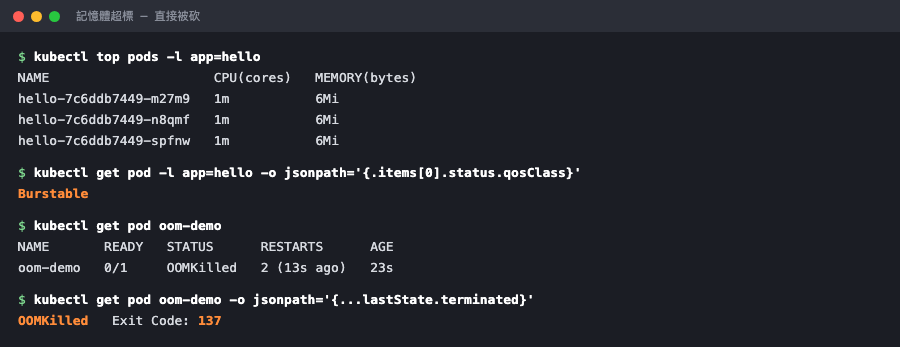
實際用量遠低於 Request(6Mi vs 64Mi)很正常;下面那顆撞到上限的,死因寫得清清楚楚。
137 這個數字記起來,它就是「被 SIGKILL 砍掉」的意思,你之後查問題會一直遇到它。
收工:
kubectl delete -f oom-demo.yaml
最後認識一個你不設也會被貼上的標籤。K8s 會依你怎麼畫線,把泡泡(Pod)分成三個等級:
kubectl get pod -l app=hello -o jsonpath='{.items[0].status.qosClass}{"\n"}'
印出 Burstable。三個等級是這樣分的:Request 和 Limit 完全相等是 Guaranteed(最不容易被犧牲)、有設但不相等是 Burstable、什麼都沒設是 BestEffort(最先被犧牲)。
當機器真的撐不住時,管家松鼠(kubelet) 會從最外圍的等級開始清場。未設定資源的服務同時缺少預留最沒保障,第一個被趕下車。
你今天的設定是 Burstable(因為 CPU 的 Request 與 Limit 不一樣)。想升到 Guaranteed,必須讓 CPU 與記憶體的 Request 和 Limit 全部兩兩相等才行。
CPU 超標會變慢,記憶體超標會被砍。


 iThome鐵人賽
 看影片追技術