

黑熊俠客 Face Landmarker 邀請同門師兄來到府裡。
老爺想藉此機會看看,哪一位俠客最有長輩緣:
最適合帶長輩做暖身操,帶長輩跟著音樂動一動。
今天先來認識四位來自 MediaPipe 的俠客:Google MediaPipe Pose、Hand、Gesture、Holistic
| 同門 | 看什麼 | 模型檔(.task) | Model Maker | 官方指南 |
|---|---|---|---|---|
| Hand Landmarker | 每隻手 21 點,分左右手 | 7.8 MB | 官方沒列 | Android、iOS、Web、Python |
| Gesture Recognizer | 手的 21 點+7 種手勢 | 8.4 MB | 可以 | Android、iOS、Web、Python |
| Pose Landmarker | 全身 33 點 | lite 5.8 MB、full 9.4 MB、heavy 30.7 MB | 官方沒列 | Android、iOS、Web、Python |
| Holistic Landmarker | 臉 478+身體 33+雙手 42,共 553 點 | 13.7 MB | 官方沒列 | Android、iOS、Web、Python |
Model Maker:Google 提供的工具,讓開發者可以拿自己的資料,
重新訓練 MediaPipe 的模型,例如教 Gesture 認新的手勢。
官方目前已標示不再積極維護(Deprecated)。
官方說明,Hand 裡面包了兩個模型:
手掌偵測(palm detection):在整個畫面裡找手。手部特徵點(hand landmarks):在找到的手上,標出 21 個特徵點。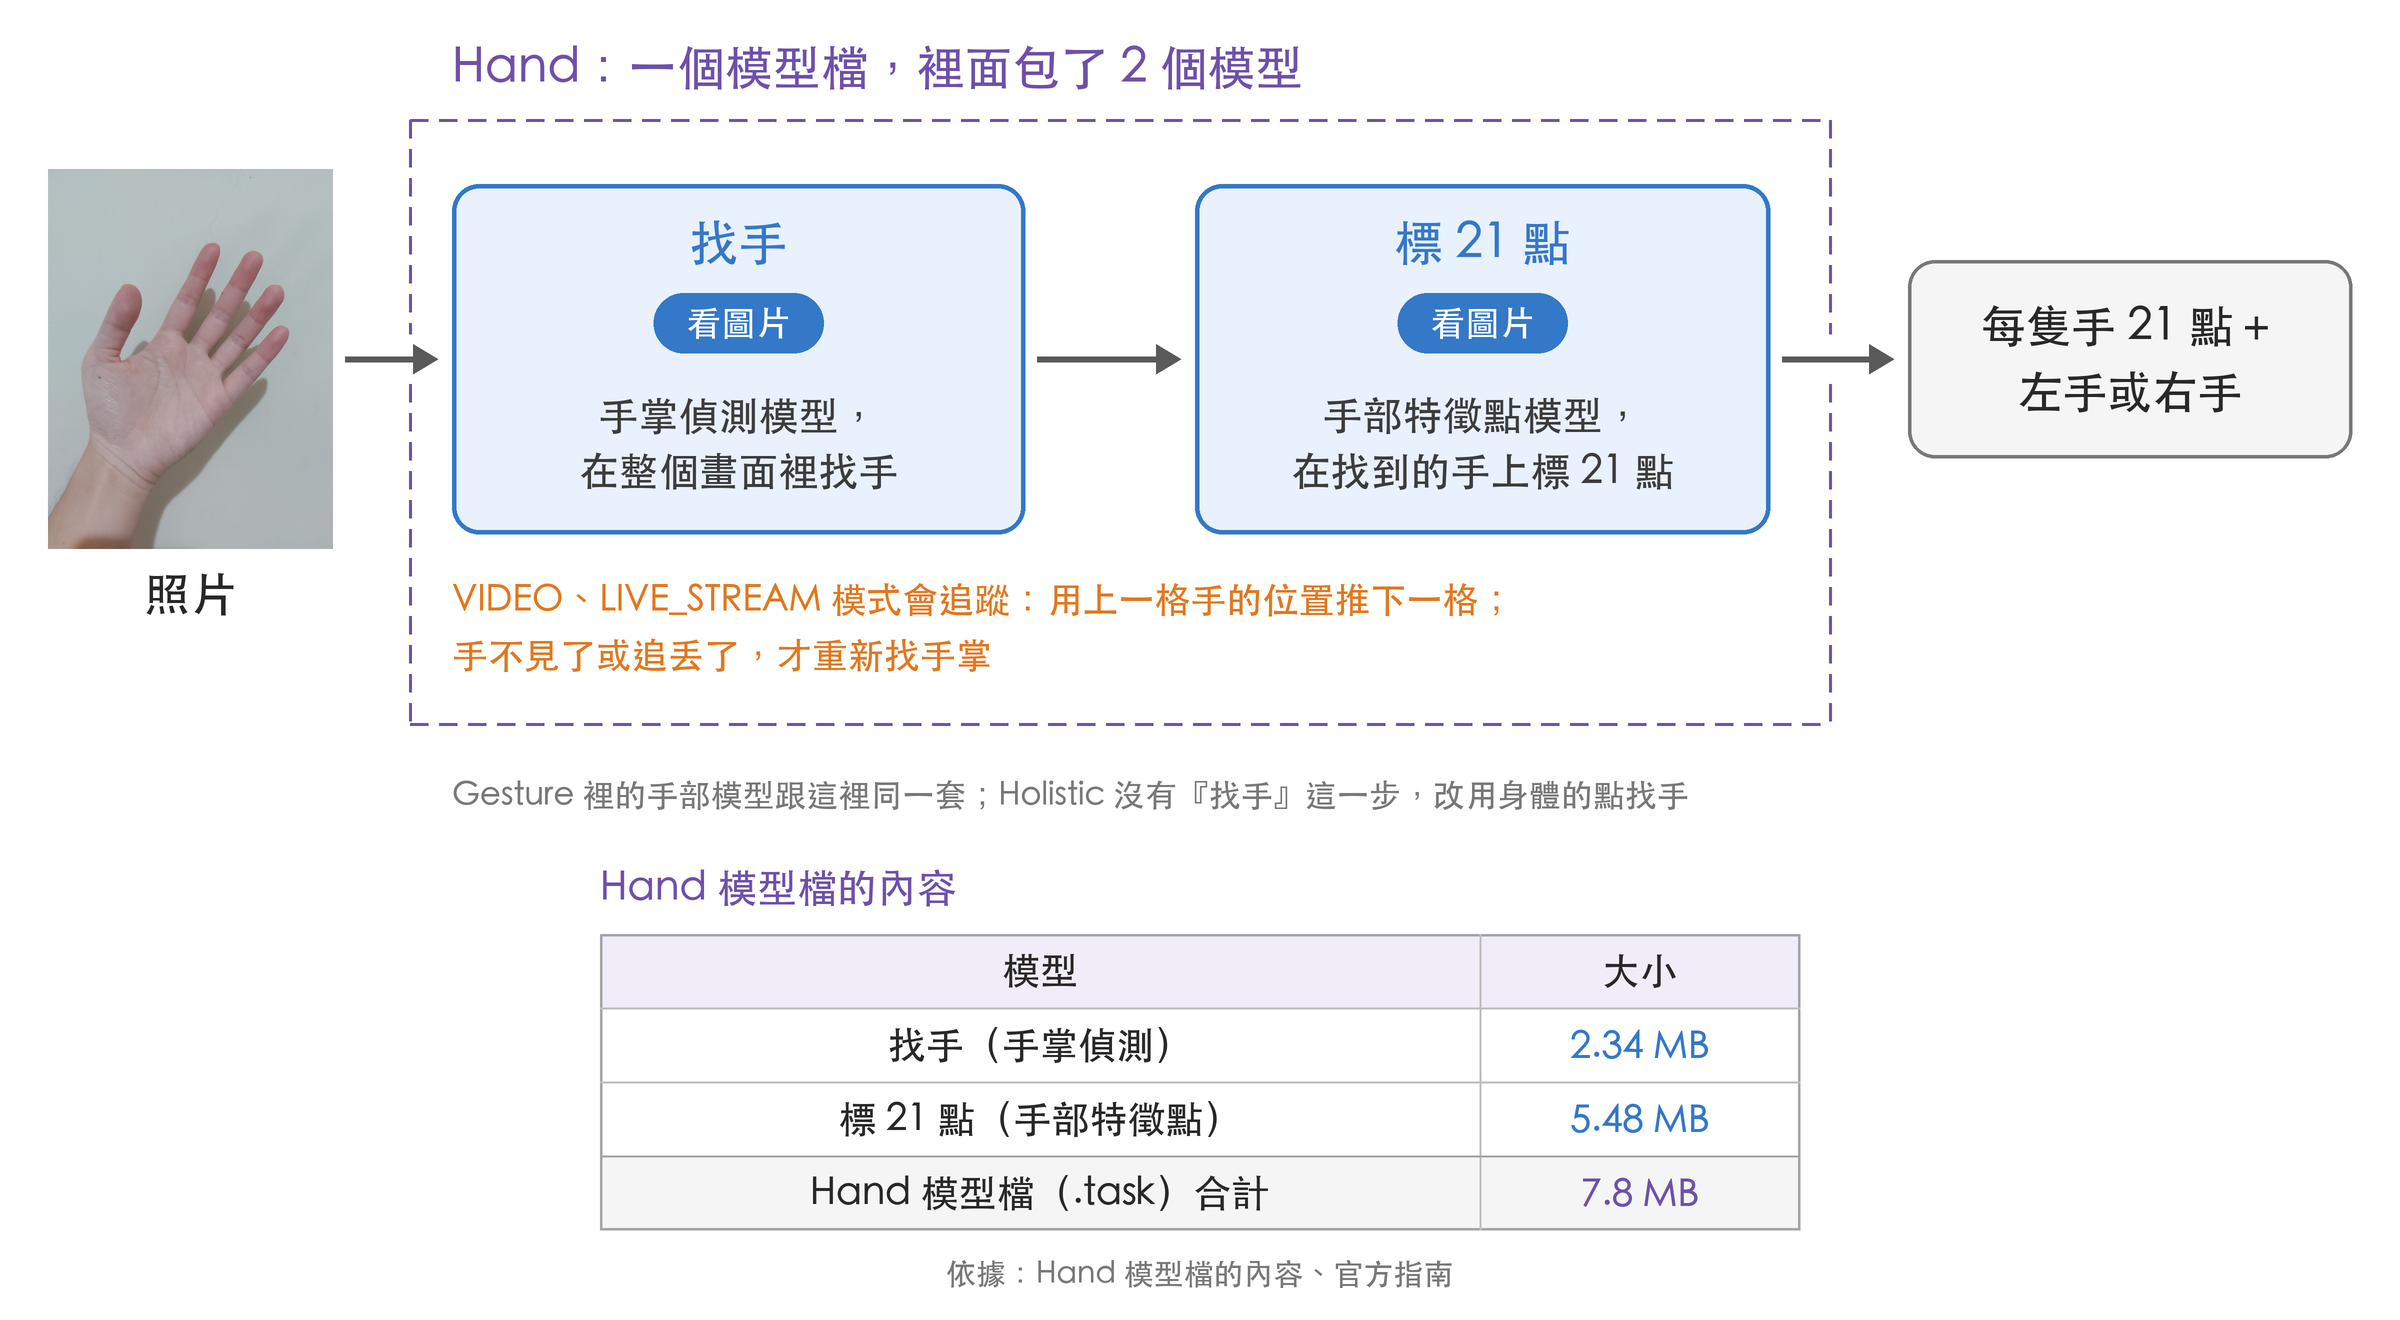
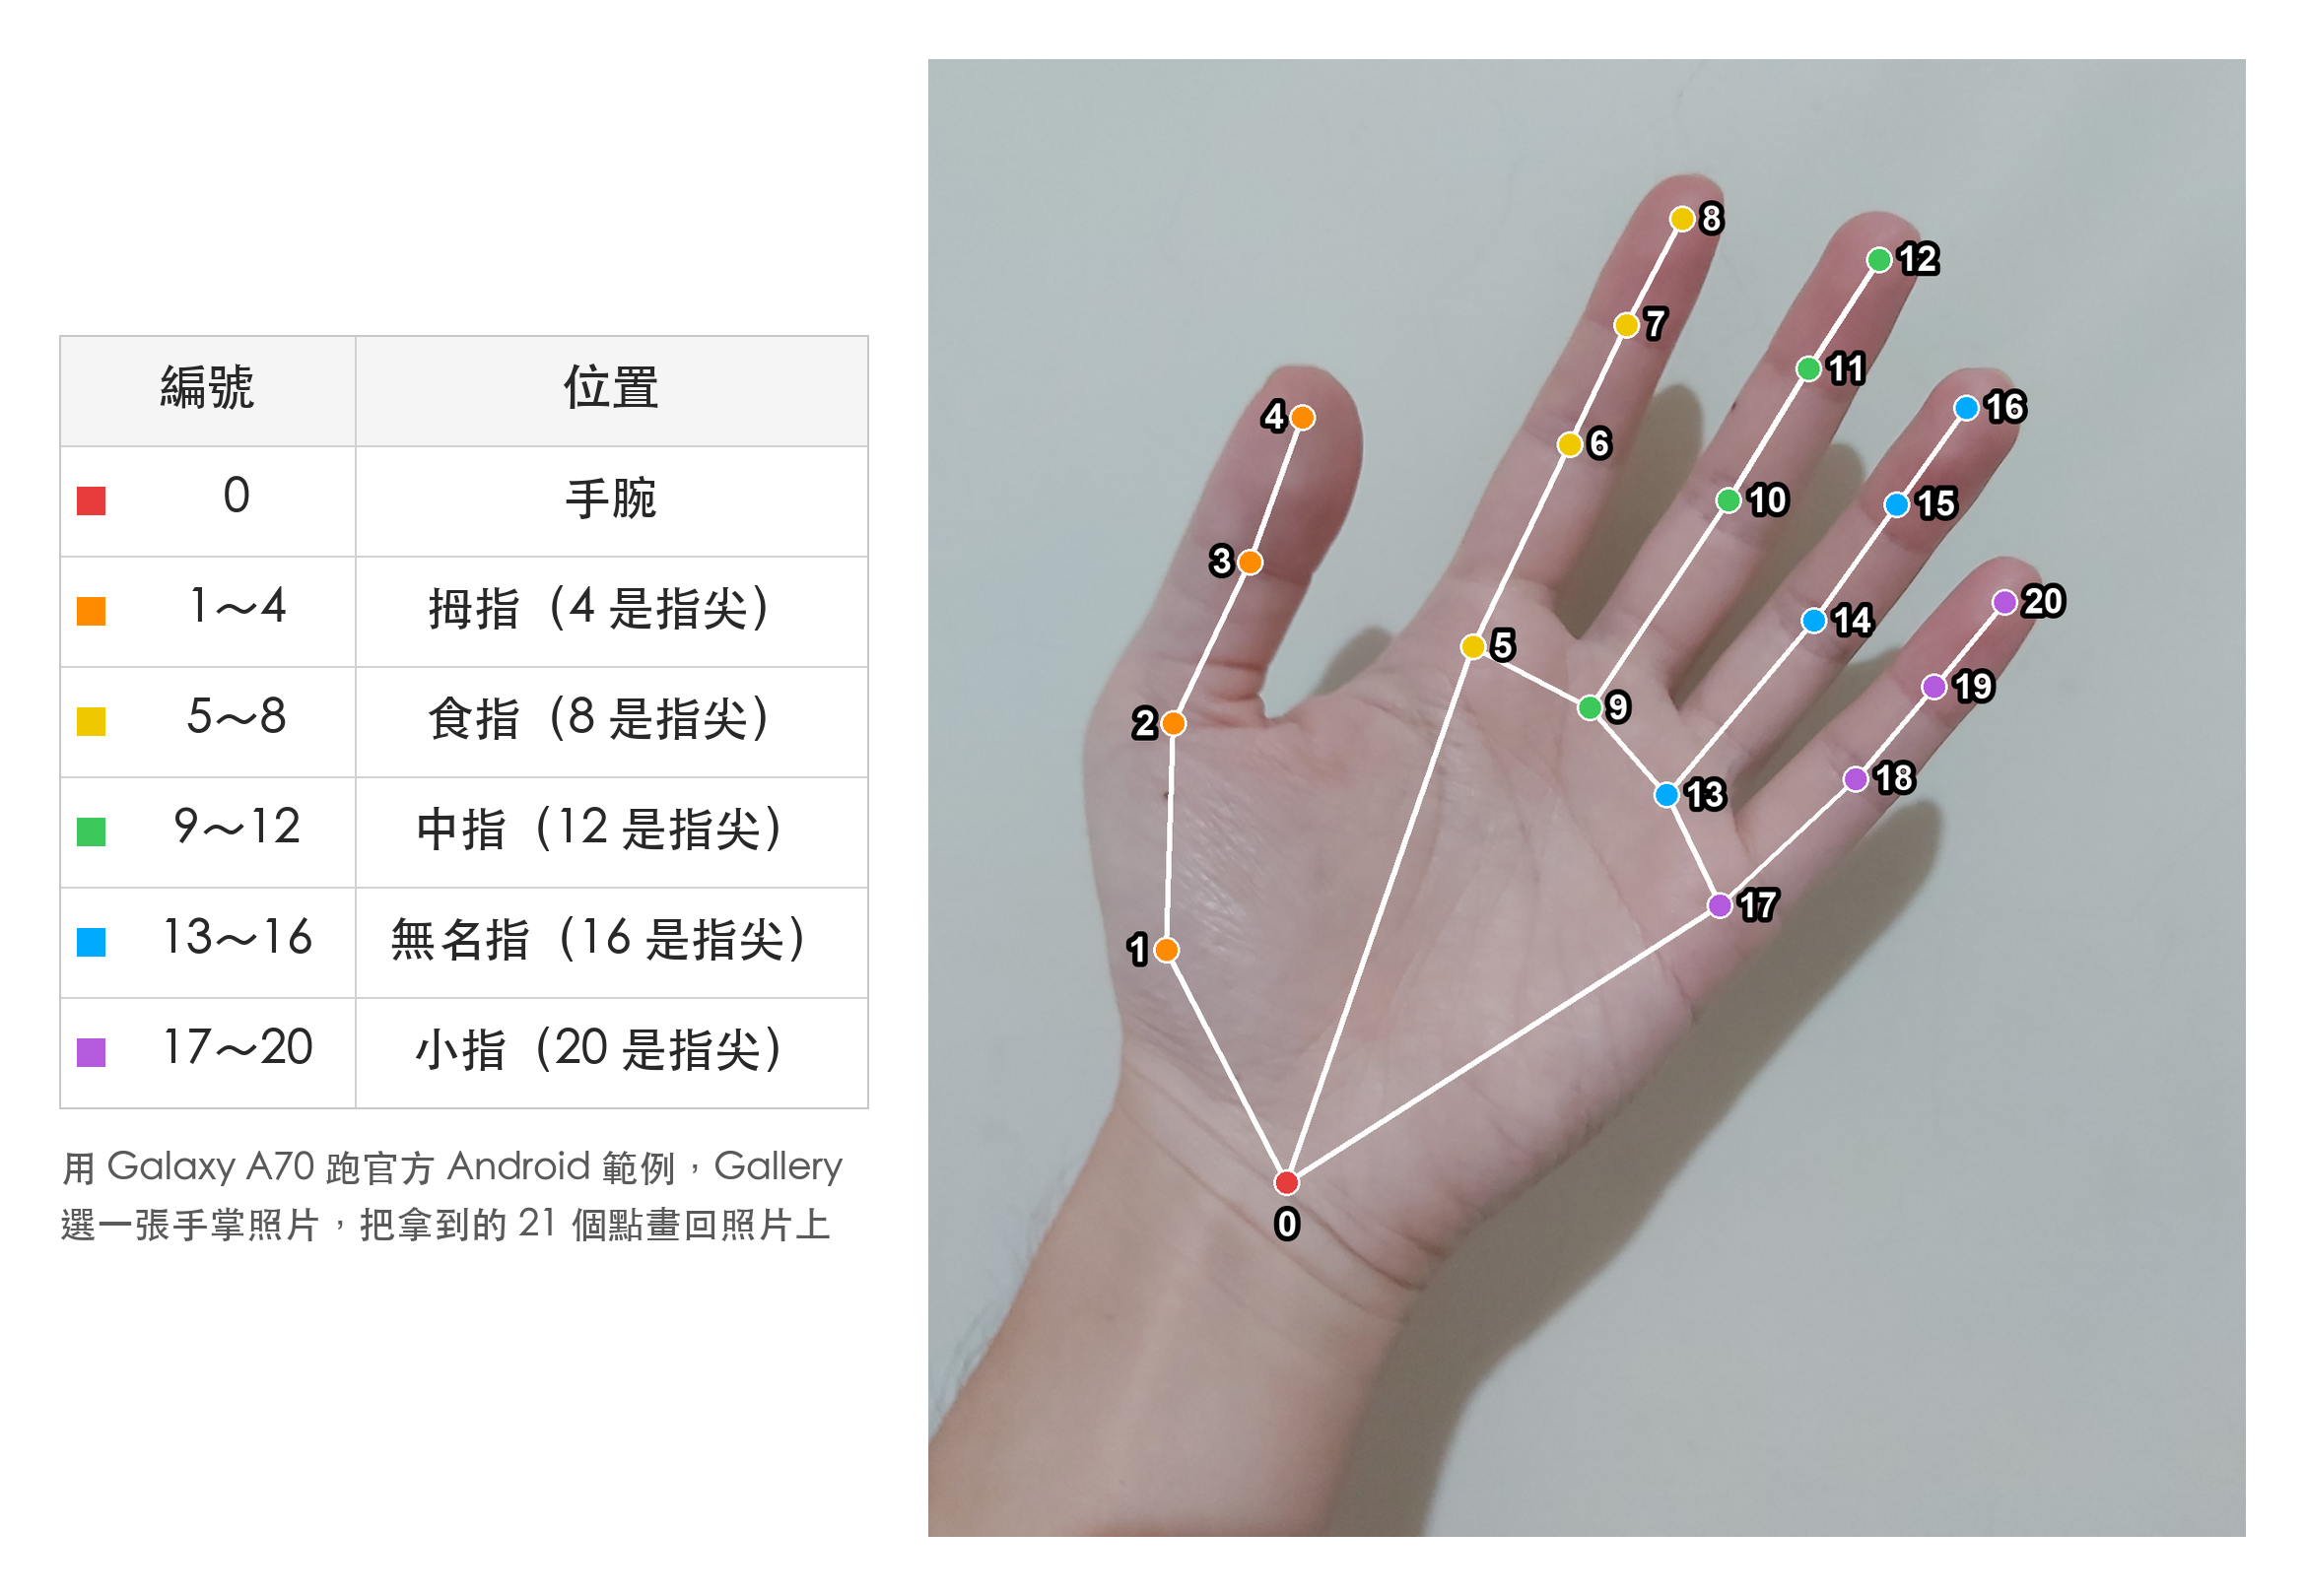
官方說明,Gesture 是兩組模型疊起來:
手部特徵點模型:跟 Hand 同一套,先找手掌、再標 21 個特徵點。手勢分類模型:這裡會分兩步,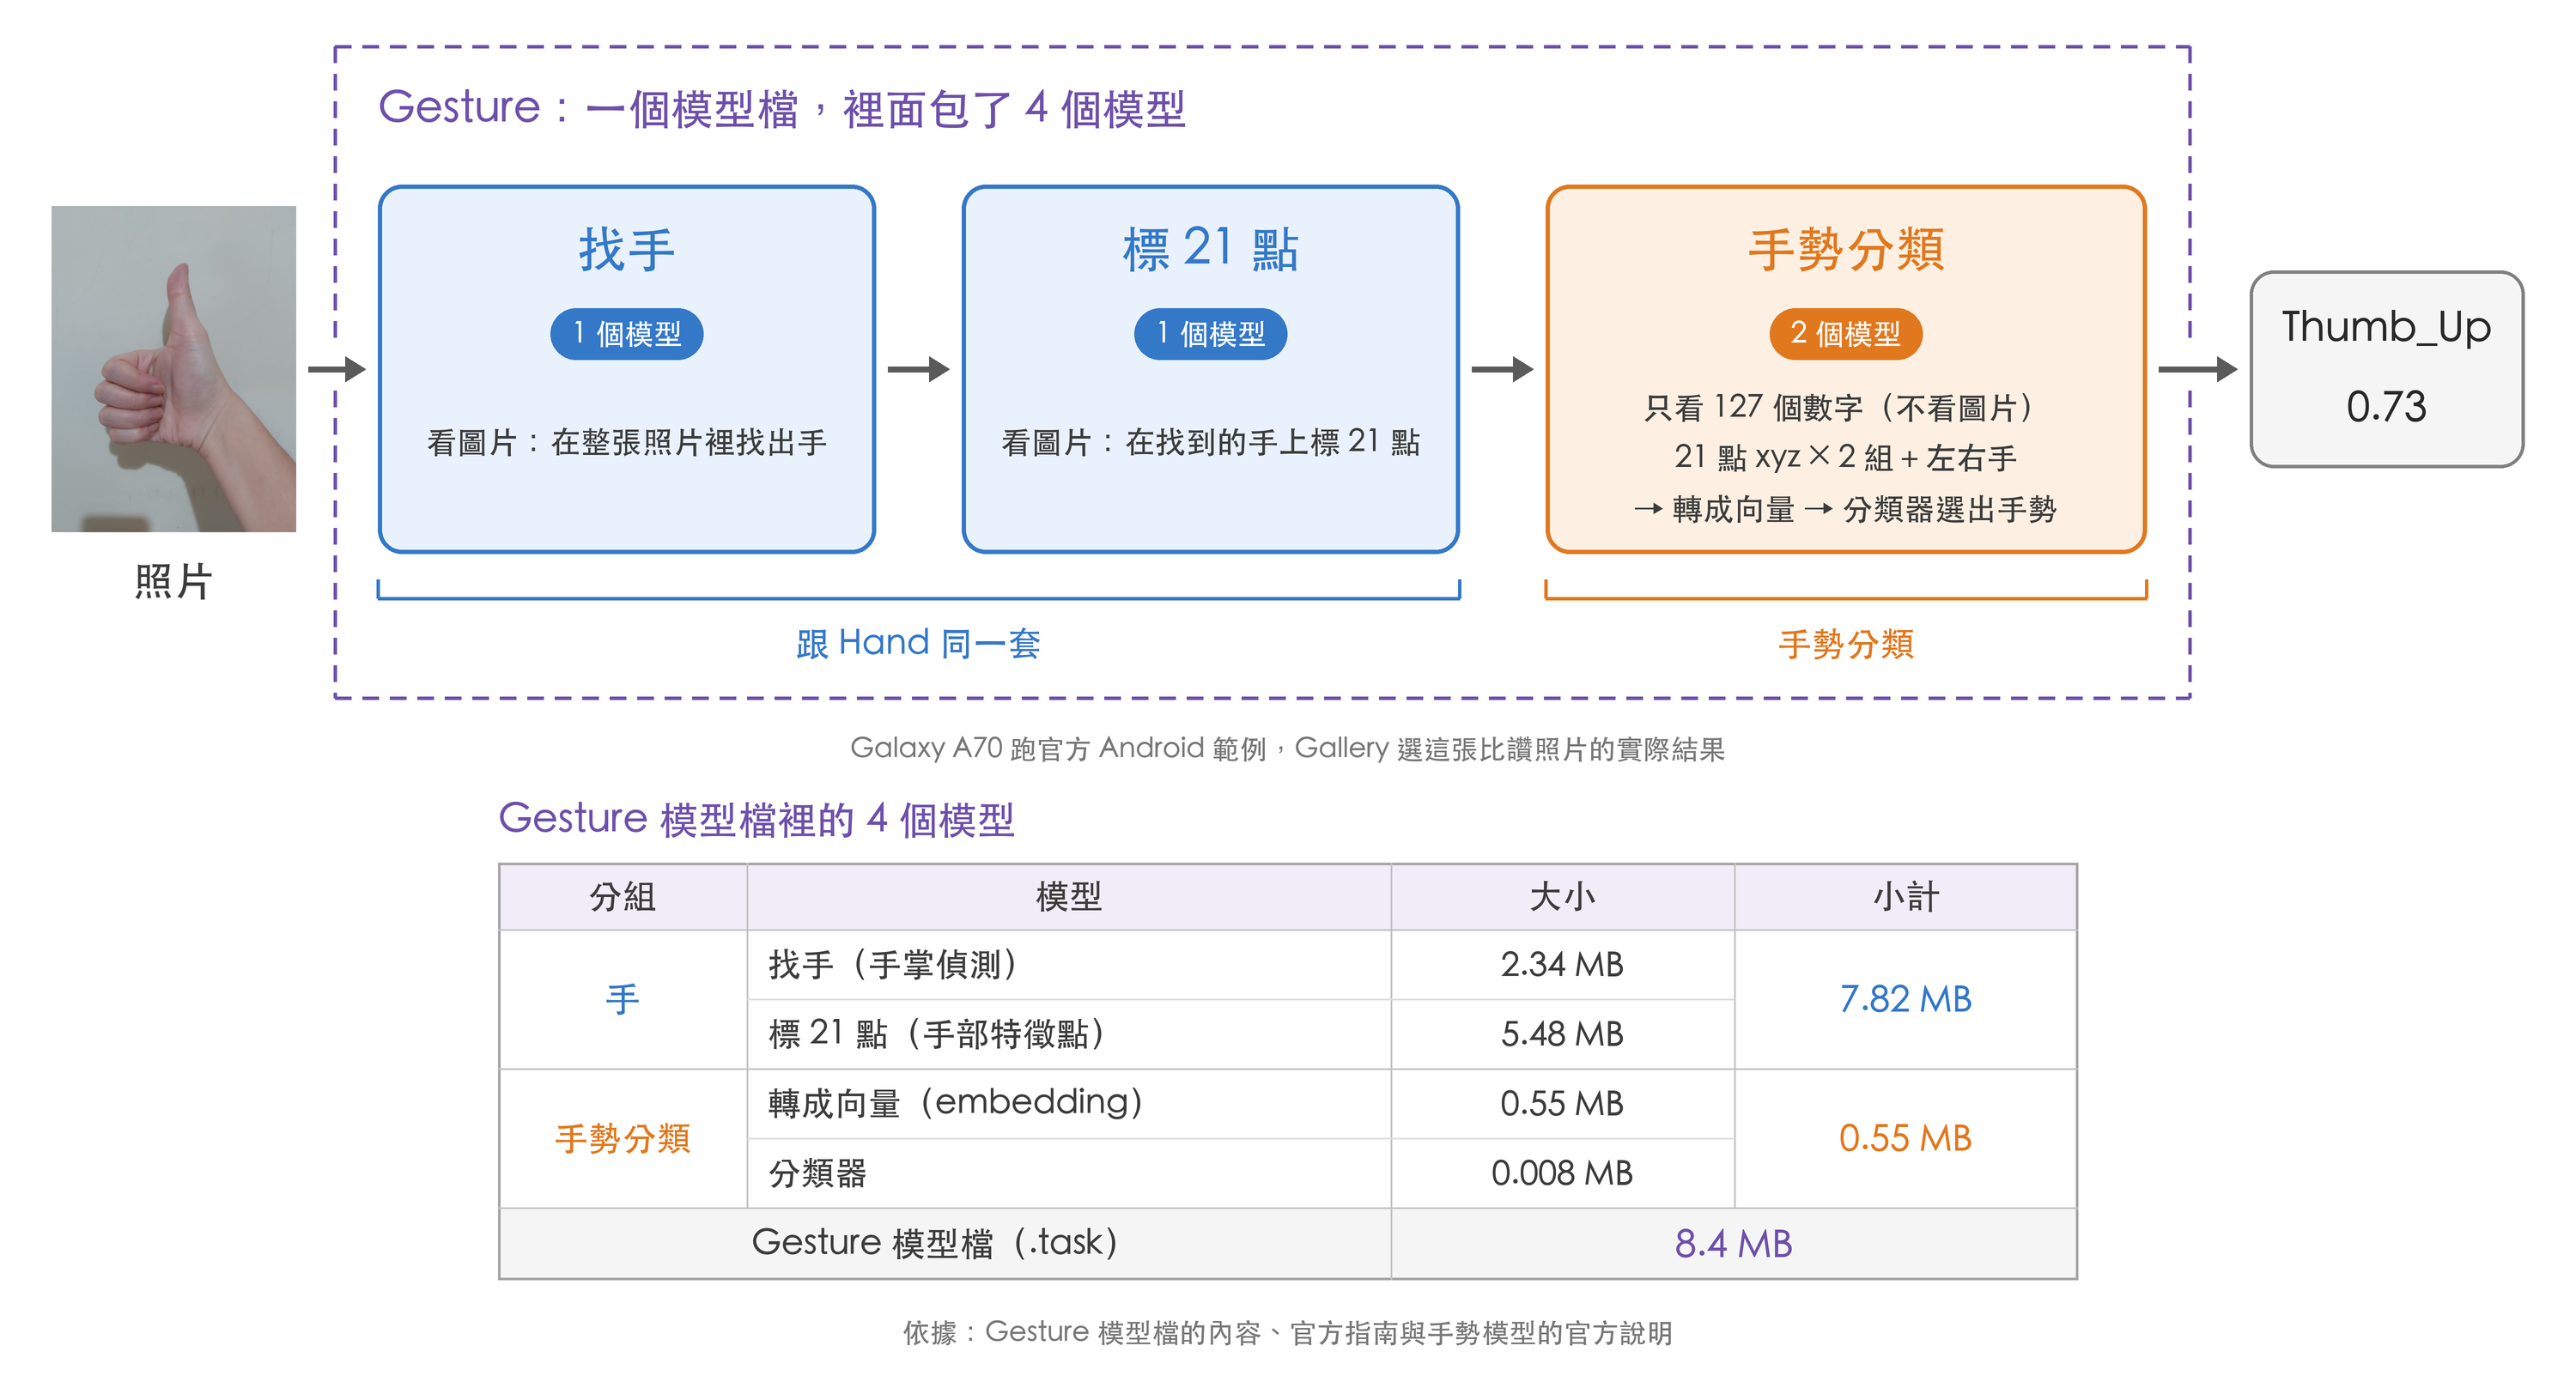
手勢分類這段,只看特徵點的數值,不看圖片。
官方有備註:只需要手的點,用 Hand 就好。
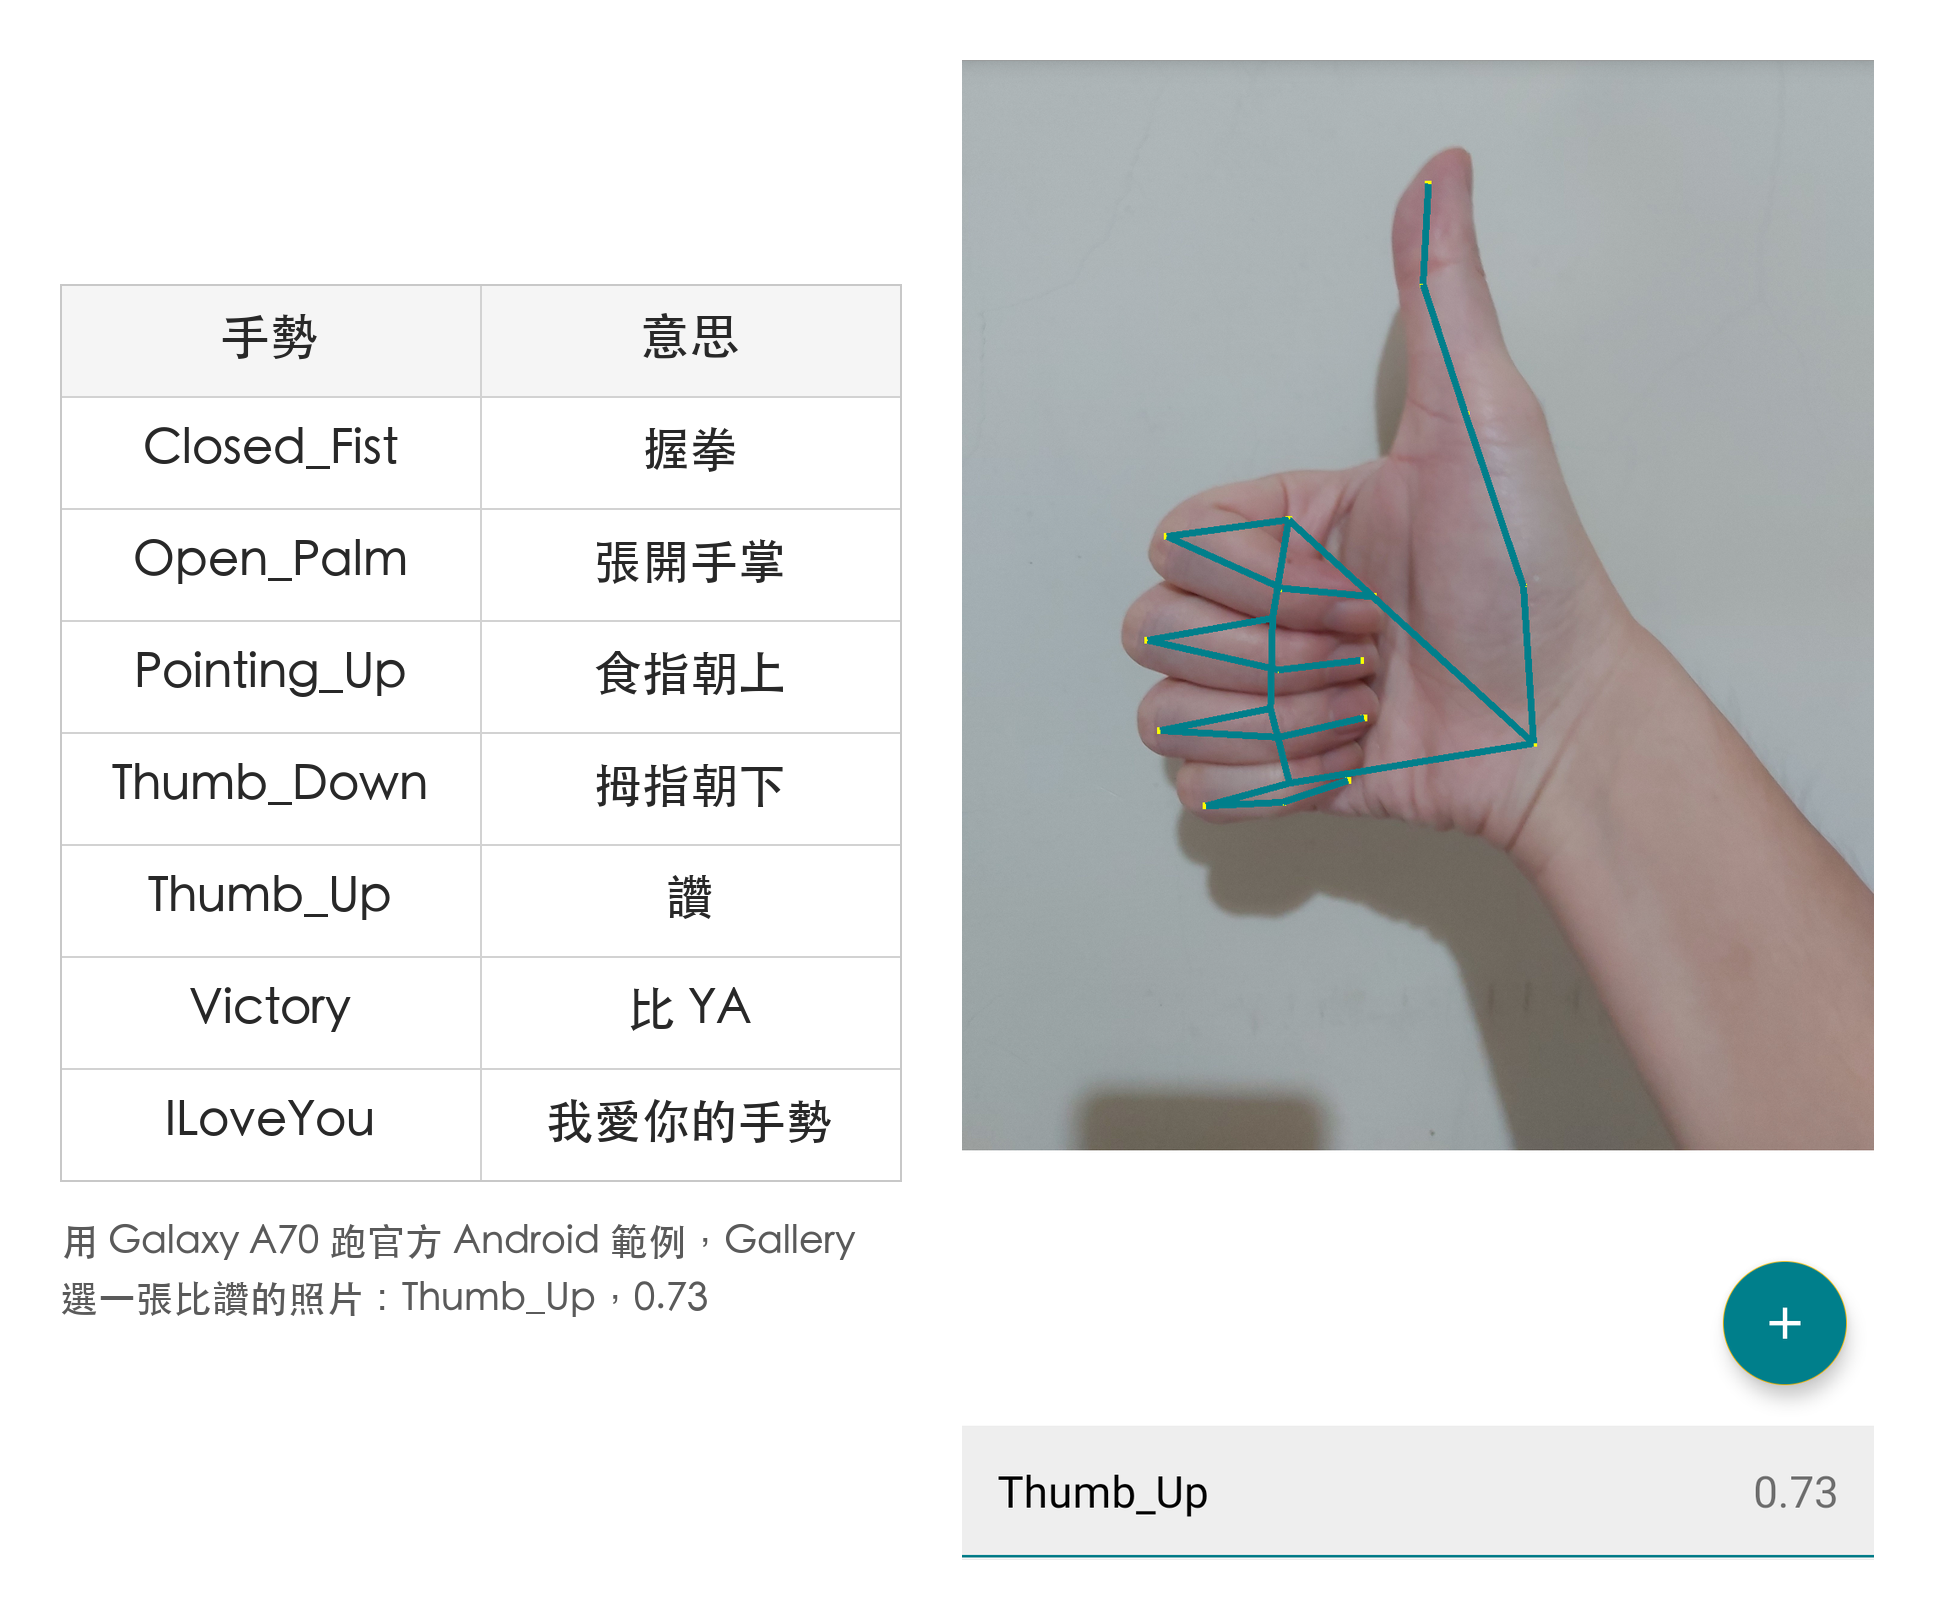
- 有手、但認不出手勢:手勢名稱回 "None"。
- 沒偵測到手:結果是空的清單(長度 0),不是 null。
官方說明,Pose 分兩段:
先找人:人體偵測模型(pose detector),找出畫面裡的人。再標點:特徵點模型(pose landmarker),標出身體的 33 個特徵點。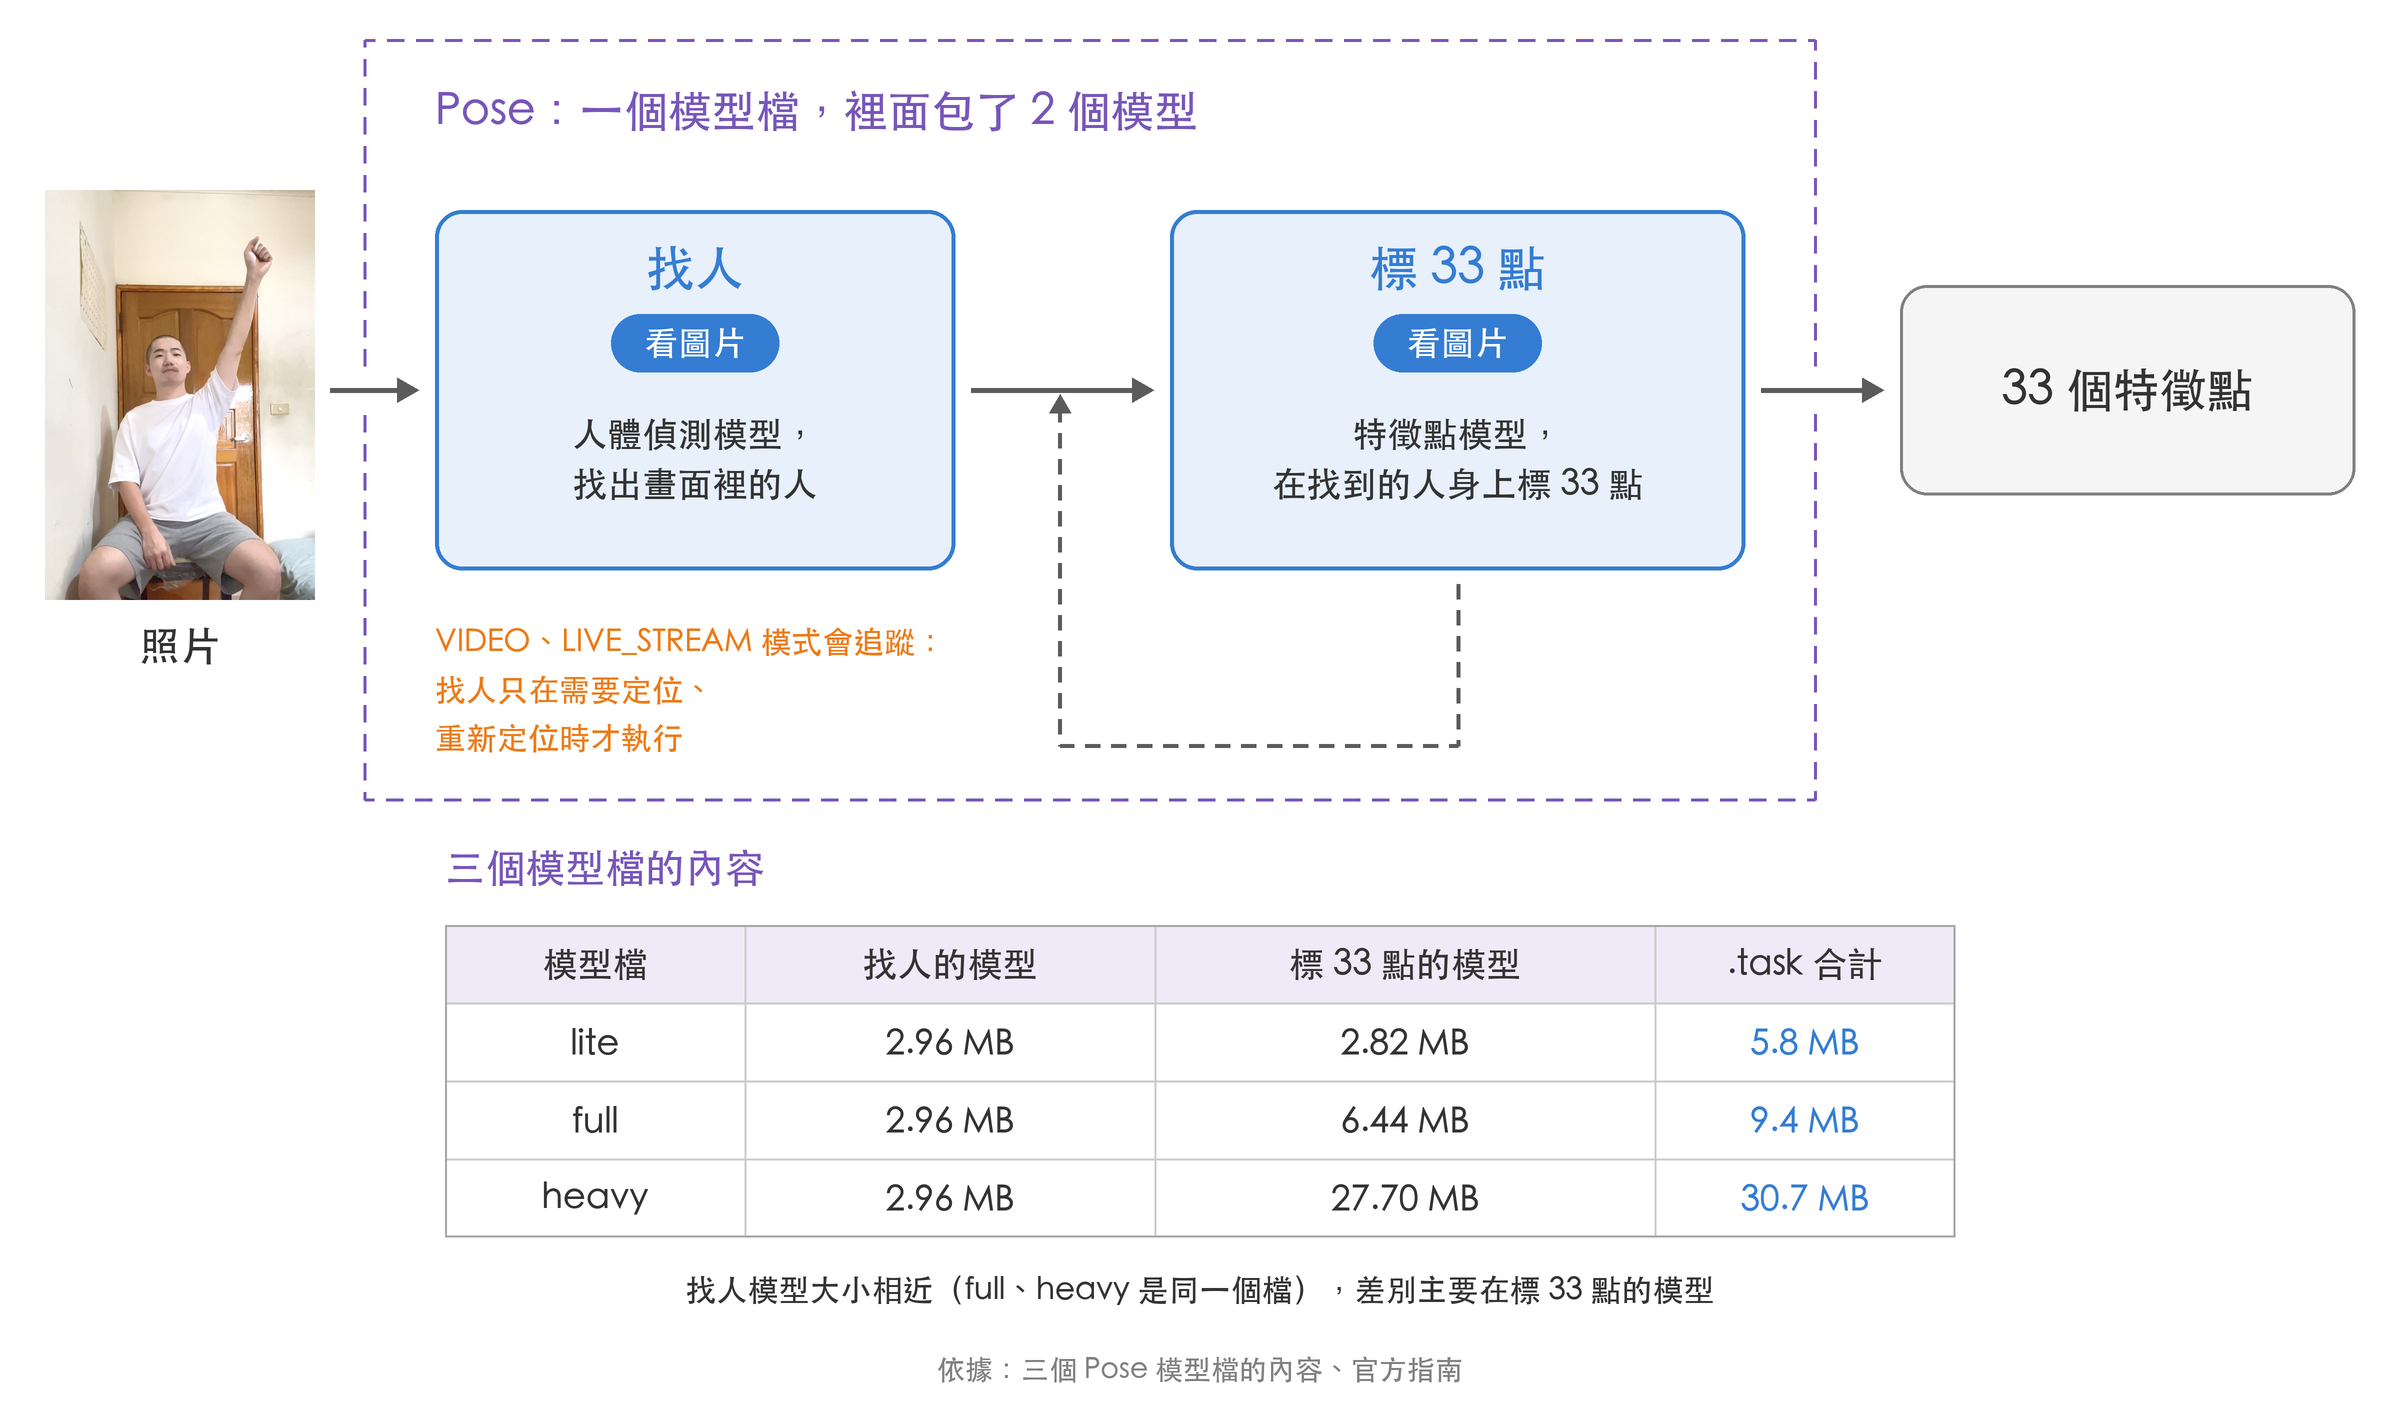
VIDEO、LIVE_STREAM 模式會追蹤,不用每一格都重新找人。
跟 Day7 介紹的 Face Landmarker 一樣:
找人(找臉)的偵測模型,只在需要定位、重新定位時才執行。
| 模型 | 官方寫的大小 | 下載的 .task | 官方寫的速度(機型 Pixel 3 ) |
|---|---|---|---|
| lite | 3 MB | 5.8 MB | CPU 約 44 FPS、GPU 約 49 FPS |
| full | 6 MB | 9.4 MB | CPU 約 18 FPS、GPU 約 40 FPS |
| heavy | 26 MB | 30.7 MB | CPU 約 4 FPS、GPU 約 19 FPS |
三者的差別是「速度」和「準確度」的取捨:
lite 最小、最快,heavy 最大、最準。官方用手機後鏡頭拍的照片評估「關鍵點正確率」(PDJ,只看 2D 位置):
lite 約 87.0%、full 約 91.8%、heavy 約 94.2%。
最新的官方指南(2026 年 10 月更新):
有 num_poses 參數,可以設定最多偵測幾個人。指南連到的模型說明是 2021 年寫的,目前仍是最新一份,補充了這幾點:
33 個點分三區:臉 0~10、上半身 11~22、下半身 23~32。
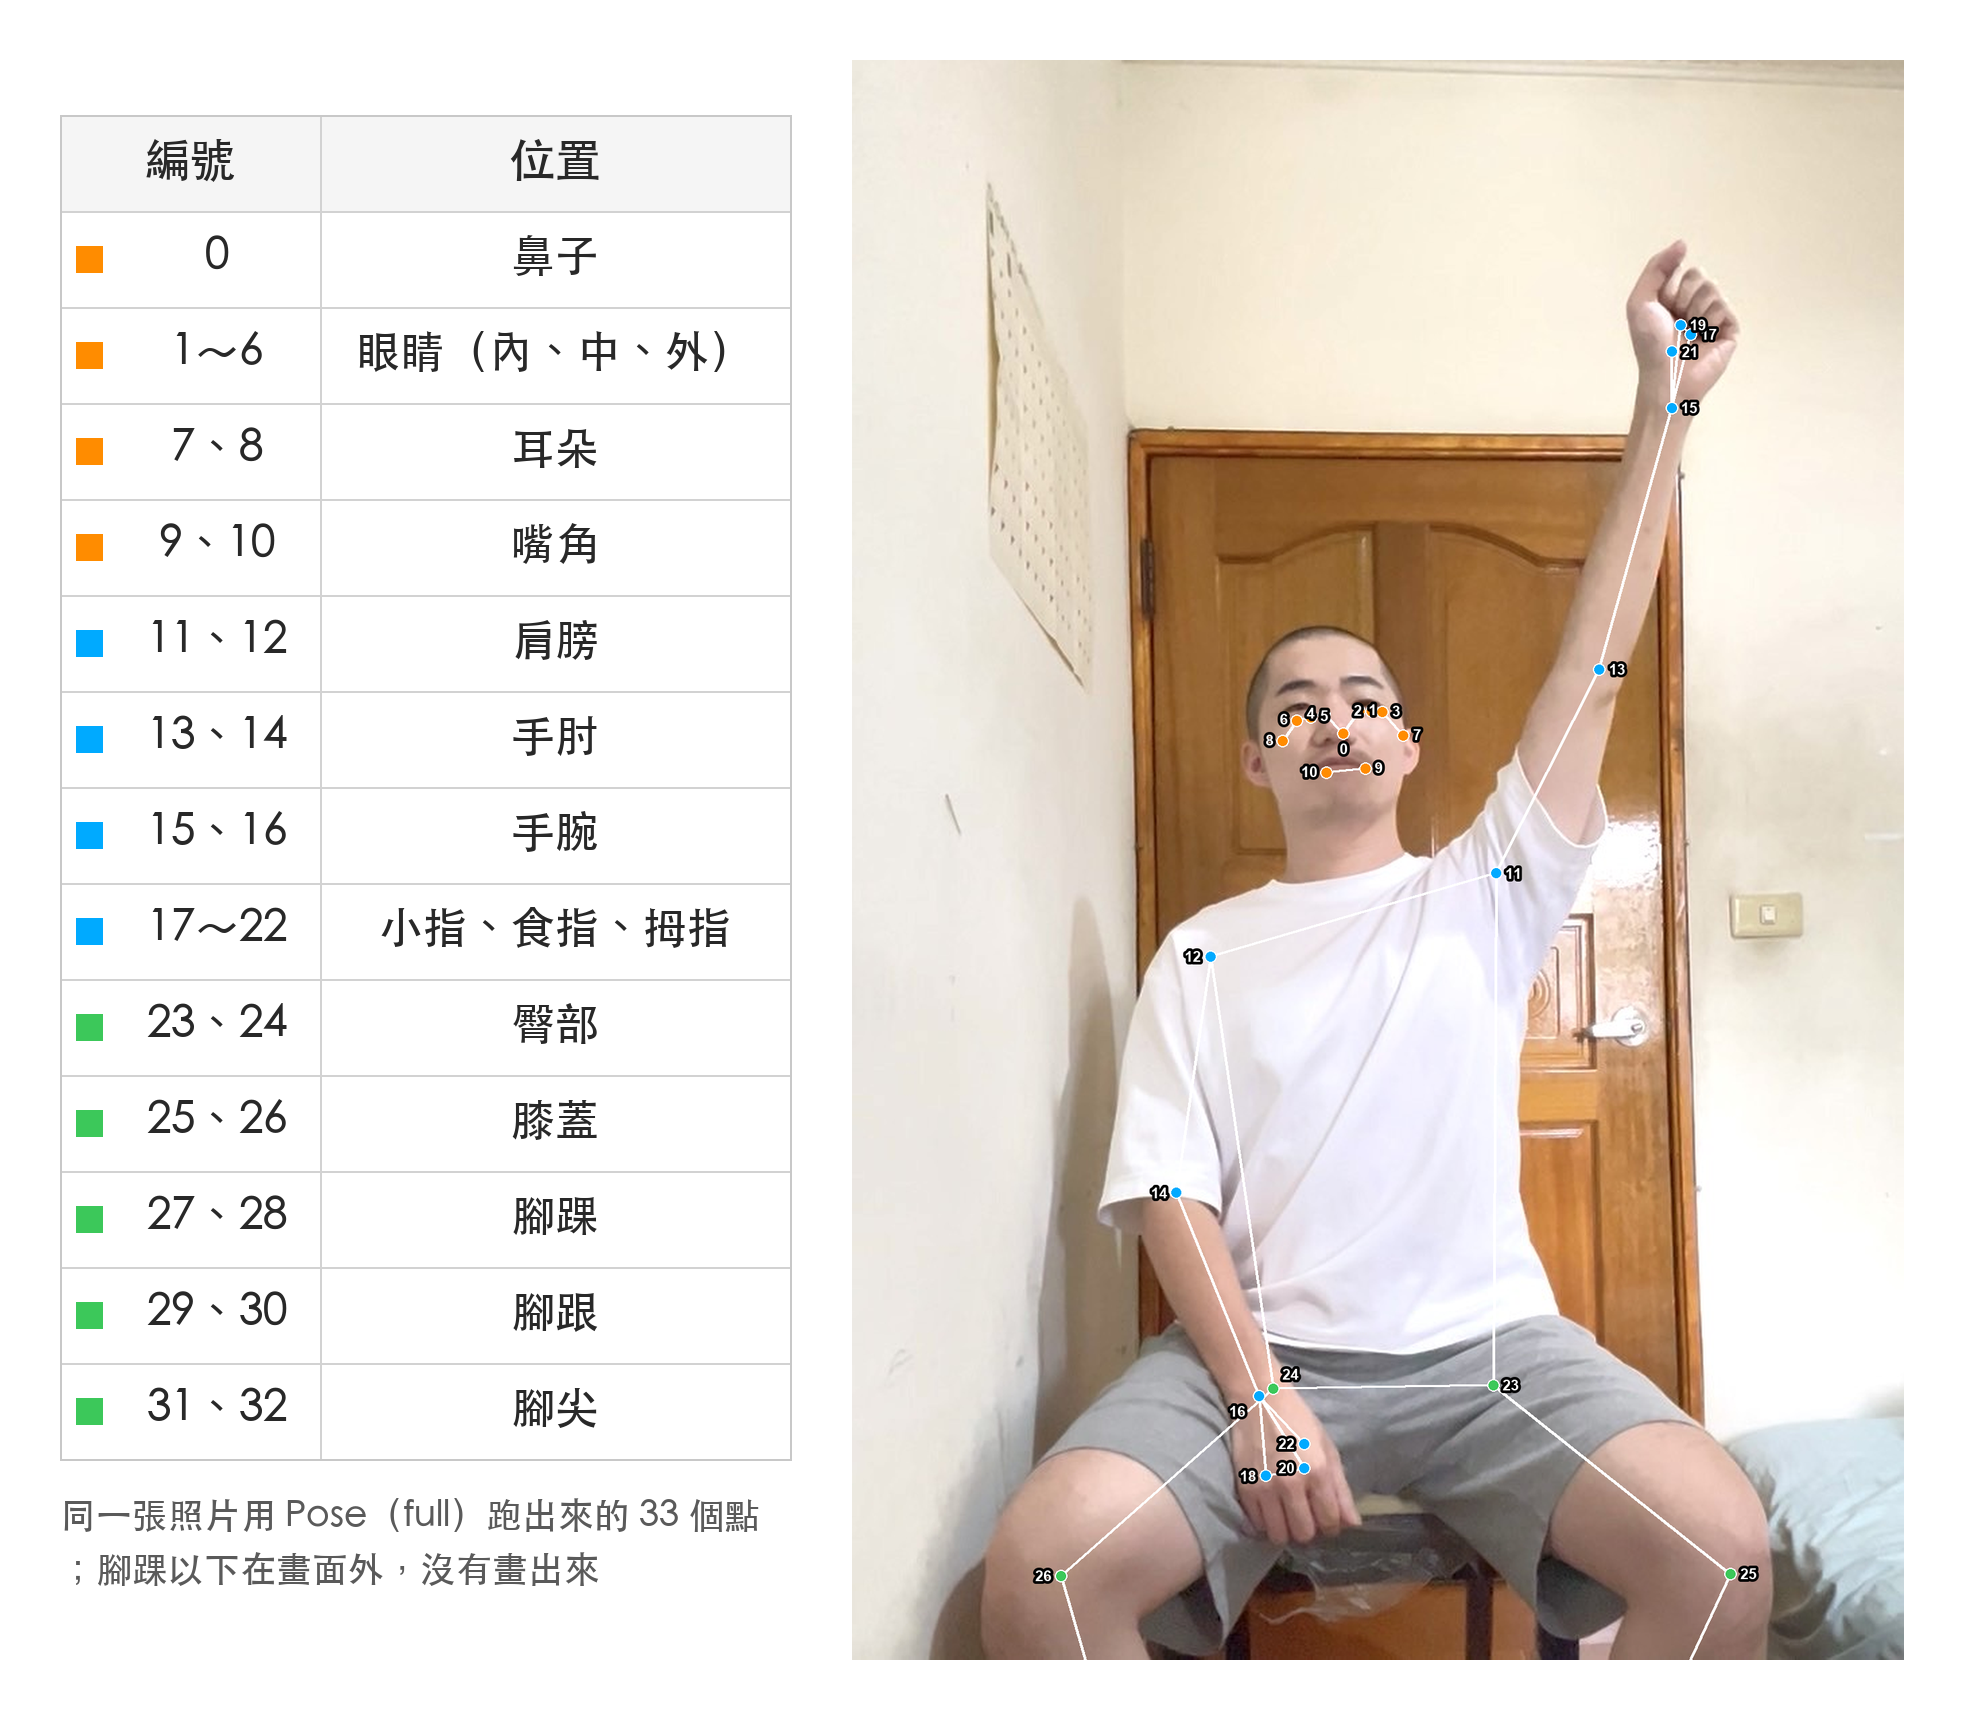
手的部分,17~22 每隻手只有各 3 個點:
官方說明:小指、食指、拇指的 knuckle(指根關節)。
官方說明,Holistic 把 Face、Pose、Hand 的模型包在一起:
臉:臉部偵測+臉部網格,478 點(含 10 個虹膜點),可以加 52 個 blendshape。身體:Pose 的偵測+33 點。手:每隻手 21 點,手的位置從身體的點找出來(見下方)。合起來,最多一次給 553 點。
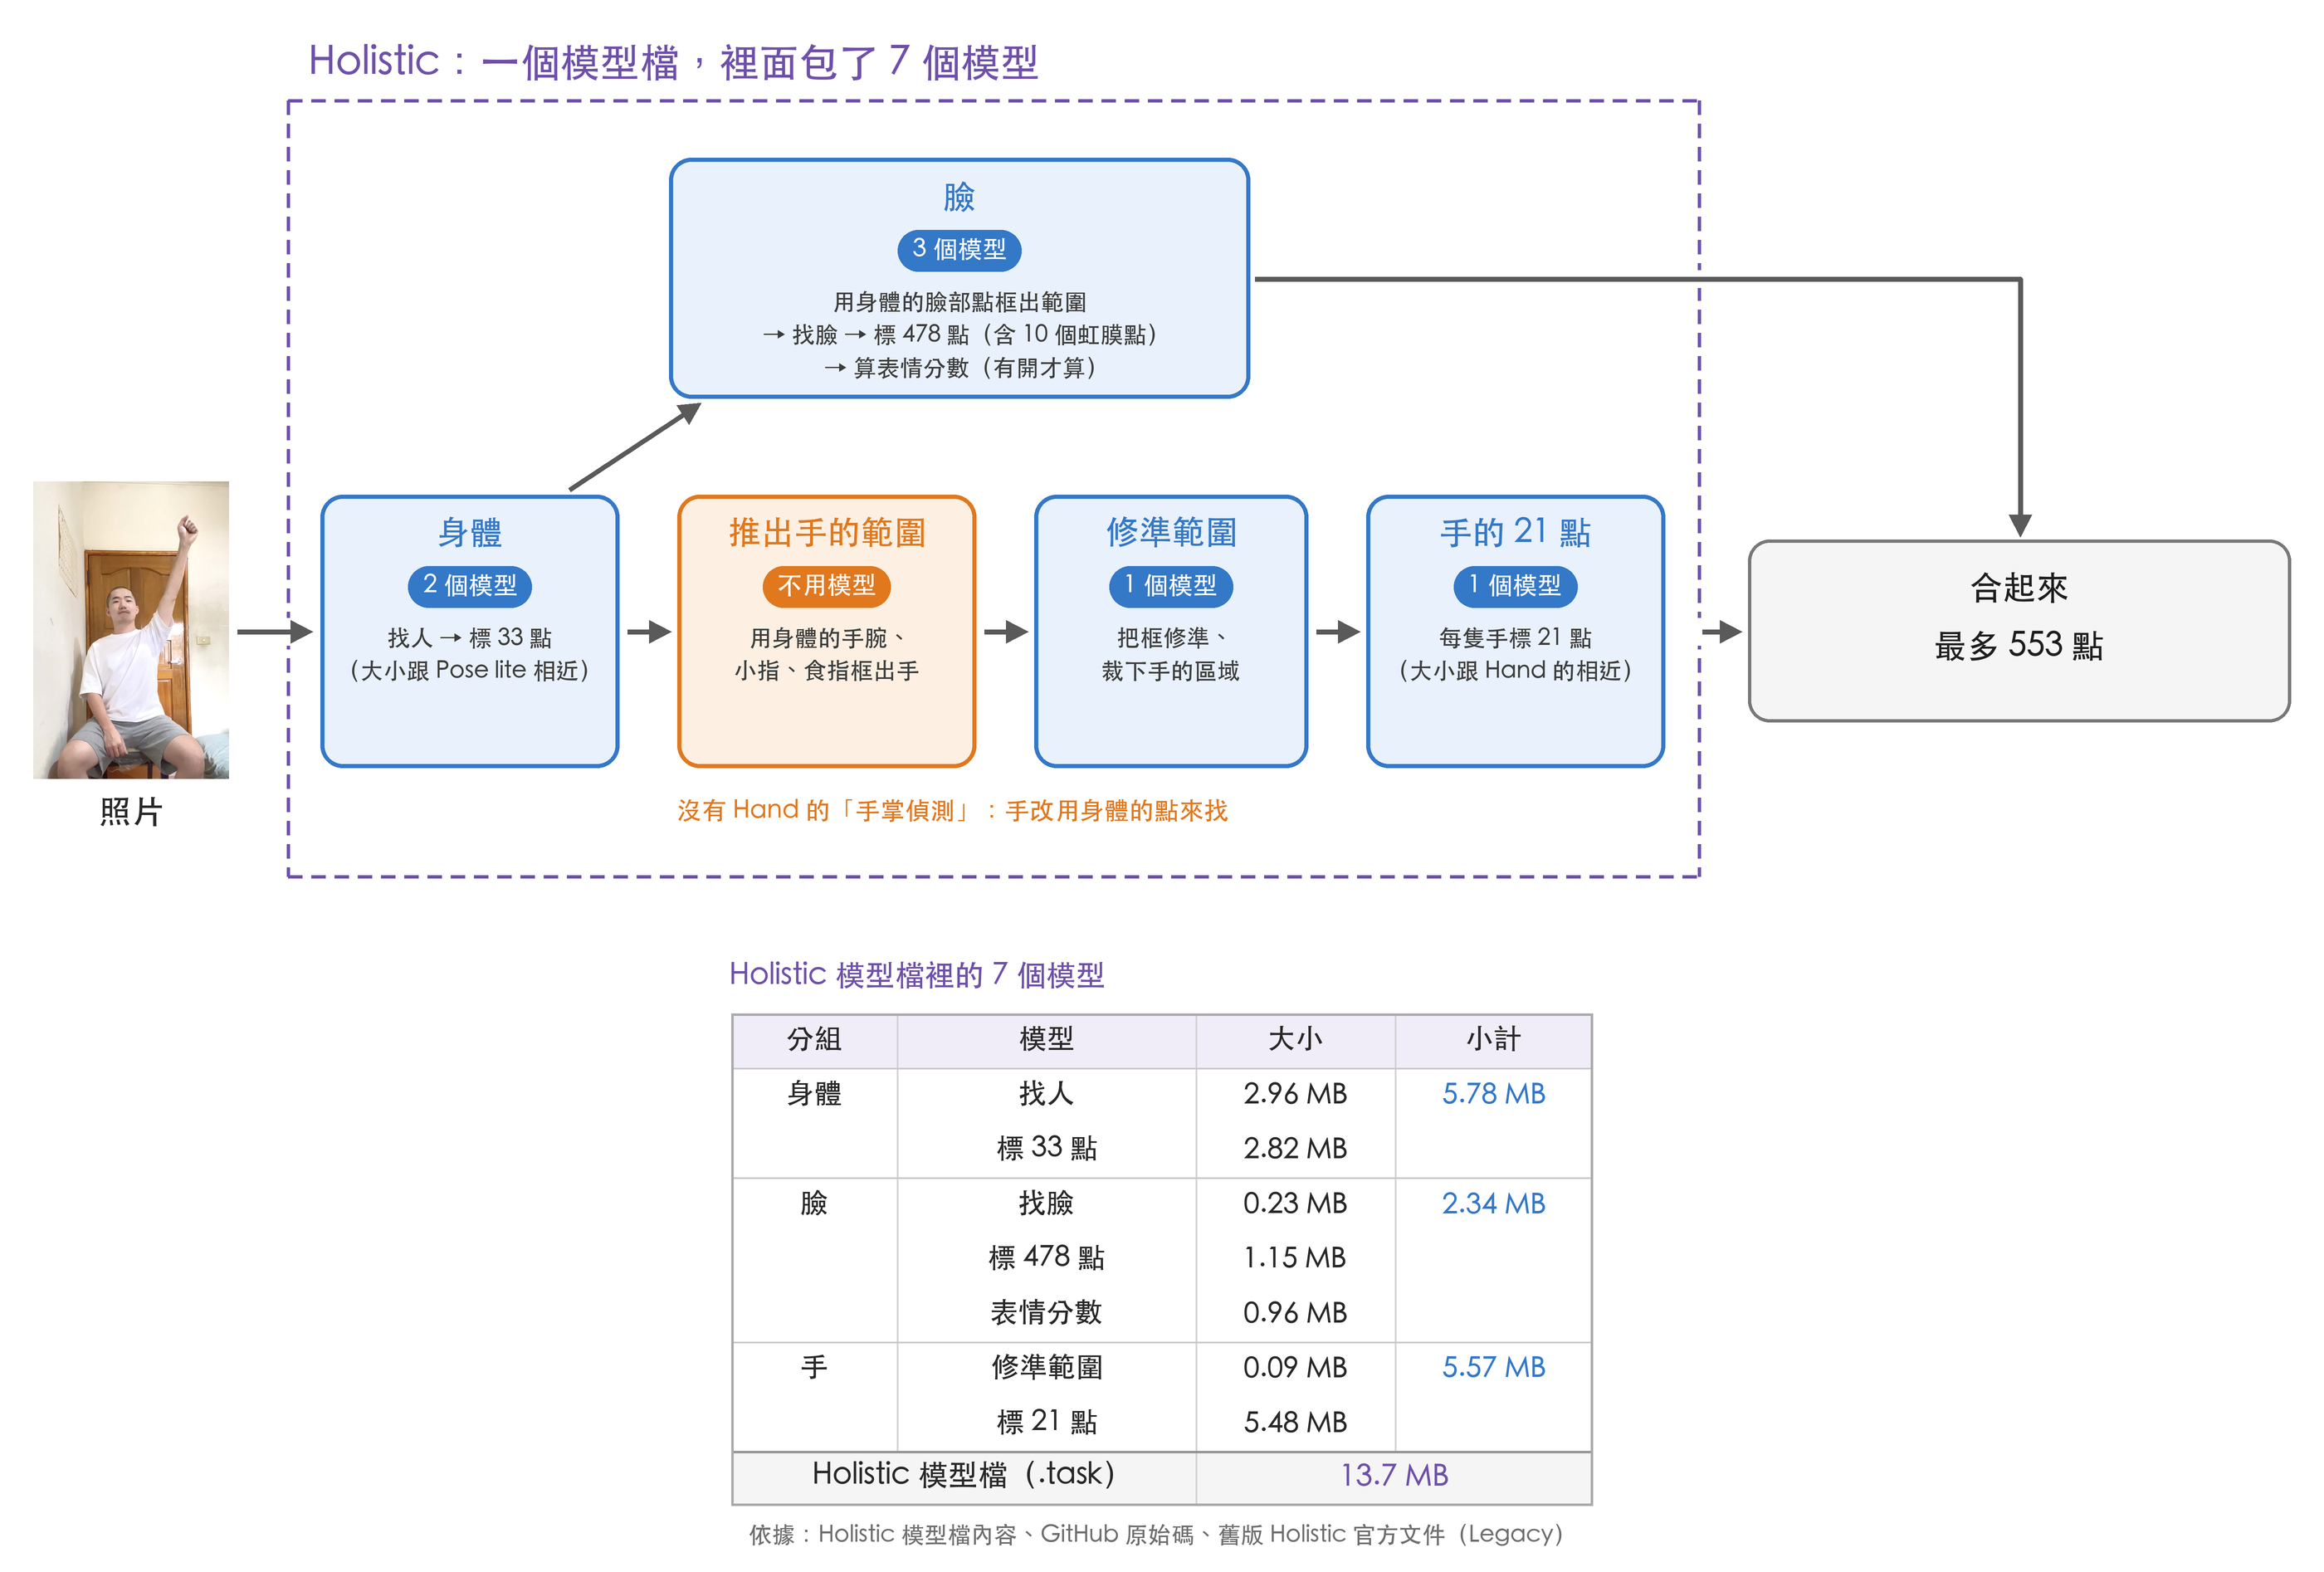
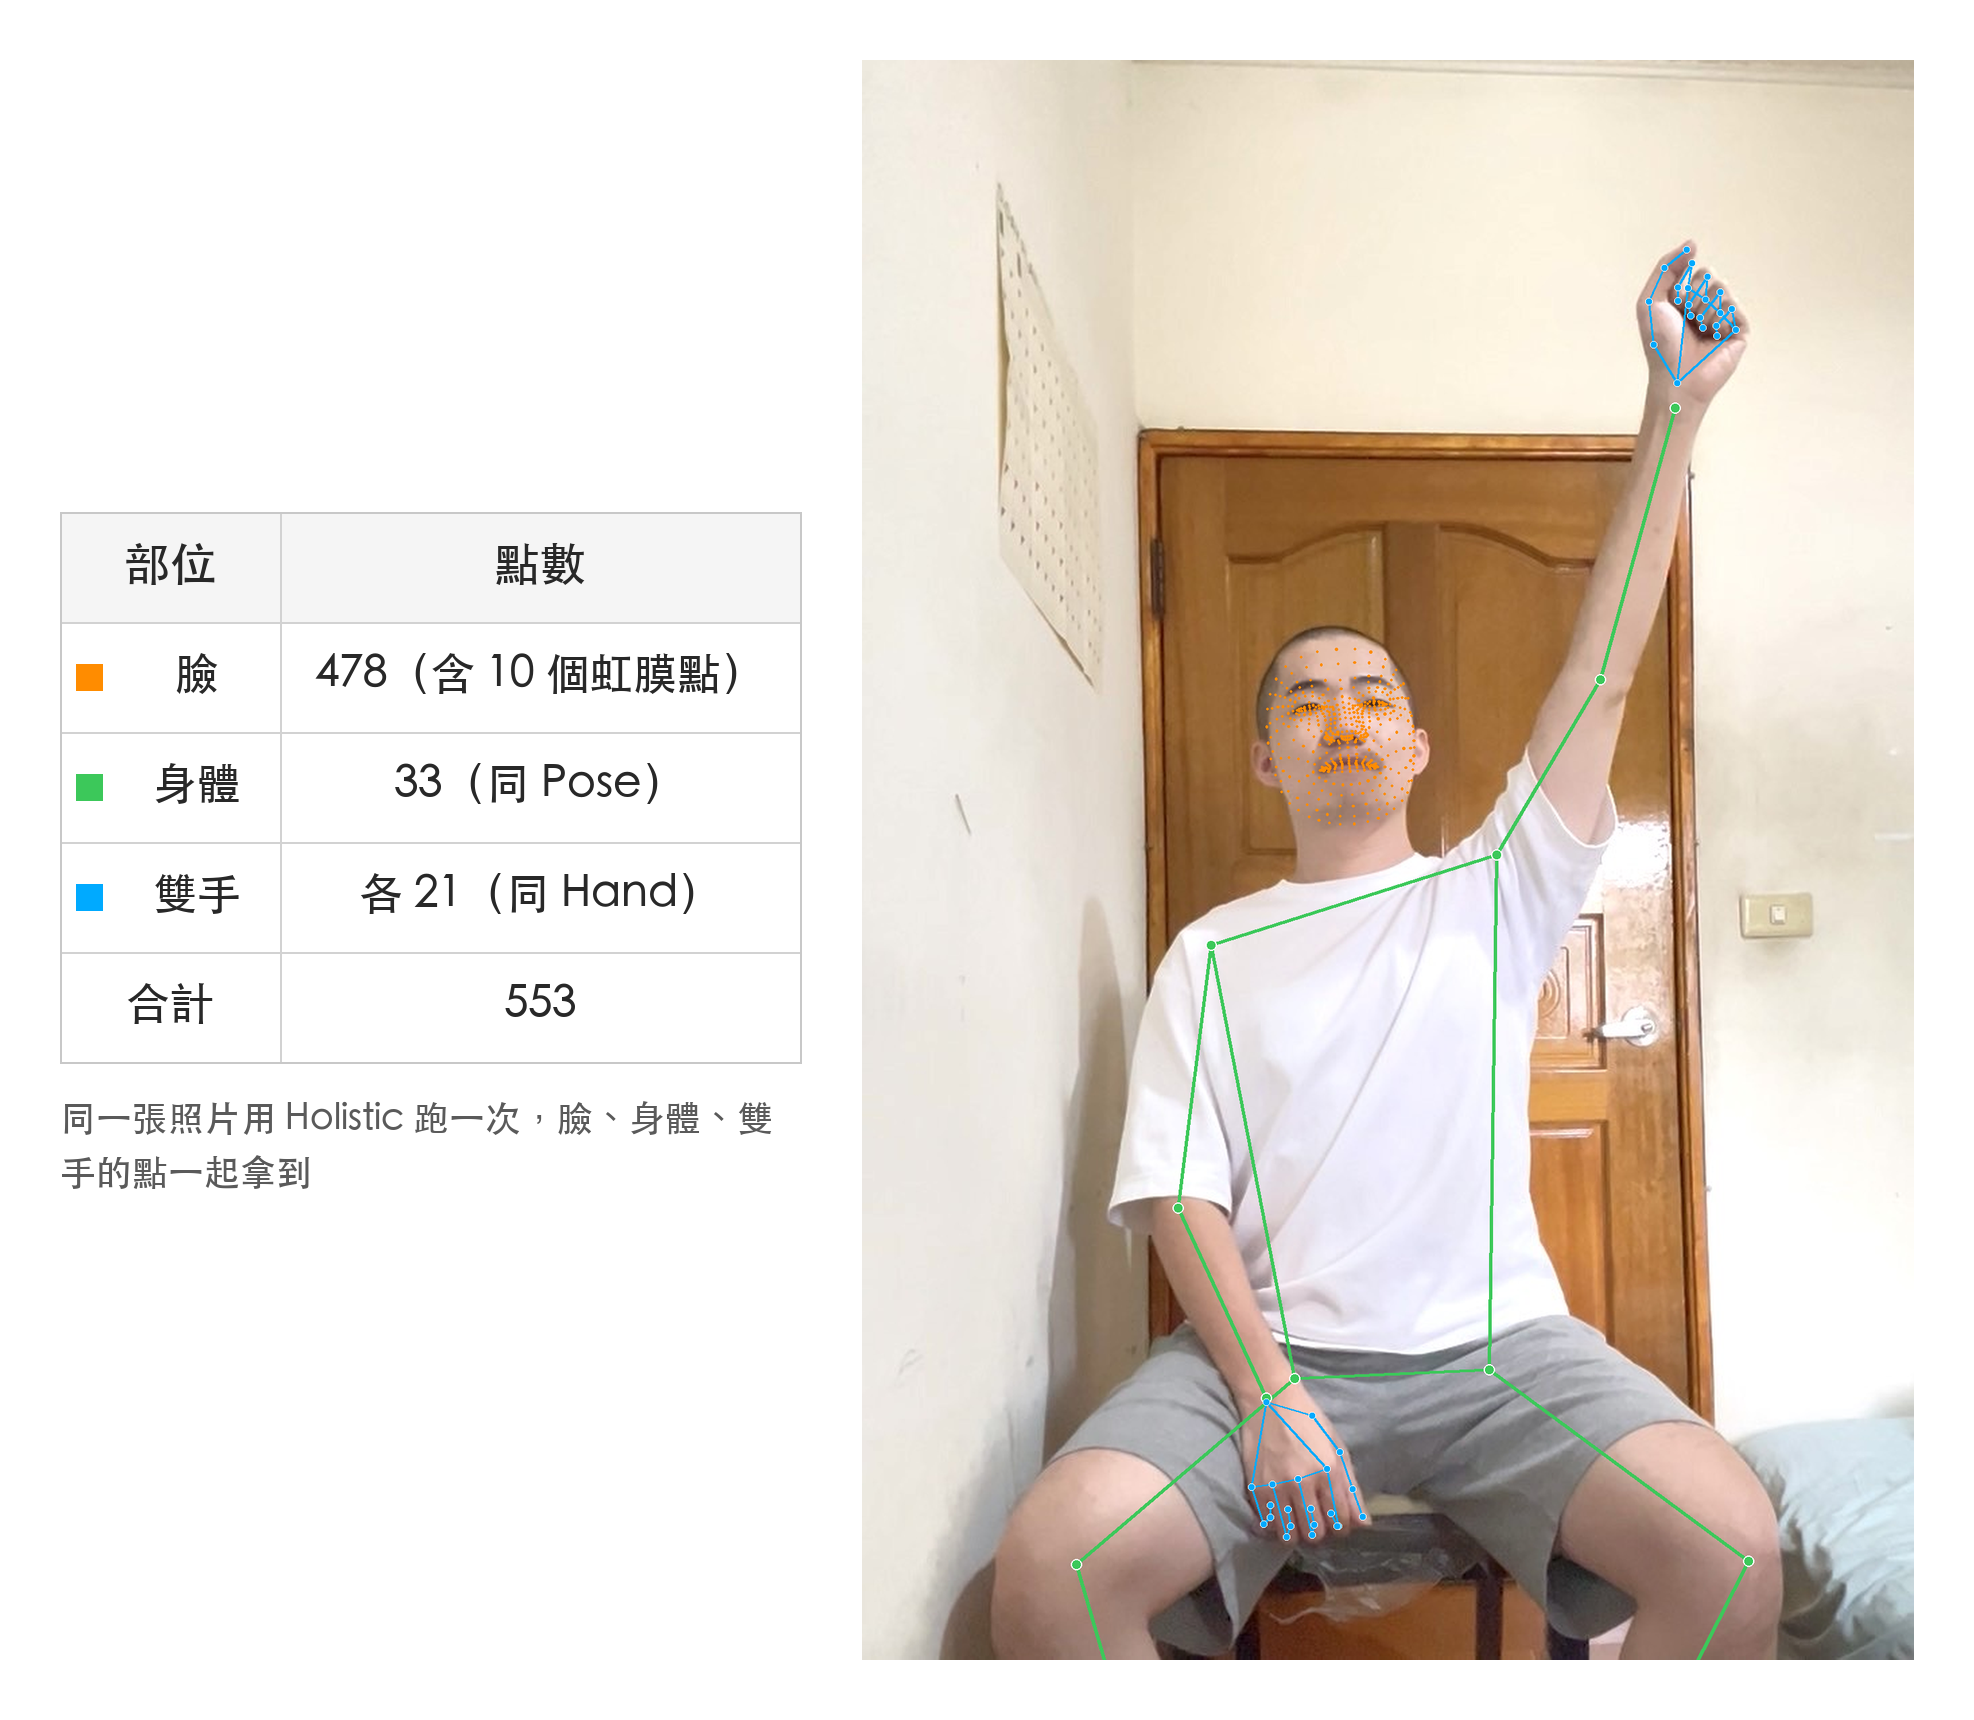
Holistic 目前只支援一個人;家人一起入鏡時,它只會抓其中一個。
MediaPipe 在 GitHub 公開的原始碼裡,
有 Holistic 把幾個模型串起來的流程:先偵測、追蹤身體;
找左手時,拿 Pose 的左手腕、左小指、左食指當線索(節錄):
PoseIndices pose_indices = {
    /*.wrist_idx =*/
    static_cast<int>(pose_landmarker::PoseLandmarkName::kLeftWrist),
    /*.pinky_idx =*/
    static_cast<int>(pose_landmarker::PoseLandmarkName::kLeftPinky1),
    /*.index_idx = */
    static_cast<int>(pose_landmarker::PoseLandmarkName::kLeftIndex1),
};
手的位置,要靠身體的這幾個點。
我拿同一張照片,把舉起那隻手的手腕遮住,再跑一次 Holistic:
| 遮住哪裡 | 舉起的那隻手 | 另一隻手 | 身體的手腕點 |
|---|---|---|---|
| 沒遮 | 找到 21 點 | 找到 | 位置正確,visibility 0.98 |
| 只遮手腕 | 找不到 | 找到 | 位置跑掉,visibility 還有 0.94 |
| 遮手腕+前臂 | 找不到 | 找到 | 跑得更遠,visibility 0.75 |
沒有前一格可以參考時(例如第一張畫面),手腕一被遮住,Holistic 就找不到這隻手。
被遮住的手腕,Pose 照樣給一個推測的位置,遮得越多偏得越遠;
跟 Day11 遮住臉的測試一樣。
影片中途才遮住的話,Holistic 會沿用上一格的位置,還是找得到,這部分明天再比。
Day8 介紹過的 Instant Demos,也有 Pose Landmarker,
打開瀏覽器、允許使用視訊鏡頭就能測。
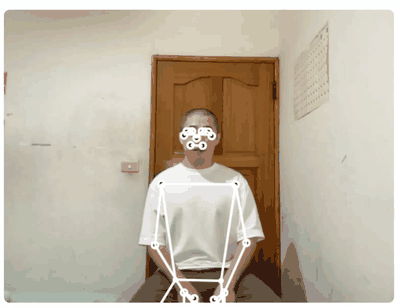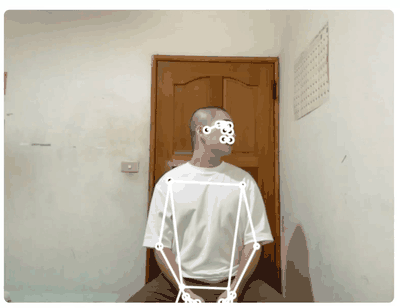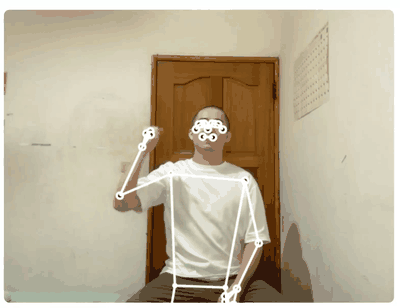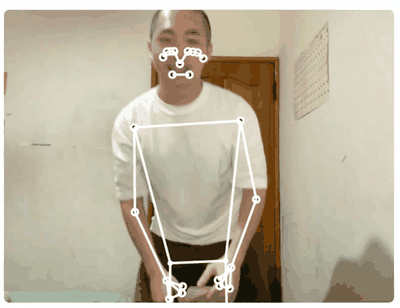
我坐在椅子上,依序做動作(lite,2 倍速):
仰頭、低頭、左轉頭、右轉頭、聳肩、
舉左手、舉右手、張開雙臂、拍手
| 看什麼 | 結果 |
|---|---|
| 下半身 | 臀部的點落在畫面底邊,大腿是往下的兩條線 |
| 頭部動作 | 仰頭、低頭、轉頭,臉上的點跟著動 |
| 舉手、拍手 | 手腕的點跟得上,拍手時兩個手腕靠在胸前 |
| 抖動 | 點位穩定,沒有亂跳 |
三個模型,肉眼看不出差別。
Demo 畫面上會顯示推論時間,從坐著的那一段,每個模型各抽 20 格讀數字:
| 模型 | 推論時間 |
|---|---|
| lite | 約 13~19 ms |
| full | 約 14~20 ms |
| heavy | 約 30 ms |
這是電腦瀏覽器上的數字,手機要另外測。
電腦的視訊鏡頭,畫面是橫的;
手機直放時,畫面變成直的,左右窄很多。
所以張開雙臂這個動作,另外用手機的瀏覽器開同一個 Demo,
直放、橫放各錄兩段:
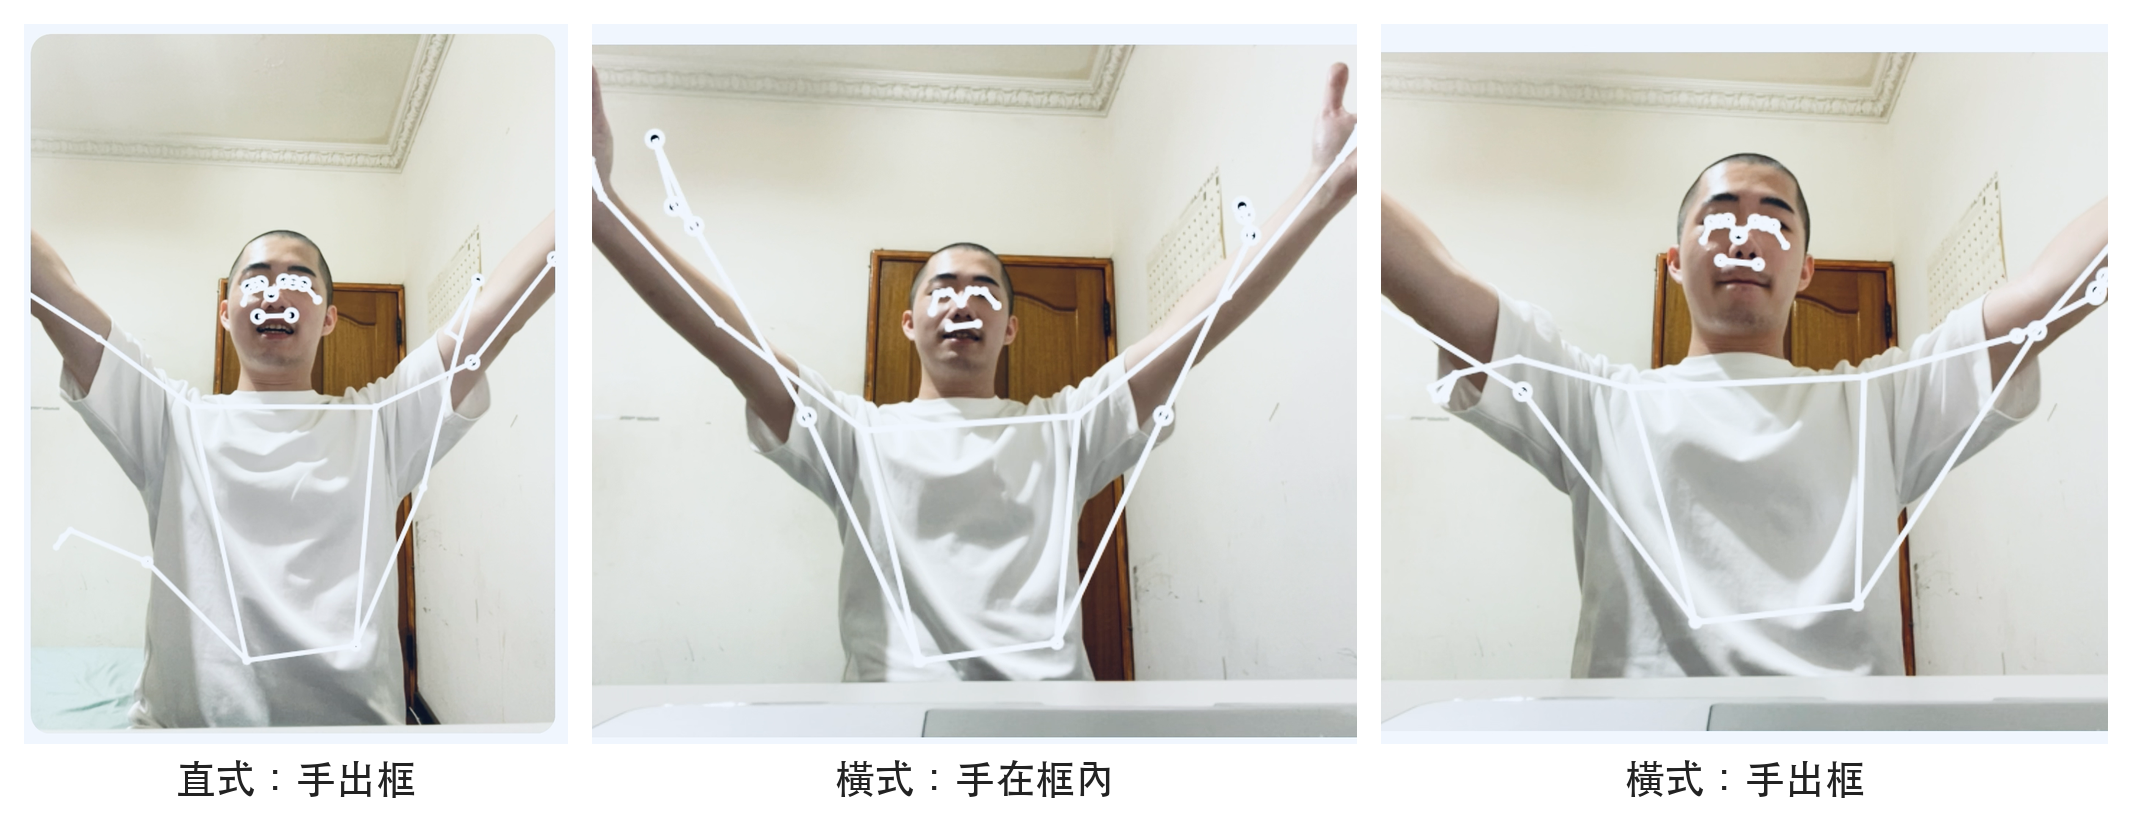
關鍵不是直放或橫放,而是手有沒有留在畫面裡。
判斷「張開雙臂」時,可以這樣處理:
- 先看手腕的 visibility,太低就不用手腕。
- 改看手肘:手肘幾乎都還在畫面裡。
- 提醒長輩坐遠一點,讓手留在畫面裡。
坐著也看得到,手要留在畫面裡。
明天,四位俠客正式過招:
同一張照片,在實機測試跑一次,
參數怎麼設、拿到的數字怎麼讀,一起來看。
舉左手的「左」,是誰的左邊?同樣看手,Hand、Gesture、Holistic 給的結果一樣嗎?手指比幾,哪一位俠客認得出來?
感謝有緣看到這邊的你~
希望佛菩薩也祝福你:🌟平安自在 幸福安心🌟
南無觀世音菩薩🍀 南無地藏菩薩🏠 南無阿彌陀佛☀️


 iThome鐵人賽
 看影片追技術