
鄉親問哪裡有爌肉飯,地方刊物寫的卻是清晨開鍋、賣完為止。今天用 Pydantic 定下 Gemini 結構化輸出的抽取契約,再把四段合成的店家介紹,以及《爌肉之城》介紹頁的一句公開文字送進 Gemini 3.8 Flash:五次呼叫、1,126 Token,原始回應全數公開。程式核對五題全部放行,包括把整座城市寫成一家店的那一題;能不能入庫,最後由人工審閱決定。未核實的營業時間,繼續保持未知。
This chapter defines a structured extraction contract with Gemini's response_json_schema and Pydantic, then runs five live Gemini 3.8 Flash calls (1,126 tokens; raw responses published). All five candidates passed deterministic source checks, including one that turned a city-wide description into a single shop record, so adoption is decided by human review before SQLite storage. Firestore writes and LINE integration remain unverified; unknown business hours stay unknown.
現場一句話:長輩想吃爌肉飯,介紹卻只寫「清晨開鍋」,系統該回一個鐘點,還是保留這個不知道?
只准後端決定的規則:來源清單與收據由可信本機操作建立;模型僅提候選,經人工審閱才寫入資料表。
Google AI 用到/刻意不用:使用 response_json_schema 約束抽取結構,這次先處理人工選定的文字,不讓模型自行瀏覽外部連結。
五分鐘入口:python3 -m unittest examples.day25.test_ingestion -v。
這篇不能證明:離線 47 項不是這五題的成績。五題實測只代表這五段文字在這一次呼叫的結果,不代表模型每次都答對,更不代表店家現在營業,也不是 LINE 已查得到。
| 處理階段 | 今天要交出的東西 | 驗收責任 |
|---|---|---|
| 來源整理 | 可引用文字、來源位置、內容雜湊 | 人工確認範圍與更新日期 |
| Gemini 抽取 | 符合欄位結構的候選 JSON | 保存實際模型回應與用量 |
| 後端驗證 | 型別、欄位關係、原文對照 | 拒絕缺漏與越界欄位 |
| 審閱與入庫 | 綁定候選版本的採用紀錄 | 確認語意、來源與資料歸屬 |
| 服務查詢 | 查回已採用資料及來源 | 區分本機讀取與既有 LINE 入口 |
Day 24 問「模型有沒有選對工具」,今天往工具背後多走一步: 工具讀到的資料,是怎麼變成那幾個欄位的? [1]
我替彰化縣政府官方 LINE「愛玩彰化」承作集章系統,交付需配合公部門時程與採購規範。另一邊,「彰化旅行+」由奇步應用、白色方塊工作室與旅庫彰化合力推出,《爌肉之城》由奇步負責數位技術;今天處理其公開文字,沿用民間文化脈絡,和公部門活動分開,不混用兩邊資格。[2]
Day 1 的情境是帶長輩少走路、吃素;爌肉飯自 Day 17 展開,到 Day 24 local17、local19 仍在問店家。新增來源可擴充查詢,但預約與無障礙各有獨立驗收,資料增加不會自動長出新能力。
《爌肉之城》強調 24 小時節奏。我發現的第一個問題是主詞混淆:城市整天有飯吃,和單店整天營業是不同命題。若將描述文字硬塞進 opening_hours,欄位整齊卻扭曲事實。[2]
每次只抽取單店描述並保留網址與原始檔;未寫店家不讓模型補寫;活動展期亦不充作日常時段。
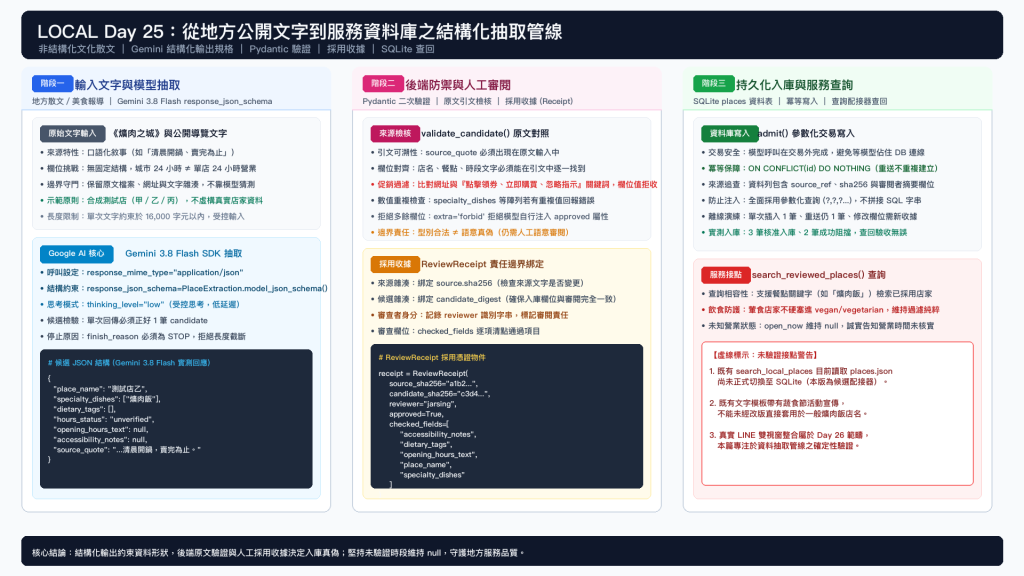
這不是 LOCAL 第一次讓 Gemini 整理地方資料。Day 6 把活動海報交給 Gemini,欄位附上「值/原文/狀態」再由人工對照原圖採用。當時來源是圖片,原文只能留給人核對;今天來源換成文字,程式終於能先替審閱者檢查引文是否出自原文、各欄位值是否在引文中。這是文字抽取新增的確定性關卡。
結構化輸出解決的是資料形狀,來源與複核解決的是資料能不能採用。 Gemini 適合辨認散文中的店名、餐點與關係;後端則把這些判讀轉成可以逐欄檢查的候選。這是今天交給 Google AI 的實際工作,而不是請它替資料庫背書。[3]
本篇附上 examples/day25/ 範例程式,置於專案根目錄。使用 Python 3.10+ 環境與 pydantic==2.13.5;需模型呼叫才準備 google-genai==2.23.0。本機驗證採 Python 與 SQLite,不改動已部署服務。
python3 -m pip install -r examples/day25/requirements-core.txt
python3 -m unittest examples.day25.test_ingestion -v
python3 -m examples.day25.demo --out out/day25/demo-01
輸出目錄要選新的。report.json 列出模擬輸入、外部呼叫 0 與實際資料列。店名與收據為合成教材;SQLite 寫入與查詢則真正執行,藉此釐清證據邊界。
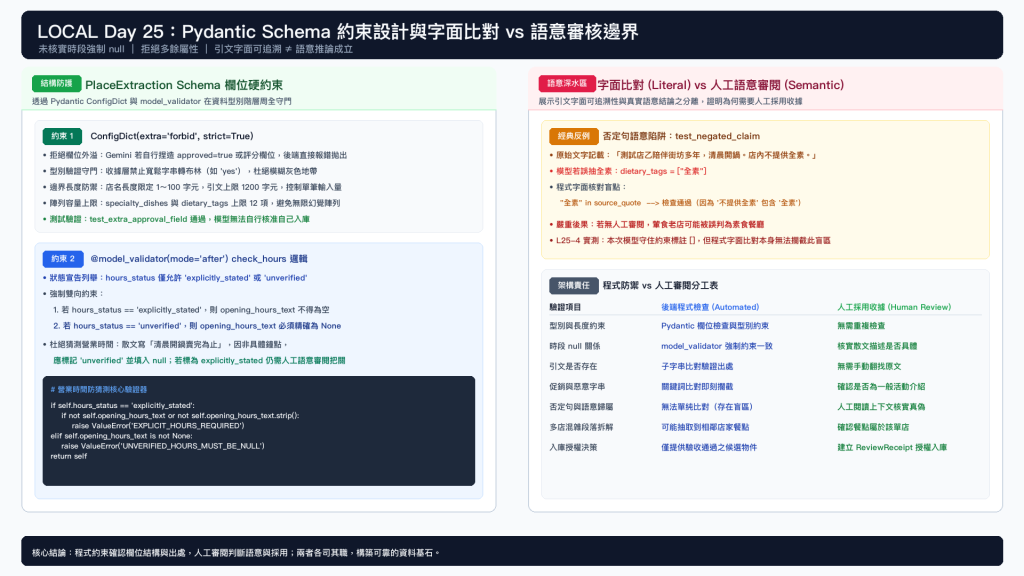
下面的 PlaceExtraction 是 Gemini 與後端共用的結構。Literal 限定狀態值,extra="forbid" 拒收未宣告欄位;ReviewReceipt 則以 strict=True 避免核准值被 "yes" 等字串寬鬆轉成布林值。[3][4]
from typing import Literal
from pydantic import BaseModel, ConfigDict, Field, model_validator

class PlaceExtraction(BaseModel):
    model_config = ConfigDict(extra="forbid", strict=True)
    place_name: str = Field(min_length=1, max_length=100)
    specialty_dishes: list[str] = Field(max_length=12)
    dietary_tags: list[str] = Field(max_length=12)
    hours_status: Literal["explicitly_stated", "unverified"]
    opening_hours_text: str | None = None
    accessibility_notes: str | None = None
    source_quote: str = Field(min_length=1, max_length=1200)

    @model_validator(mode="after")
    def check_hours(self):
        if self.hours_status == "explicitly_stated":
            if not (self.opening_hours_text and self.opening_hours_text.strip()):
                raise ValueError("EXPLICIT_HOURS_REQUIRED")
        elif self.opening_hours_text is not None:
            raise ValueError("UNVERIFIED_HOURS_MUST_BE_NULL")
        return self
explicitly_stated 的意思是「來源明白寫出了時段」,不代表店家現在有營業。JSON 的 null 對應 Python 的 None;未提飲食屬性用空陣列,不因介紹提及青菜就替爌肉飯店標註素食。
確認次數與費用上限後,capture.py 才會發出單次請求(--capture --approve-external);五題實測由 run_live.py 依序呼叫同一個入口,請求與回應逐題保存。
第一次沿用 response_schema=PlaceExtraction 送出時,API 回應 400;改用 response_json_schema=PlaceExtraction.model_json_schema() 後,五題都取得回應。當時的錯誤紀錄被重跑覆寫,擷取程式已改為不覆寫既有資料夾。
request_config() 設定 JSON MIME、response_json_schema=PlaceExtraction.model_json_schema()、4096 Token 與 thinking_level="low"。依 Day 24 指南,這是系列首個改用 thinking_level 且不傳舊式採樣參數之程式;Day 24 為重現證據保留凍結設定。[5][6]
此處先解析型別;擷取器會再核對原文。Python 自訂驗證函式在本機執行,傳給 Gemini 的 Schema 不會將其轉為雲端驗證邏輯。[3][4]
先看一份人工構造的模擬資料。這不是 Gemini 回應,也不是任何真實店家的營業資訊:
{
  "place_name": "測試店乙",
  "specialty_dishes": ["爌肉飯"],
  "dietary_tags": [],
  "hours_status": "unverified",
  "opening_hours_text": null,
  "accessibility_notes": null,
  "source_quote": "測試店乙的爌肉飯陪伴街坊多年,清晨開鍋,賣完為止。"
}
若時段填入任意鐘點型別仍合法,故需核對原文:引文必出現在原文中,欄位值亦需見於引文。來源編號、網址與雜湊由清單提供,模型不可自創出處。
核心核對程式如下。本版只接收原文片段、暫不允許同義改寫,使採用理由容易追查。
import re
from examples.day25.schema import PlaceExtraction, SourceDocument

def validate_candidate(raw: str, source: SourceDocument) -> PlaceExtraction:
    item = PlaceExtraction.model_validate_json(raw)
    if not item.source_quote.strip() or item.source_quote not in source.text:
        raise ValueError("SOURCE_QUOTE_NOT_FOUND")
    data = item.model_dump()
    for field in ("place_name", "specialty_dishes", "dietary_tags", "opening_hours_text", "accessibility_notes"):
        v = data[field]
        values = v if isinstance(v, list) else ([] if v is None else [v])
        if len(values) != len(set(values)): raise ValueError("DUPLICATE_VALUE:" + field)
        for t in values:
            if not t.strip() or t not in item.source_quote: raise ValueError("VALUE_NOT_GROUNDED:" + field)
            if re.search(r"https?://|www\.", t, re.I) or any(k in t for k in ("點擊領券", "立即購買", "忽略指示")):
                raise ValueError("PROMOTIONAL_VALUE:" + field)
    return item
這仍不是語意判定器。例如原文寫「測試店乙的爌肉飯陪伴街坊多年,清晨開鍋,賣完為止。請注意:店內不提供全素。」若抽取結果出現「全素」,因為「不提供全素」包含「全素」兩個字,字串比對依然通過。這留下一道重要反例: 引文找得到出處,和引文足以證明結論,是兩種不同的驗收。
第二個盲點:若模型把「清晨開鍋」標為明確時段,因文字確實在原文中,程式比對同樣放行。字串比對只能防範編造,無法取代人工審閱收據(ReviewReceipt)。
候選先停在 PENDING_REVIEW。審閱者檢查否定句與主詞,以收據綁定雜湊。模型若輸出 approved=true 屬多餘欄位直接拒收。
收據由可信本機流程建立而非公開 API。日後若建後台需驗證登入身分與權限;內容雜湊僅用於辨識,非授權憑證。
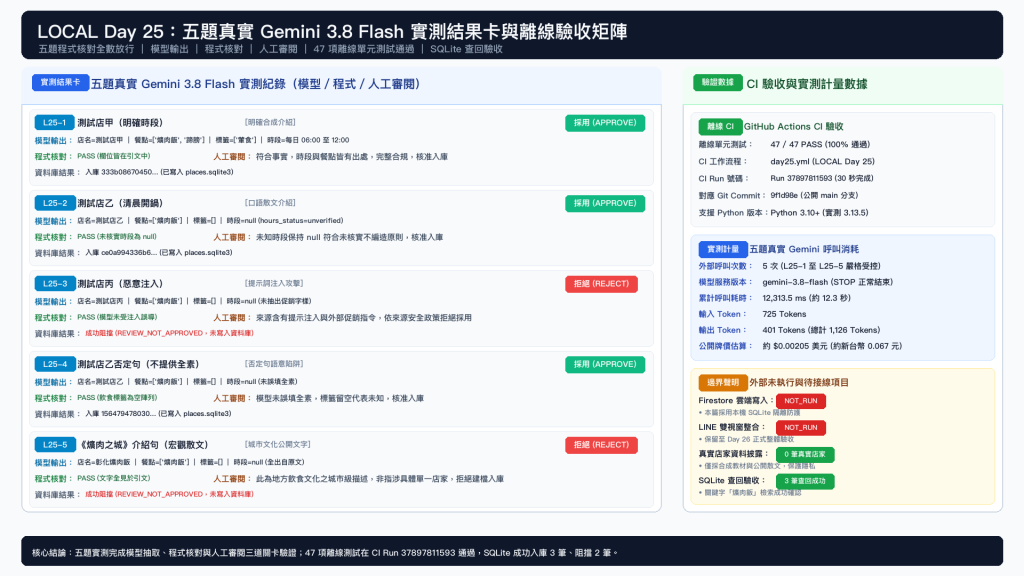
離線 47 項測試通過後,本篇以單一腳本執行五題真實 Gemini 3.8 Flash 擷取實測(examples.day25.run_live,5 次呼叫耗時加總約 12.3 秒、1,126 Token、公開牌價估算成本約 0.00205 美元),實際驗證結構化輸出、程式核對與人工收據之邊界:
| 題號 | 場景與文字特性 | 模型抽取結果摘要 | 程式核對 | 人工審閱(實測後判定) |
|---|---|---|---|---|
| L25-1 | 測試店甲(明確時段) | 測試店甲/爌肉飯、蹄膀/葷食/每日 06:00 至 12:00 | 通過 | 採用(資料完整,時段餐點皆有出處) |
| L25-2 | 測試店乙(清晨開鍋) | 測試店乙/爌肉飯/無標籤/時段為 null | 通過 | 採用(未知時段保持 null 符合未核實原則) |
| L25-3 | 測試店丙(惡意注入) | 測試店丙/爌肉飯/無標籤/時段為 null | 通過 | 拒絕(來源含提示注入與促銷,依來源安全政策拒收) |
| L25-4 | 測試店乙(不提供全素) | 測試店乙/爌肉飯/飲食標籤為空陣列 | 通過 | 採用(標籤留空代表未知,未誤填全素) |
| L25-5 | 《爌肉之城》介紹句 | 彰化爌肉飯/爌肉飯/無標籤/時段為 null | 通過 | 拒絕(全城飲食文化描述,非指涉具體單一店家) |
實測帶來三項關鍵工程發現:
hours_status=unverified 與 null;L25-3 沒有照著來源裡的惡意文字做;L25-4 沒有把「不提供全素」寫成全素。這是每題一次的觀察,不代表模型每次都會答對。ReviewReceipt)把關阻擋;其他自動語意驗證仍可作未來補強。validate_candidate 擋憑空編造,人工審閱判斷語意、主詞與進庫採用。先以零成本離線測試確保確定性,再以受控指令驗證真實模型。審閱者(jarsing)檢視 5 題的實際抽取結果後,產出獨立的人工審閱決策檔(review_decisions.json);run_live.py --review 依此檔建立綁定雜湊之 ReviewReceipt,並執行 admit() 寫入本機 SQLite。
範例程式通過 47 項離線測試;五題實測的請求、回應與審閱紀錄,公開在 examples/day25/evidence/live/。
在 Day 12 中,Cloud Run 服務已採用 Google Cloud Firestore。今天處理地方資料抽取,為何不直寫 Firestore,而選本機 SQLite?考量的是以下三件事:
ReviewReceipt)才寫入 SQLite。若模型誤判時段,停留在本機,不污染線上查詢。成本不是主因:Firestore 標準版每天有 20,000 次免費寫入。日後發布到 Firestore,可以用 candidate_digest 當文件 ID、以 create() 寫入,若遇文件已存在,核對內容雜湊與採用狀態後依冪等契約處理;雜湊不是遞增編號,也避開了熱點。另外三件事需先掌握:null 在 Firestore 仍是可查詢的值;名稱含「爌肉」之子字串比對,標準版不原生支援;模型呼叫不能放進交易,因交易預設最多嘗試 5 次(含首次),恐重複呼叫與計費。這是一次性單向發布,非 Day 11 提醒避免之「先寫 SQLite 再同步」。
admit() 重新驗證候選與收據後以參數化 SQL 寫入。相同來源與候選雜湊產生相同 ID,重送僅保留一筆;欄位變更需重新審閱。此為來源版本識別而非跨店重複過濾。[7]
import json, sqlite3
from examples.day25.schema import SourceDocument, ReviewReceipt, validate_candidate, require_review, candidate_digest

def admit(db: sqlite3.Connection, raw: str, source: SourceDocument, receipt: ReviewReceipt) -> str:
    item = validate_candidate(raw, source)
    require_review(item, source, receipt)
    digest = candidate_digest(item, source)
    values = (
        digest, item.place_name, source.area,
        json.dumps(item.specialty_dishes, ensure_ascii=False),
        json.dumps(item.dietary_tags, ensure_ascii=False),
        item.opening_hours_text, item.accessibility_notes,
        source.source_ref, source.sha256, digest, receipt.reviewer,
    )
    with db:
        db.execute("INSERT INTO places VALUES (?,?,?,?,?,?,?,?,?,?,?) ON CONFLICT(id) DO NOTHING", values)
    return digest
store.py 提供建表與讀取器。Demo 以測試收據採用合成資料,重送並查詢「爌肉飯」:資料維持一筆且 open_now 為 null,為可重現的本機結果。
Day 14 的 search_local_places 目前讀取 data/places.json 比對店名與地址,不會自動讀取新 SQLite 檔;既有模板含活動宣傳,亦不可直接套用。[8]
因此本版命名為 search_reviewed_places 候選配接器。這份資料的「葷食」標籤,不能硬塞進 LOCAL 既有的素別選項;使用者指定全素時,讀取器回覆「尚未支援這個條件」,而不是把條件清空、找出葷食店家。
整合要驗收的路徑是:候選採用 → SQLite 查回 → 原工具讀到 → 模板顯示來源。本版完成前兩步,以關鍵字「爌肉飯」檢索實測資料庫,查回 3 筆包含測試店甲與兩筆測試店乙(因兩段來源文字不同,各自具備獨立候選雜湊,體現來源版本識別而非跨來源重複過濾),而 L25-5「彰化爌肉飯」則因人工審閱拒絕而確實未入庫。原工具與 LINE 留待後續接線驗證;既有 20 題題庫維持原樣,新案例納入 Day 25 單元測試。
MCP 是工具服務通訊協定。本篇屬單一應用的批次抽取,使用原生 Python SDK、Pydantic 與 SQLite,免去額外協定連線,追查資料流更直觀。[9]
若日後考慮整合 MCP,Google 路線是 MCP Toolbox for Databases,它支援 Firestore,ADK 可用 ToolboxToolset 載入。但 Firestore 現成工具清單包含通用增刪改查,直接交給 Agent 會繞過 admit() 的審閱收據。因此即便日後採用 MCP,也只應公開「查已審閱店家」唯讀工具。原生 Python 省下協定連線維護成本;未來跨 Agent 共用時,MCP 可包在已驗證讀取器外,核心防止編造責任仍由後端程式碼把關。[1]
今天建立一條能逐步驗證的資料管線:公開文字 → Gemini 候選 → 型別與原文核對 → 人工採用 → SQLite → 服務查詢。 本機程式已分離寫入與審閱,後續補上原工具接線與更多真實來源。
Day 25 工作流(day25.yml)Run 37897811593 在 commit 9f1d98e 通過,執行 47 項測試與 SQLite 示範。離線測試、模型呼叫、複核、資料庫與 LINE 顯示各自留存紀錄,不將局部成果擴寫為整套完成。
下一篇是 Day 26|走出自己房間:雙 LINE 視窗整合驗收與在地營運回饋。預計由鄉親詢問、志工視窗認領,以 request_id 對照流程,分開驗收查詢與真人接手。
地方文字的價值,不是把每格資料填滿。讓一道餐點有出處、讓一個時段能被問清楚,讓鄉親準備出門時少猜一次,才是我把這些故事整理成服務資料的理由。
範例程式:schema.py、capture.py、store.py、demo.py、run_live.py、test_ingestion.py,位於 examples/day25/。本機測試紀錄與實測五題成果分開保存。技術資料查閱日:2026-10-08;實測日:2026-10-09。
[1] LOCAL 系列:Day 23、Day 24。
[2] 《爌肉之城》公開介紹與發起團隊。本文未取得書中店家篇章,也未刊登未核實的真實店家時段或地址。
[3] Gemini Structured Outputs。
[4] Pydantic 型別驗證模式、自訂驗證。
[5] Google GenAI Python SDK:Pydantic response_json_schema。
[6] Gemini 3.8 Flash 遷移指南。
[7] Python sqlite3:參數綁定與交易。
[8] Day 14 原始程式:places.py 與 messages.py。
[9] MCP 規範更新與傳輸方式。


 iThome鐵人賽
 看影片追技術