
兩位助教各自改完一疊考卷,都已經依分數由低到高疊好,現在要合成一疊。最省事的做法是:比較兩疊最上面那張,把分數低的放到新的一疊,一直重複到兩疊都拿完。每比較一次就確定一張的位置,完全不用回頭。
把兩段排好的資料合成一段,稱為合併(merge)。既然合併這麼容易,就把亂序的資料一直對半切,切到每段只剩一筆(一筆本身就是排好的),再兩兩合併回來,這就是合併排序(merge sort)。它和快速排序剛好相反:快速排序先挑基準、把資料分到兩邊才遞迴;合併排序切的時候不看資料,直接從中間切,真正的工作都在合併。
以下 n 代表資料筆數,我們繼續用前面排序方法使用的 8 筆資料:
26 59 1 61 5 15 11 37
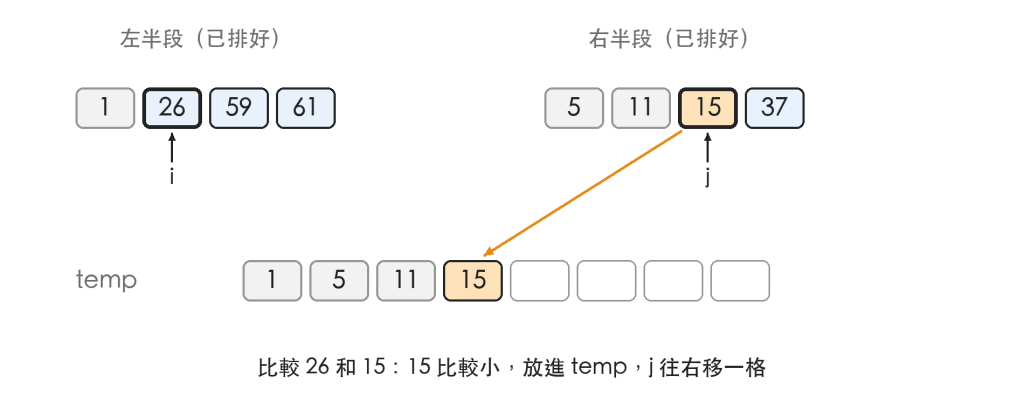
左半段和右半段都已經由小到大排好,要合併到暫存陣列 temp:
data[i] 和 data[j],把較小的放進 temp。拿左邊的就把 i 加 1,拿右邊的就把 j 加 1;相等時先拿左半段的。以最後一次合併為例,左半段是 1 26 59 61,右半段是 5 11 15 37。下圖已經放好 1、5、11(灰色),正在比較 26 和 15,橘色是這一步放進 temp 的資料:
設左右兩段各有 n₁、n₂ 筆。每筆資料都會放進 temp,再搬回原陣列,不需要反覆找位置,所以合併的時間和總筆數成正比,是 O(n₁ + n₂)。
(left + right) / 2。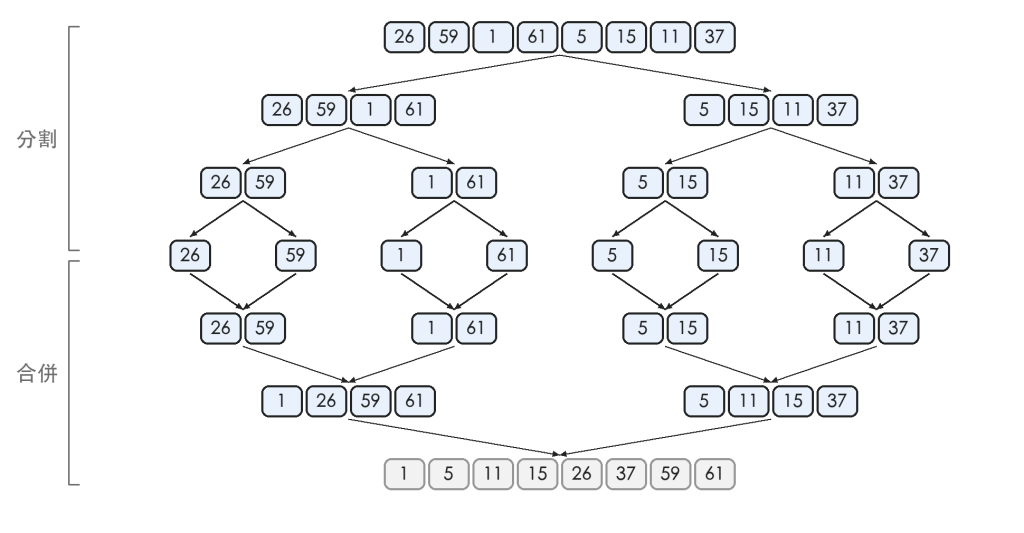
上半部畫的是怎麼切,下半部畫的是怎麼合併。實際執行時,程式會先把左半邊排好,再把右半邊排好,最後合併這兩段。這和二元樹的後序走訪一樣,都是「先左、再右、最後處理自己」。
#include <stdio.h>

#define SIZE 8

void printRange(const int data[], int left, int right) {
    for (int i = left; i <= right; i++) {
        printf("%d ", data[i]);
    }
}

/* 把 data[left..middle] 和 data[middle+1..right] 兩段排好的資料合併 */
void merge(int data[], int temp[], int left, int middle, int right) {
    int i = left;       /* 左半段目前看到的位置 */
    int j = middle + 1; /* 右半段目前看到的位置 */
    int k = left;       /* temp 下一個要放的位置 */

    while (i <= middle && j <= right) {
        if (data[i] <= data[j]) {
            temp[k++] = data[i++]; /* 相等時先拿左邊,保持穩定 */
        } else {
            temp[k++] = data[j++];
        }
    }
    while (i <= middle) {
        temp[k++] = data[i++]; /* 右半段拿完了,左半段剩下的照順序接上 */
    }
    while (j <= right) {
        temp[k++] = data[j++];
    }
    for (k = left; k <= right; k++) {
        data[k] = temp[k]; /* 合併好的結果搬回原陣列 */
    }
}

void mergeSort(int data[], int temp[], int left, int right) {
    if (left >= right) {
        return; /* 只剩 1 筆,本身就是排好的 */
    }

    int middle = (left + right) / 2;
    mergeSort(data, temp, left, middle);
    mergeSort(data, temp, middle + 1, right);
    merge(data, temp, left, middle, right);

    printf("合併 [%d..%d]:", left, right);
    printRange(data, left, right);
    printf("\n");
}

int main(void) {
    int data[SIZE] = {26, 59, 1, 61, 5, 15, 11, 37};
    int temp[SIZE];

    mergeSort(data, temp, 0, SIZE - 1);

    printf("排序結果:");
    printRange(data, 0, SIZE - 1);
    printf("\n");
    return 0;
}
執行結果:
合併 [0..1]:26 59
合併 [2..3]:1 61
合併 [0..3]:1 26 59 61
合併 [4..5]:5 15
合併 [6..7]:11 37
合併 [4..7]:5 11 15 37
合併 [0..7]:1 5 11 15 26 37 59 61
排序結果:1 5 11 15 26 37 59 61
temp 只在 main 裡準備一份,所有遞迴呼叫共用。每次合併只用到索引 left 到 right 的範圍,而且合併完就把結果搬回 data。下一次合併時,可以直接重用 temp,不用每次都準備新的陣列。
這個版本的時間一律 O(n log n)。 每次都從中間切,資料筆數大約減半。像 8 筆資料會切成 4 筆、2 筆、1 筆,共切 3 次;一般來說,大約要 log₂ n 層。
合併時,同一層要處理的資料總共最多 n 筆,所以每層花 O(n)。大約 log₂ n 層乘上每層 O(n),總共就是 O(n log n)。不管資料原本是亂序、已排好,還是完全相反,程式都照樣切開、合併,所以最好、平均、最壞時間都是 O(n log n)。
額外空間 O(n)。 陣列版本需要和原陣列一樣大的 temp,所以不是只用固定幾個暫存變數的原地排序。遞迴也要記住每一層執行到哪裡,這些資訊放在呼叫堆疊中,占 O(log n)。加上 temp 的 O(n),整體額外空間仍是 O(n)。
合併排序是穩定的,也就是相同數字排完後仍保持原本的先後順序。 例如紅 5 原本在黑 5 前面,分到左右兩段後,合併時遇到兩個 5,程式用 data[i] <= data[j] 先拿左邊的紅 5,所以紅 5 仍在黑 5 前面。如果把 <= 改成 <,相等時就會先拿右邊,這個版本就不再穩定。
| 項目 | 快速排序 | 合併排序 |
|---|---|---|
| 怎麼切 | 依基準分成兩群,大小看資料 | 從正中間切,和資料無關 |
| 主要工作 | 遞迴之前的分割 | 遞迴之後的合併 |
| 時間 | 平均 O(n log n),最壞 O(n²) | 一律 O(n log n) |
| 額外空間 | 平均 O(log n) | O(n) |
| 穩定 | 否 | 是 |
表中快速排序的平均表現,假設鍵值互異、排列隨機。
合併排序先一直對半切,再把排好的小段合併回來。切的位置和資料內容無關,所以最好、平均、最壞時間都是 O(n log n)。代價是陣列版本需要 O(n) 額外空間;合併時相等的資料先拿左邊,就能保持穩定。
今日重點:
有沒有一種排序,既保證 O(n log n)、又不需要額外的暫存陣列?答案就藏在累堆裡。下一篇把整個陣列變成一座最大累堆,讓最大值一個接一個從樹根退場、排到陣列尾端,排好的資料就會從後面往前慢慢長出來。


 iThome鐵人賽
 看影片追技術