

上一篇的 Ops Agent 再方便,也需要使用者主動提出需求 Agent 才會進一步處理,但是網站上有很多潛在的隱藏問題並不是那麼容易被使用者發現:某個品牌的購買連結失效了、上架品牌的主圖不見了、半夜該跑的資料整理工作其實沒有跑,或是新改的程式不小心讓搜尋按鈕按不下去。有部分的問題我們可以用 Sentry 來追蹤(例如:用戶點擊到失效的連結),但有些內容則沒辦法(例如:資料處理沒有跑、購買連結失效等)。為了「主動」找到這些潛在問題,每天半夜我會跑下列兩個 Agentic Workflow:
這一篇就來聊聊這兩個 Agent 怎麼運作、檢查完的結果怎麼處理,以及想自己做一套要從哪裡開始。
之前談上線監控的那一篇,介紹過日誌、儀表板和告警這些方法,用來發現系統有沒有異常。這篇的 Health Agent 和 E2E Testing Agent,則是「主動」去大範圍檢查網站和資料庫的健康狀態,確認原本應該成立的條件都還成立,例如每個上架品牌的購買連結,都應該連到品牌自己的商店;探索頁的搜尋框,輸入關鍵字後要能送出查詢。這些條件不再成立的時候,只要沒有使用者剛好用到這個功能,系統通常不會留下任何錯誤紀錄,前面提到的監控也抓不到,因此需要這兩個 Agentic Workflow 主動去把問題找出來。
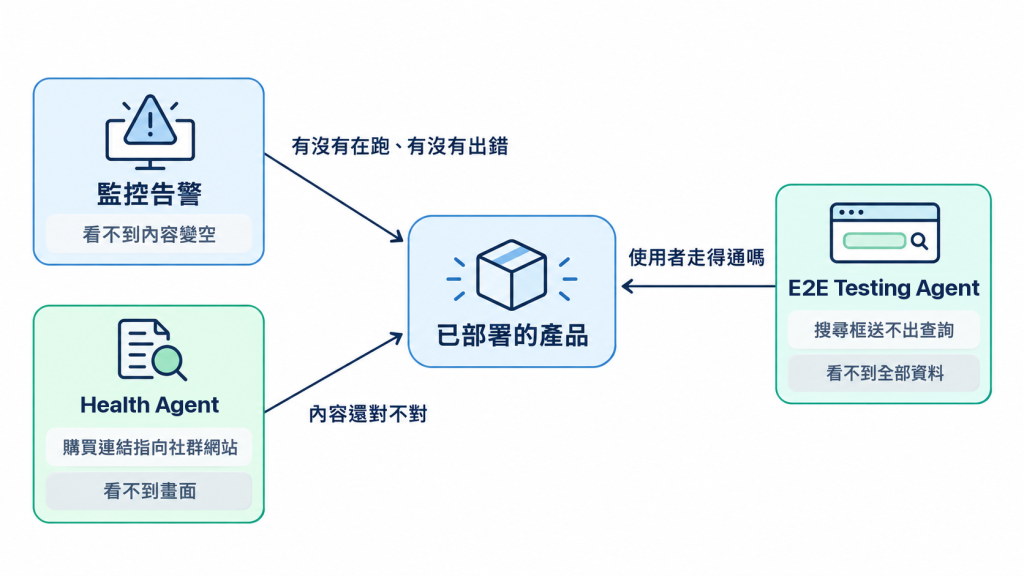
Health Agent 直接讀資料庫和外部服務,檢查的內容大致可以分成以下幾類:
查出問題之後,Health Agent 會自己判斷下一步。以程式錯誤為例,它會先讀過錯誤內容,判斷嚴重程度、可能的原因,以及能不能直接修,再決定怎麼處理:
整段流程不需要我開口,我只要審核 PR、處理 ticket 就好。
E2E Testing(End-to-End Testing,端對端測試)是軟體開發裡很常見的做法:先定好使用者會怎麼操作、操作完應該看到什麼,再用程式照著走一遍,確認網站的表現跟預期的一樣。Health Agent 看得到資料,卻看不到畫面;使用者卡在某個按鈕上的問題,要靠 E2E Testing Agent 來抓。它每天清晨會對 staging 跑一輪測試。
為什麼測的是 staging,而不是正式網站?主要有兩個原因:
我用的是 Playwright,一個常用的瀏覽器測試工具。Playwright 的最佳實務指引裡有兩個建議:
E2E Testing 的每一個測試,驗證的都是一段真實的使用者流程,例如輸入關鍵字、按下搜尋、看到搜尋結果,看的是整段操作做完之後,結果對不對。某個按鈕、某個函式單獨運作正不正常,則是單元測試(unit test)的工作。這兩種測試要分開來寫:單元測試抓得到元件本身的錯誤,卻看不出元件之間有沒有接好;E2E Testing 看得出整段流程走不走得通,卻不容易指出是哪一個元件壞掉。
下面這段範例程式,測試的是一個搜尋流程:打開探索頁,在搜尋框輸入「送禮」,按下搜尋,再確認網址帶有查詢參數、畫面出現對應的結果標題。
import { test, expect } from "@playwright/test";

test("搜尋後,網址帶有查詢參數、畫面出現結果標題", async ({ page }) => {
  await page.goto("/discover"); // 打開探索頁
  await page.getByLabel("搜尋商品").fill("送禮"); // 用欄位標籤找到搜尋框,輸入「送禮」
  await page.getByRole("button", { name: "搜尋", exact: true }).click();
  await expect(page).toHaveURL(/q=/); // 網址帶有查詢參數
  await expect(
    page.getByRole("heading", { name: "符合「送禮」的商品" })
  ).toBeVisible(); // 畫面出現結果標題
});
每個測試跑完,會有三種結果:
不穩定的測試最容易被忽略,因為重試之後就通過了。但它背後可能藏著兩種問題:
放著不管的話,我們就無法確定這個測試到底是不是真的通過;而且不穩定本身就是一個訊號,代表測試或網站有地方需要調整。所以我會在每天的 Slack 摘要裡,單獨列出不穩定測試的數量。
每天半夜這兩個 Agentic Workflow 跑完之後,要怎麼接回前面談過的 Human-in-the-loop,讓我來做最後判斷呢?我們目前將結果分成三條路:
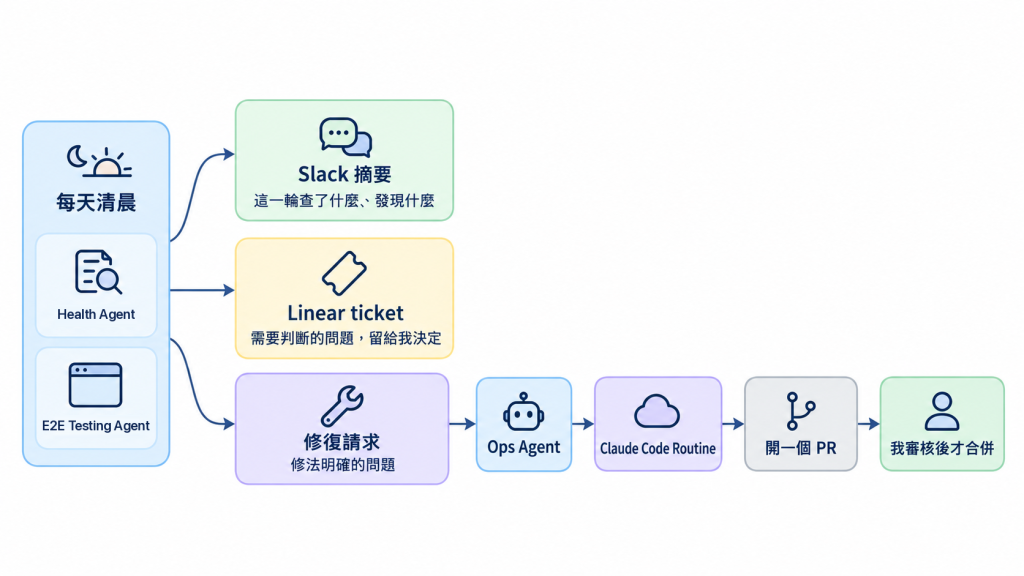
為什麼不讓 Health Agent 和 E2E Testing Agent 直接叫 Claude Code,而要經過 Ops Agent?因為這樣一來,不管是我在 Slack 開口,還是這兩個 Agent 自己發現的問題,修正工作都從同一個入口出去,紀錄也都留在 Slack 的討論串裡,事後要追查比較方便。


 iThome鐵人賽
 看影片追技術