
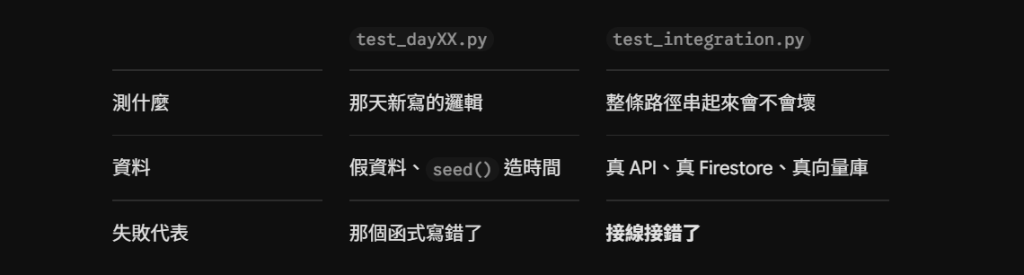
在前八天完成記憶治理(Memory Governance)、語料庫加強、系統韌性與記憶庫介面之後,這個 Agent 的每一個模組都被單獨測過了:test_day24 到 test_day28,一天一支,全部通過。
但「每個零件都正常」跟「整台機器會動」是兩件事。今天要驗的是整條路徑:
使用者說一句話 → 分流 → 好感度評分 → RAG 檢索 → 主對話 → 工具呼叫
→ 好感度落地 → 訊息落地 → 記憶提取 → 下一輪撈得到
這條鏈上有兩個角色、四個資料源(session、Firestore、ChromaDB ×2)、三個 API 呼叫。任何一段接錯,前八天的測試都不會發現,因為它們測的都是自己那一段。
然而動手第一分鐘就卡住了:主流程沒有任何函式可以被測試呼叫。
它整段寫在 app.py 裡:
if user_input := st.chat_input("跟你的角色說點什麼吧..."):
    ...
    result = triage.triage(client, user_input, char_id=char_id)
    if intent == "CHAT":
        preview = st.session_state.fsm.preview_affection(delta)
        ...
這是 Streamlit 腳本的一部分,跟 st.session_state、st.chat_input 綁死。要測,只能在測試檔裡複製一份同樣的邏輯,而複製出來的那份,跟真正在跑的那份會慢慢漂移。測過了也不代表 app 是對的。
測不到的程式碼,等於沒有被驗證過的程式碼。
conversation.run_turn(),切開 UI 與非 UI。分界線畫在 UI 與非 UI 之間:
# conversation.py
def run_turn(client, chat, fsm, char_id, user_id, user_input) -> dict:
    """跑完一輪對話的所有非 UI 工作。

    Returns:
        {"ok": bool, "reply": str|None, "intent": str, "delta": int,
         "rag_context": str, "memory": dict, "error": Exception|None}
    """
run_turn 負責 triage、RAG 組裝、主對話(含退避重試)、好感度落地、訊息落地、記憶提取;app.py 只剩畫氣泡和更新 session_state。
回傳值刻意帶上 rag_context:測試要驗的不只是「有沒有回話」,而是這一輪到底注入了什麼。沒有這個欄位,RAG 是不是真的生效就只能靠讀模型的回覆猜。
create_chat() 也一起抽出來,讓 app 與測試共用同一份 chat 設定,否則會出現「測試用的設定跟實際不同」這種測了也不算的情況。
兩個設計細節值得記:
一、失敗情境用假物件,不要真的把 API 打爆。
class BrokenChat:
    """假的 chat 物件,send_message 一律拋 503。
    用假物件而不是真的把 API 打爆,後者一天只能測一次"""
    def send_message(self, *a, **kw):
        raise errors.ServerError(503, {"error": {"message": "fake overload"}})
二、節流是必要的,不是保險。 一輪對話打 3 次 API,八個案例沒節流就會撞 429,Day 27 的量測腳本就是這樣把自己打爆,還印出一份漂亮的假數據。所以每輪之間 time.sleep(8)。
抽完 run_turn 之後,app.py 底部還留著一份舊的 memory_extractor.extract_and_store(...)。而 run_turn 內部已經做了記憶提取,同一句話會被提取兩次。更糟的是我順手把 import memory_extractor 清掉了,所以那行一執行就是 NameError。
這種錯誤 grep 一下就抓到,但不重構就不會產生它。重構的代價要算進來。
案例 2 的預期是「第二輪問名字,RAG 要撈到剛提取的『使用者的名字是阿哲』」。實際跑出來:
[lily] '你還記得我叫什麼名字嗎?' → TASK / delta +0 / OK
RAG Context 含「阿哲」:False
「你還記得我叫什麼名字嗎?」被 triage 判成 TASK。 而 TASK 是精準模式、不組 RAG context,於是這個「最需要長期記憶的問題」,剛好是唯一拿不到長期記憶的路線。
案例 2 表面上還是答對了(回覆裡有「阿哲」),但那是因為同一個 chat 物件還帶著短期歷史。案例 4 換成時刻、全新的 chat,她就真的想不起來了。如果只看回覆,這個 bug 會完全隱形。
根因在 triage 的判準寫得太寬:
- TASK : 明確要求她動手完成一件事,或需要查詢資料才能回答。
                                    ^^^^^^^^^^^^^^^^^^^^^^
「記得我的名字嗎」讀起來就像在查資料。修法是收緊定義並補上明確反例:
- TASK : ...或需要**外部資料/工具**(網路查詢、計算、翻譯)才能回答。

【特別注意:問「她記不記得」是 CHAT,不是 TASK】
「你還記得我的名字嗎?」這類問題雖然是在問資訊,
但那是**她自己的記憶**,不是外部查詢,屬於角色互動 → CHAT。
判成 TASK 會讓她切成精準模式、拿不到長期記憶,反而想不起來。
七個案例(三個記憶類 + 四個原本的 TASK 回歸)全部正確。
案例 4 我原本寫了一條斷言「時刻的 context 不該有『薄餅』」,結果是 False。第一反應是隔離破了,細看才發現我的斷言寫錯了,「使用者喜歡吃薄餅」是使用者記憶,跨角色共用,出現在時刻的 context 是正確行為。
但把斷言改成分區塊檢查之後,真正的問題浮出來了。實測提取器:
輸入:莉莉做的薄餅超好吃,我最喜歡吃那個了
  [preference] 使用者非常喜歡吃莉莉做的薄餅。   ← 夾帶角色名!
這筆是使用者記憶,會被時刻檢索到,她就此知道「莉莉」存在。char_id 隔離從 Day 22 守到 Day 28,卻可能被使用者記憶這條側門整個繞過。
修法兩層,跟這個專案一路的原則一致(約束比祈求可靠):
def _mentions_character(text: str) -> bool:
    """選擇整筆丟棄而不是把名字挖掉:挖掉會產生「使用者喜歡做的薄餅」
    這種讀不通的句子,注入 prompt 只會讓模型亂猜。
    丟掉一筆喜好,使用者下次還會再提;洩漏一次角色存在,收不回來。
    """
    for name in _character_names():
        if name in text:
            print(f"[memory_extractor] 事實夾帶角色名「{name}」,整筆丟棄:{text}")
            return True
    return False
修完再測同一句,寫成中性的「使用者喜歡吃薄餅。」,事實留住了,角色名去掉了。
【1】莉莉走完整 CHAT 路線
  好感度:20 → 30(Firestore 實際值 30)
  Firestore 訊息數:2 筆
  提取到的記憶:['使用者的名字是阿哲。', '使用者喜歡吃薄餅。']

【2】RAG Context 含「阿哲」:True|回覆含「阿哲」:True
【3】history 裡的 function_call:['get_user_status']|TASK 不落地好感度:True
【4】時刻的 RAG 也有「阿哲」:True|角色設定區塊不含莉莉設定:True
     好感度:lily 30 / shike 22 ← 各自獨立
【5】好感度 50:lily=TSUNDERE  shike=AMUSED ← 同一個數字,不同狀態名
【6】失敗前後:好感度 30/訊息 6 筆/記憶 2 筆 → 三項都沒變:True
【7】降級中:記憶提取 [],但角色有回話:True
案例 6 是我最在意的一條:失敗的那一輪,好感度、訊息、記憶三個數字必須完全一樣。 這條驗的是從 Day 21 就立下的「先確認回應成功才落地」,而它只有在整合測試裡才驗得到,單獨測 fsm 或 db 都看不出三者有沒有同步。
實作的最後一天,做的事情有點反直覺:我沒有寫任何新功能,卻改動了最核心的檔案。
最大的收穫是那句「測不到的程式碼等於沒被驗證」。前八天我每天都寫測試,自認覆蓋得不錯,但主流程,真正串起一切的那段,從頭到尾沒有被測過一次,因為它根本沒有入口。單元測試的覆蓋率會給你一種安全感,而那個安全感的形狀,剛好就是你程式碼的形狀。 難測的地方不會出現在覆蓋率報告裡,它只是不在那裡。
第二個收穫是關於 bug 的分布。三個 bug 沒有一個是「某個函式算錯」,全部都是接線問題:重構殘留的重複呼叫、分流把記憶問題送錯路線、記憶內容繞過隔離邊界。每個模組單獨看都對,合起來才錯。整合測試不是把單元測試加起來,它測的是另一種東西。
最後一個,也最值得記:bug 2 表面上是「答對了」的。回覆裡確實有「阿哲」,只有去看 rag_context 才知道記憶根本沒被注入。如果我的 run_turn 沒有回傳 rag_context,這個 bug 會一路活到 demo。



 iThome鐵人賽
 看影片追技術