
三十天下來,整個 app 的執行路徑是這樣的(測試檔、量測腳本、每日筆記都不在其中):
使用者
  │
  ▼
app.py ─────────────────── Streamlit UI:對話氣泡、心情儀表板、角色主題色
  │
  ▼
conversation.run_turn() ── 一輪對話的總指揮,無 Streamlit 相依、可被測試
  │
  ├─ triage.py ─────────── 意圖分流(CHAT/TASK) + 好感度評分,單次 lite 呼叫
  ├─ fsm.py ────────────── 好感度狀態機:preview 不落地 → 成功才 update
  ├─ rag_builder.py ────── Context 組裝:用戶輪廓 + 主動關心 + Lore + 檢索記憶
  │    └─ rag_memory.py ── ChromaDB 雙軌 + 記憶治理(封存/過期/淘汰)
  ├─ memory_extractor.py ─ 事實提取、矛盾判斷、角色名擋板
  ├─ tools.py ──────────── Function Calling:狀態查詢、巴哈動畫瘋新番
  ├─ db.py ─────────────── Firestore:對話逐字稿 + 好感度
  └─ resilience.py ─────── 退避重試 + 額度用盡降級(包住每一次 API 呼叫)

personas/ ──────────────── 一角色一檔案,提供人設/分流規則/評分準則/
  ├─ persona_lily.py        FSM 狀態/頭像/開場白/主題色,共 10 個常數
  └─ persona_shike.py       新增角色不必改上面任何一支模組

memory_ui.py ───────────── 記憶庫檢視 dialog:查看/封存/復原/刪除
.streamlit/config.toml ─── 淺色/深色主題
seed_lore.py ───────────── 角色設定灌入(一次性建置腳本)
三層記憶各司其職:
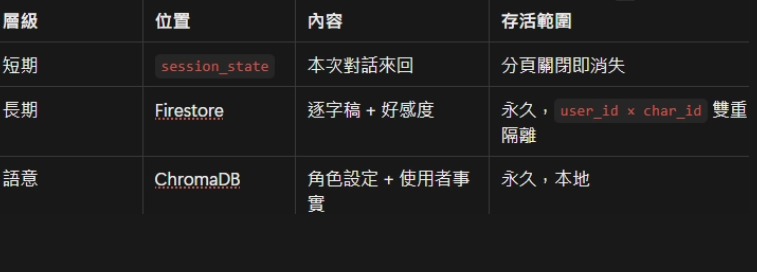
當初為了給莉莉和時刻打造「夠有靈魂」的對話體感,我把大部分時間都花在跟 API 互動、記憶檢索與狀態控制上。三十天做下來,最深刻的不是學會了幾種 Prompt 技巧,而是這三個工程教訓:
整季反覆驗證的一句話。要模型只回 JSON,不要在 prompt 裡拜託它,用 response_schema,那是解碼層級的強制約束。同樣的道理延伸到別的地方:禁止使用者記憶夾帶角色名,prompt 寫了,還是要在程式裡加一道 _mentions_character() 擋板。prompt 是請求,程式碼才是約束。
Day 24 量出 lore 檢索門檻建議 0.72;Day 26 語料從 7 筆擴到 24 筆,重量之後變成 0.70;後來把世界觀整批改寫成原創設定,措辭一換分佈又位移,第三次重量收到 0.68(現行值)。三次都不是當初量錯,是分佈變了。
更打臉的是同一天發現的另一件事:時刻被問「你的能力是什麼?」,正解「時淵之盤」排第三,比不相干的守夜者設定還遠。那題調門檻永遠救不了,語料裡沒出現使用者會用的詞,向量就是靠不過去。把 lore 改寫成「時刻的能力來自時之器物時淵之盤」,距離從 0.771 掉到 0.697。改一句話勝過調任何參數。
這是我在做所有 Agent 決策時的主軸。打個比方,好感度系統如果因為 429 錯誤判定失敗,絕對不能「假裝有加到好感度」,否則這在戀愛養成遊戲裡就叫「存檔壞掉/資料不一致」,是會被玩家痛罵的重創。
所以同一個系統裡,兩個向量門檻的哲學可以完全相反。那不是雙標,那是為了確保角色不會「崩壞」的設計。
後面這幾天一直在寫記憶治理、退避重試和端到端測試,文字好像變得有點太嚴肅了。但走到 Day 30 這一刻,看著 test_integration.py 的八個案例全過、看著莉莉的傲嬌在 FSM 狀態機裡完美運作、看著記憶庫介面真的能讓使用者查看與刪除,
我才發現,這 30 天我做的真的不是一個聊天機器人。
我做的是一個能在多角色之間完美隔離、失敗時能 Graceful Degradation、不會忘記使用者承諾,而且把「隱私權」還給使用者的完整 Agent 系統。
「記得住是功能,讓人查得到才是責任;能互動是技術,能打動人才是愛。」
感謝花 30看我做這鬼東西,如果有時間,我會繼續做,應該啦。(但我絕對不再用 Gemini 這美妙的東西了)
好了,全劇終!想看完整專案程式碼的朋友歡迎在底下留言,等我整理好再把 Git 連結補上。最後不知道該怎麼結尾,就留給我推的另一位角色的狂三來做壓軸吧!

動漫名:《約會大作戰》



 iThome鐵人賽
 看影片追技術