
在前四天完成「記憶治理(Memory Governance)」與「語料庫加強(Corpus Quality)」之後,我們的 Agent 已經聰明得有點過分了,她會自動記事、會主動關心、會發現你改了名字、還知道什麼時候該閉嘴不亂講設定。
然而,當這些功能一層層疊上去之後,隨之而來的是系統韌性(Resilience)的災難與死角:
app.py 只有一個大 try/except,任何例外都是「這句話不算數」。資料一致性上是對的,但一次暫時性的 503 過載,就讓使用者白打一句話,而 503 正是我這整季撞最多的錯誤,通常等一秒再送就過了。會壞的系統不可怕,不知道該先放掉什麼的系統才可怕。
今天 Day 27 的核心任務,就是要為整套 Agent 建立一條失敗時的優先順序。我們將補上退避重試(Exponential Backoff)、額度用盡時的降級模式(Graceful Degradation),並且把能合併的呼叫合併掉。
更重要的是,我們要立下一條貫穿全篇的工程防線:輔助功能不該有能力弄死主對話。
先算一下現況,一輪對話到底打幾次 API:
router.classify_intent      意圖分流         1 次
evaluator.evaluate_emotion  好感度評分       1 次
chat.send_message           主對話           1 次
memory_extractor            記憶提取         1 次
judge_relations             矛盾判斷         0~1 次(有灰色地帶候選才呼叫)
                                            ────────
                                            4~5 次
而現在的失敗處理,是一個包住全部的 try/except:
except Exception as e:
    st.error(f"角色沒有回應,API 出錯了:{e}")
    st.info("這句話沒有被記錄,重新整理後會消失,可以直接再說一次。")
四次呼叫、一個 except,於是任何一環出錯,整輪都算不存在。
router + evaluator 併成單次 API,每輪 4 次降到 3 次。test_day27.py,用注入的假錯誤驗證重試與降級,不燒真額度。寫重試最容易犯的錯,是「所有例外都重試三次」。
RETRYABLE_CODES = {429, 500, 502, 503, 504}
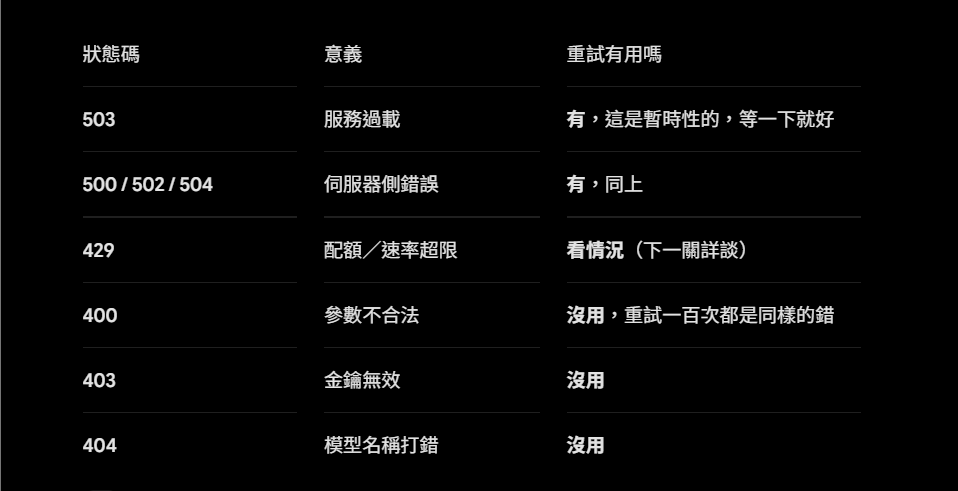
對 400/403/404 重試,唯一的效果是**把失敗時間拉長 N 倍,**使用者要多等 3 秒,才看到同一個必然的錯誤。
而且判斷要建立在型別上,不是字串比對:
def is_retryable(exc: Exception) -> bool:
    # 只認 SDK 的 APIError。其他例外(JSON 壞掉、程式寫錯、KeyError)
    # 重試是白費工,同樣的輸入會得到同樣的錯
    if not isinstance(exc, errors.APIError):
        return False
    return _status_code(exc) in RETRYABLE_CODES
google.genai.errors.APIError 帶了 .code 屬性,ClientError(4xx)與 ServerError(5xx)都繼承它。這比去 parse 錯誤訊息裡的字串可靠得多。
退避還要加抖動(Jitter):
def _sleep_seconds(attempt: int, base_delay: float) -> float:
    """指數退避 + 隨機抖動。

    抖動不是裝飾:沒有它的話,同時撞牆的多個請求會在同一毫秒一起重試,
    等於把尖峰完整複製一次到下一秒(thundering herd)。
    """
    return base_delay * (2 ** (attempt - 1)) + random.uniform(0, base_delay * 0.5)
這是今天整支 resilience.py 的核心,也是整篇文章最想講的一句話:
輔助功能不該有能力弄死主對話。
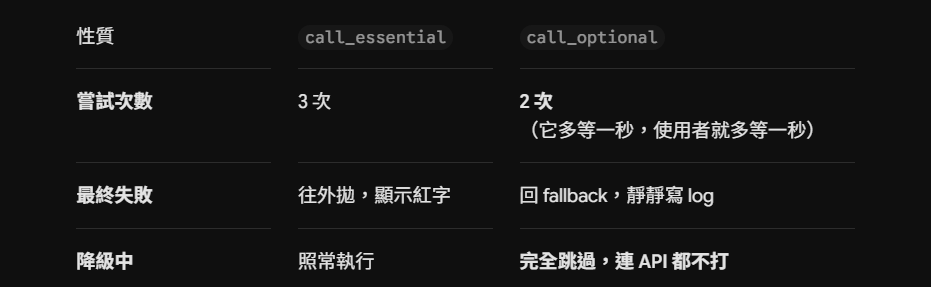
所以我們不寫一個萬用的 retry(),而是刻意把它拆成兩個語意完全不同的函式:
def call_essential(fn, label, max_attempts=3, base_delay=1.0):
    """主對話用:盡力重試,重試完還是失敗就往外拋。

    往外拋是刻意的,主對話失敗使用者必須知道,
    而 app.py 外層已經有 try/except 會顯示紅字並且整輪不落地。
    """

def call_optional(fn, label, fallback, max_attempts=2, base_delay=1.0):
    """輔助模組用(分流/評分/記憶提取/矛盾判斷):失敗就回 fallback,永不拋出。"""
差異不只是「拋不拋」,還有三處:
而每個輔助模組的 fallback,都是它原本就有的保守值:
router    → CHAT    (誤判成 TASK 會讓角色突然變客服,體驗差得多)
evaluator → 0       (好感度會落地,寧可不動也不要亂給)
extractor → []      (寧可不記,也不要記垃圾)
judge     → 全部 DIFFERENT(寧可多存一筆重複,也不要誤封存真的事實)
這些值不是今天才想的,它們在 Day 20、Day 23、Day 25 就各自定好了。今天做的只是讓「API 掛掉」也走同一條收斂路徑。 好的預設值會在你意想不到的地方回報你。
這關我一開始想錯了。
我原本以為,只要每個輔助模組失敗時都回 fallback,額度用盡時系統自然就「優雅降級」了。錯。
假設當日額度用盡,每次呼叫都必定 429。那麼每一輪對話會發生什麼事?
triage    → 打 API → 429 → 重試 → 429 → 回 fallback   (2 次白打 + 等待)
主對話    → 打 API → 429 → 重試 → 429 → 重試 → 失敗   (3 次白打)
extractor → 打 API → 429 → 重試 → 429 → 回 fallback   (2 次白打)
功能上是「優雅」的,體驗上是災難:使用者每說一句話都要等 7 次必敗的請求跑完,才看到一句紅字。
所以降級必須是一個有狀態的模式,而不只是失敗處理:
DEGRADE_SECONDS = 300

def call_optional(fn, label, fallback, ...):
    if is_degraded():
        print(f"[resilience] 降級中,跳過 {label}({degraded_seconds_left()} 秒後恢復)")
        return fallback     # ← 連 API 都不打
而 429 一出現,就立刻進降級模式,不逐一重試:
except Exception as e:
    if is_quota_error(e):
        # 額度問題不必逐一重試:分流、評分、提取會連續撞同一面牆。
        # 直接進降級模式,把剩下的額度留給主對話
        mark_degraded(f"{label} 撞到額度上限 (429)")
        return fallback
這裡有個判斷不了的事實要承認:429 可能是「這一分鐘打太快」(等一下就好),也可能是「當日額度用盡」(等也沒用),從錯誤碼分不出來。 我們選擇一律當成後者處理,理由是:
代價不對稱時,往代價小的那邊倒。 這跟 Day 25 選去重門檻、Day 26 選檢索門檻是同一套思路。
降級狀態當然要讓使用者看得到,所以側邊欄也加了:
if resilience.is_degraded():
    st.warning(f"⚠️ 降級模式({resilience.degraded_seconds_left()} 秒後恢復)")
    st.caption(f"原因:{resilience.degraded_reason()}")
    st.caption("目前暫停:好感度評分、長期記憶提取、矛盾偵測")
    if st.button("立即恢復"):
        resilience.clear_degraded()
        st.rerun()
不講的話,使用者只會發現「今天講什麼好感度都不動」,以為程式壞了,實際上是刻意關掉評分在省額度。沉默的降級跟壞掉沒有區別。
降級是被動防守,主動的做法是少打幾次。
看 router 跟 evaluator 這兩支:
分兩次呼叫等於同一段輸入被 tokenize 兩遍、往返兩趟。合成一次就少一次,這就是 triage.py:
_SCHEMA = {
    "type": "object",
    "properties": {
        "intent": {"type": "string", "enum": ["CHAT", "TASK"]},
        "affection_delta": {"type": "integer"},
    },
    "required": ["intent", "affection_delta"],
}
Prompt 刻意寫成「兩個彼此獨立的任務」並各自編號,而不是混成一段敘述:
【任務一:意圖分類 intent】
...
【任務二:好感度變化 affection_delta】
...
【重要】
兩個任務互不影響:TASK 不代表好感度必為 0,CHAT 也不代表一定是正分。
請分別依各自的判準作答。
最後那段「重要」是必要的。不寫的話模型很容易產生**任務間的污染,**判成 TASK 之後就順手把 delta 給 0,因為「算數學嘛,哪來的感情」。這推論在多數情況下剛好成立,但它是模型自己編出來的規則,不是我們的判準。
但這個合併有風險。 Day 20 量過 router 的分流準確率是 10/10,塞進第二個任務可能讓模型分心而分錯類。所以不能直接上,要 A/B。
measure_triage.py 對傳統 10 個案例,分別跑「分開呼叫」與「合併呼叫」,比對兩件事:intent 準確率(有標準答案)、delta 方向(分數沒有唯一正解,所以只比正負與量級)。
第一次跑,結果是這樣的:
唸書唸得好累                 CHAT/0  CHAT 0  OO   CHAT 2  OO
[resilience] 進入降級模式 300 秒:triage 撞到額度上限 (429)
你會做什麼甜點?             CHAT/0  CHAT 0  OO   CHAT 0  OO
[resilience] 降級中,跳過 router(299 秒後恢復)
[resilience] 降級中,跳過 evaluator(299 秒後恢復)
[resilience] 降級中,跳過 triage(299 秒後恢復)
你做的薄餅真的超好吃…          CHAT/+  CHAT 0  OX   CHAT 0  OX
...
----------------------------------------------------------------
intent 準確率              10/10        10/10
delta 方向一致              7/10         7/10
我今天剛寫好的降級機制,在量測我今天剛寫好的合併功能時,真的觸發了。
一個案例要連打 3 次 lite 模型(router + evaluator + triage),10 個案例 30 次,沒有節流,跑到第 5 案就撞 429。
而更該警惕的是那個 intent 準確率 10/10,它是假的。 降級之後兩邊都只回 fallback,而 fallback 恰好是 CHAT,剩下 5 個案例的正解也恰好都是 CHAT。於是它們「全對」,報告出一個漂亮但毫無意義的滿分。
如果我只看最後那張表就寫結論,我會得到一個完全正確的數字和一個完全錯誤的判斷。
所以量測腳本本身也得修,兩件事:
# 節流。第一次跑這支時沒有節流,量測腳本自己把系統壓垮,就量不到東西了
PACE_SECONDS = 8.0

# 降級一啟動,兩邊都只會回 fallback(CHAT / 0),
# 那不是「判斷結果」而是「沒判斷」。繼續跑只會產出漂亮的假數據,
# 所以直接中止,量測腳本最該避免的就是報告一個自己造成的結論
if resilience.is_degraded() or m["degraded"]:
    print(f"!! 第 {i + 1} 案時進入降級模式:{resilience.degraded_reason()}")
    print("!! 降級後兩邊都只回 fallback,數據已失真,本次量測作廢。")
    sys.exit(1)
這也是為什麼 triage() 的回傳值裡有一個 degraded 旗標,「我判斷不出來」跟「我判斷是 CHAT」必須能被分開。
加上節流重跑,這次是真的數據:
輸入                               正解    分開            合併
----------------------------------------------------------------------------
幫我算 17 乘 23                    TASK/0  TASK 0   OO    TASK 0   OO
幫我把這句話翻成英文:天氣很好     TASK/0  TASK 0   OO    TASK 0   OO
最近巴哈動畫瘋有什麼新番?         TASK/0  TASK 0   OO    TASK 0   OO
唸書唸得好累                       CHAT/0  CHAT 2   OO    CHAT 2   OO
你會做什麼甜點?                   CHAT/0  CHAT 0   OO    CHAT 4   OO
你做的薄餅真的超好吃,我從沒吃過   CHAT/+  CHAT 10  OO    CHAT 10  OO
你姊妹感情真好,看得出來你很重視   CHAT/+  CHAT 10  OO    CHAT 8   OO
你根本什麼都不會,煮的東西很難吃   CHAT/-  CHAT -11 OO    CHAT -9  OO
哈囉                               CHAT/0  CHAT 0   OO    CHAT 0   OO
我等一下要去補習                   CHAT/0  CHAT 0   OO    CHAT 0   OO
----------------------------------------------------------------------------
                                          分開            合併
intent 準確率                             10/10         10/10
delta 方向一致                             10/10         10/10
API 呼叫次數                               20 次          10 次
總耗時                                    36.6 秒        27.5 秒

每輪省下:1 次 API、0.91 秒
→ intent 準確率沒有退步,合併可用
值得注意的是:單次合併呼叫其實比單次分開呼叫「慢」(2.75 秒 vs 1.83 秒,因為 prompt 更長還要出 JSON),但總量還是省了。省的不是單次速度,是往返次數。
router.py 與 evaluator.py 我們沒有刪掉,A/B 需要對照組,而且它們就是這次「合併可用」這個結論的證據本身。
test_day27.py測 API 失敗有個現實問題:要測「撞到 429 會怎樣」,不能靠真的把額度打爆,那還得等一小時才能再測一次。所以全部用注入的假錯誤:
def boom(code: int):
    """製造一個指定狀態碼的 API 錯誤"""
    cls = errors.ServerError if code >= 500 else errors.ClientError
    return cls(code, {"error": {"message": f"fake {code}"}})

class Flaky:
    """前 fail_times 次失敗,之後成功。用來數「到底重試了幾次」"""
    def __init__(self, code, fail_times):
        self.code, self.fail_times, self.calls = code, fail_times, 0

    def __call__(self):
        self.calls += 1
        if self.calls <= self.fail_times:
            raise boom(self.code)
        return f"成功(第 {self.calls} 次)"
base_delay 也調成 0.01 秒,不然光等退避就要跑好幾分鐘。八個案例:
【1】503 過載 → 退避重試後成功
  結果:成功(第 3 次)|總呼叫次數:3

【2】503 一直失敗 → 試滿 3 次才放棄並拋出
  拋出 ServerError 503|總呼叫次數:3(= MAX_ATTEMPTS)

【3】400 參數錯 → 一次就放棄,不重試
  拋出 ClientError 400|總呼叫次數:1

【4】輔助模組(call_optional)失敗 → 回 fallback,不拋出
  回傳:0(fallback)|總呼叫次數:2(輔助只試 2 次)

【5】429 額度上限 → 立刻進降級模式,不浪費次數重試
  回傳:None|總呼叫次數:1(沒有重試)
  降級中:True|原因:triage 撞到額度上限 (429)

【6】降級中 → 後續輔助呼叫完全跳過
  回傳:[]|總呼叫次數:0 ← 必須是 0

【7】降級中 → 主對話不受影響
  目前降級中:True
  主對話結果:成功(第 1 次)|呼叫次數:1

【8】降級有期限,不必手動解除
  剛標記:is_degraded = True(剩 1 秒)
  1.1 秒後:is_degraded = False
案例 3 和案例 6 是我最在意的兩個。
總呼叫次數:0 則是整個降級設計的價值所在。如果這裡是 2,代表我只做出了「失敗才 fallback」,沒做出「降級」。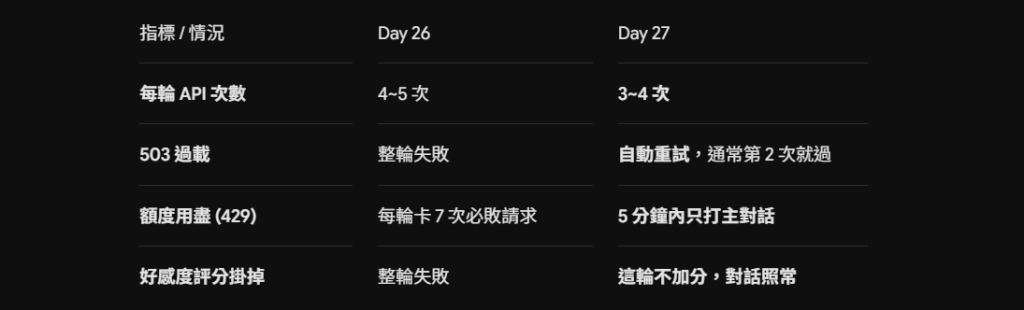


 iThome鐵人賽
 看影片追技術