
前三天我們都在處理「使用者的記憶」,提取、側寫、矛盾偵測、過期淘汰,整套記憶治理(Memory Governance)機制總算建立起來。今天回過頭來看角色自己的腦袋,卻發現一個更根本的問題。
目前的 Lore(角色設定庫)只有 7 筆,而 query_character_lore() 長這樣:
results = lore_collection.query(..., n_results=n_results)
return results['documents'][0]
它永遠會回傳東西。
不管你問什麼,只要庫裡有資料,「最接近的那一筆」就會被塞進 Prompt。所以當你跟莉莉說「我今天好累」,RAG 照樣把「莉莉非常擅長製作各種甜點與手工烘焙」注入 context,於是她會沒頭沒腦地開始跟你推薦烤薄餅。
這不是模型的錯,是檢索層根本沒有「查無資料」這個概念。向量檢索天生回傳的是排序,不是判斷;除非你自己劃一條線,否則它永遠會給你「最像的那個」,哪怕一點都不像。
Day 24 我們其實已經量出了這條線該畫在哪,但一直沒套用:
該命中:0.584 ~ 0.679
不該命中:0.779 起跳
建議門檻:0.72
今天的目標:
acg_meme 類常識,並解掉它與「角色隔離」機制的正面衝突。query_character_lore() 學會回傳空清單。test_day26.py 驗證隔離、共用與門檻。順序有講究:先擴充語料,再套門檻,最後量測。語料多了距離分佈會變,先套門檻等於用舊數據做決定。
現在每個角色 3–4 筆,量測基數太小,任何門檻都是過擬合。先把 seed_lore.py 補到有意義的規模。
莉莉(原創設定):原有 3 筆偏「個人特質」,缺的是世界觀,和姊姊共同經營的關係、老店背景、店裡夥計的由來、帳務設定。
時刻(原創設定):原有 4 筆已涵蓋能力與背景,補的是關係網,守夜者是誰、時裂、時序管理局。
每筆維持既有的寫法原則:一句話一件事、主詞明確、單獨拿出來看也讀得懂。這跟 Day 23 對「事實」的要求完全一致,理由也一樣,RAG 檢索出來的內容是單獨注入的,沒有上下文可以依靠。
擴充後:莉莉 9 筆、時刻 9 筆。不用更多,這是 demo 不是百科。
這是今天真正的設計題。
現在的隔離是硬的,query_character_lore() 寫死了精準比對:
where={"char_id": char_id} # 關鍵:只在這個角色的設定裡搜尋
這是 Day 22 刻意做的,不是疏漏,沒有它,時刻會撈到「莉莉非常擅長製作甜點」然後當成自己的設定講出來。
但「傲嬌是什麼意思」「本命是什麼」這類 ACG 共通常識,兩個角色都該知道。而精準比對的 char_id 天生塞不進「不屬於任何人」的資料。三種解法:
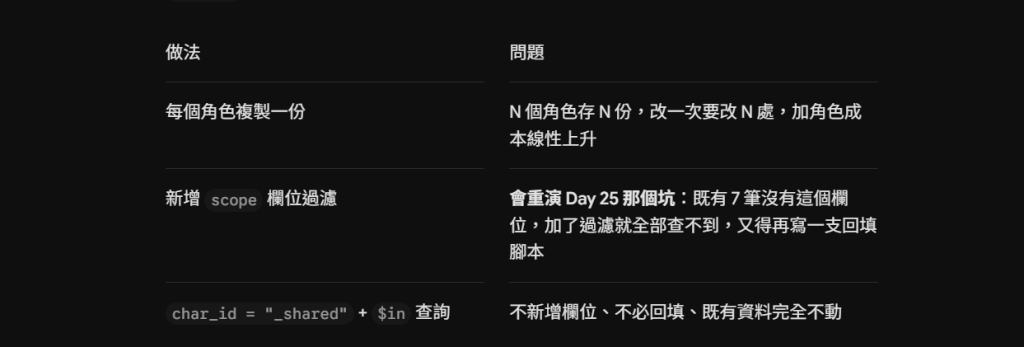
選第三個。Day 25 才花了一整篇的篇幅學到「加欄位要付回填的代價」,能用既有欄位表達的事,就不要開新欄位。
SHARED_CHAR_ID = "_shared"

results = lore_collection.query(
    query_embeddings=_query_ef([query_text]),
    n_results=n_results,
    # 只搜尋這個角色的設定 + 共用語料。
    # 用 $in 而不是精準比對,但仍然撈不到「其他角色」的設定
    where={"char_id": {"$in": [char_id, SHARED_CHAR_ID]}},
    include=["documents", "metadatas", "distances"],
)
add_character_lore() 原本就有的 id 前綴機制(f"{char_id}:{lore_id}")剛好免費支援,共用語料的 id 會是 _shared:meme_1,不會跟任何角色的撞到。
但這帶來一個新風險:共用語料被檢索到之後,角色可能把它當成「自己的設定」講出來。所以 query_character_lore() 的回傳值也得跟著改,從 list[str] 變成 list[dict]:
return [
    {
        "text": doc,
        "char_id": (meta or {}).get("char_id", ""),   # ← 關鍵
        "category": (meta or {}).get("category", "general"),
        "distance": dist,
    }
    ...
]
帶 char_id 回去,呼叫端才分得出「這是你的設定」還是「這是共通常識」。 然後在 rag_builder 分區標示:
own = [l["text"] for l in lores if l["char_id"] != rag_memory.SHARED_CHAR_ID]
shared = [l["text"] for l in lores if l["char_id"] == rag_memory.SHARED_CHAR_ID]

if own:
    context_parts.append(f"【檢索到的角色設定 (Lore)】:\n{...}")

if shared:
    context_parts.append(f"【ACG 共通常識(背景知識,不是你的個人設定)】:\n{...}")
混在同一個標題底下的話,「傲嬌指的是嘴上強硬其實關心對方」會被莉莉當成自己的人設唸出來,那是常識,不是她的設定。
LORE_DISTANCE_MAX = 0.72   # Day 24 量測值,稍後會被推翻

def query_character_lore(query_text, char_id, n_results=2,
                         max_distance=LORE_DISTANCE_MAX) -> list[dict]:
    ...
    return [
        {...}
        for doc, meta, dist in zip(...)
        # 超過門檻的一律丟掉。寧可這輪沒有 lore,
        # 也不要塞一筆不相干的設定讓角色硬扯
        if dist <= max_distance
    ]
這裡有個值得停下來想的地方:這個門檻的取捨方向,跟 Day 25 的去重門檻剛好相反。
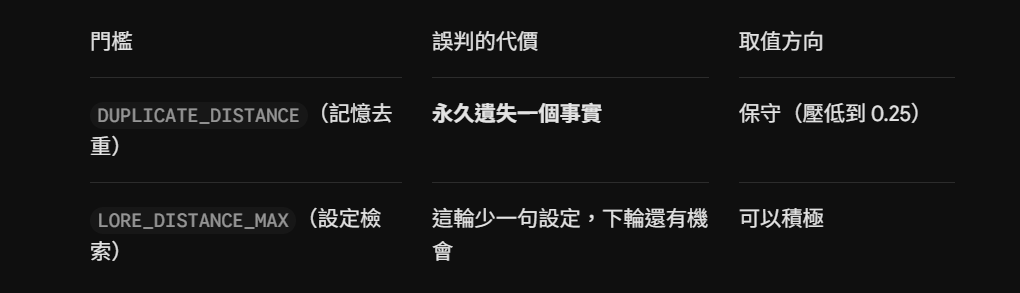
同一個系統裡兩個門檻的哲學不同,因為錯誤的代價不對稱。這不是不一致,這才是正確的設計。
寫 measure_lore_threshold.py,跑 16 個案例、刻意不套門檻(max_distance=99),看原始距離。案例分四類:
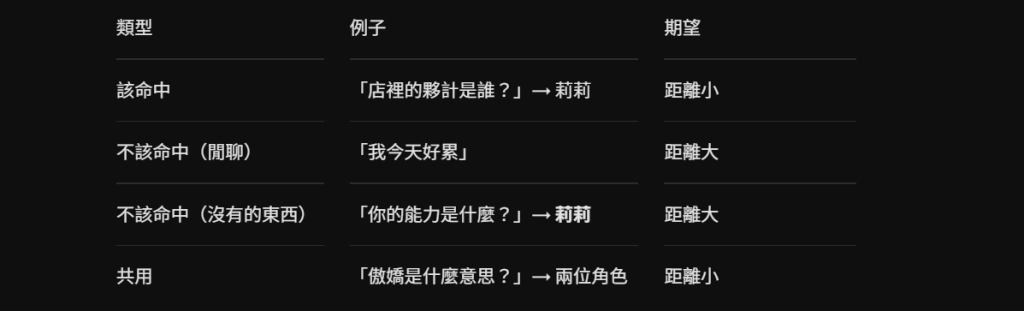
第三類最容易被忽略。時刻有時淵之盤所以該命中,但莉莉沒有超能力設定,如果她也回傳了東西,代表門檻太鬆,她會拿「重視家人的羈絆」去硬答一個關於能力的問題。
第一次量測的結果,直接打臉:
HIT    shike  0.748  你的能力是什麼? → 守夜者是唯一能與時之異客締約的人……
MISS   lily    0.720  你的能力是什麼? → 莉莉非常擅長製作各種甜點與手工烘焙……
------------------------------------------------------------------
該命中     0.516 ~ 0.748
不該命中   0.720 ~ 0.899
→ 兩區間重疊,沒有完美門檻
兩個問題同時爆出來:
第二點才是真正的病灶。把那題的前四名印出來看:
>>> 你的能力是什麼?  [shike]
   0.748  守夜者是唯一能與時之異客締約的人,時刻對他抱持著特殊的興趣。
   0.771  時刻說話時自稱「我」,語氣優雅從容……
   0.771  時刻的時之器物是「時淵之盤」,盤上有延、溯、存三種權能……   ← 正解在第三名
   0.774  聲優是為動畫角色配音的演員……
正解排第三,比不相干的守夜者設定還遠 0.023。
這題調門檻永遠救不了,不管你把線畫在哪,守夜者那筆都排在時淵之盤前面。問題出在語料的措辭:「器物」「權能」「借與還」裡面,沒有任何一個詞跟使用者說的「能力」對得上;而守夜者那筆寫了「與時之異客締約的力量」,反而更近。
今天既然是「語料庫加強」,那就改語料:
# 措辭刻意帶上「能力」二字:量測時發現使用者問「你的能力是什麼?」,
# 這筆的距離是 0.771,反而比不相干的守夜者設定 (0.748) 還遠。
# 門檻調再細也救不了,語料裡沒出現使用者會用的詞,向量就是靠不過去
("lore_1", "時刻的能力來自時之器物「時淵之盤」,共有延、溯、存三種權能,"
           "能向未來預借時間、觀看過去的殘影、把某個瞬間封存起來。", "power"),
改一句話,重灌,再量一次:
該命中     0.516 ~ 0.697
共用該命中 0.362 ~ 0.412
不該命中   0.720 ~ 0.899

該命中的最遠:0.697
不該命中的最近:0.720
→ 兩區間沒有重疊,門檻可取中間值:0.708
0.771 → 0.697。 區間分開了,正解也回到第一名。
那門檻就取中間值 0.708 嗎?不。取 0.70。
因為「不該命中的最近」那筆是 0.720,莉莉被問「你的能力」時撈到的甜點設定。Day 24 建議的舊門檻 0.72 會放行它(0.720 <= 0.72)。門檻要壓在假命中之下,不是壓在中點;中點只是好看,擋不擋得住才是重點。
LORE_DISTANCE_MAX = 0.70
Day 24 建議的 0.72,在 Day 26 的語料規模下正式作廢。量測結論是有保鮮期的,資料變了就得重量。
test_day26.py這支測的是 lore,不動 user_memory,所以不需要像 Day 24/25 那樣建測試用 user_id 再清除。
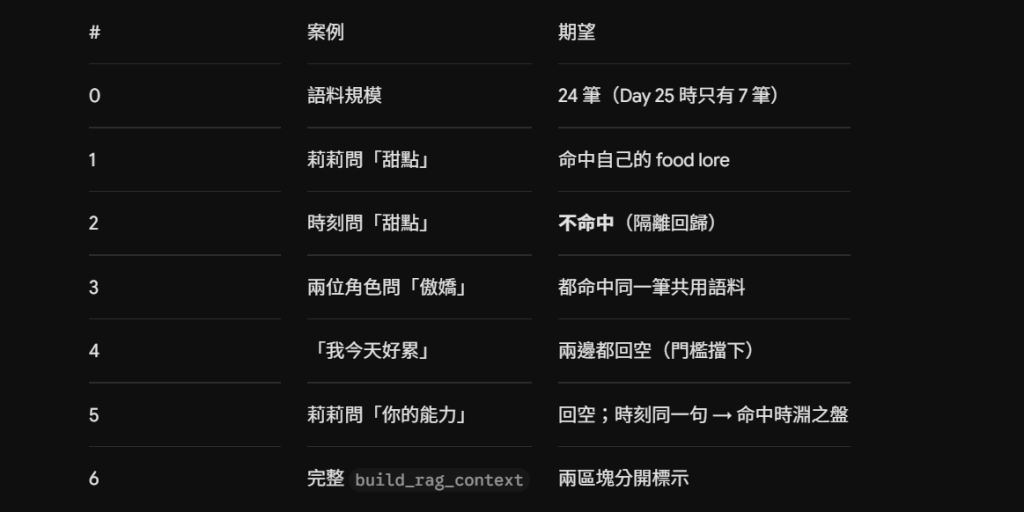
案例 2 是今天最重要的回歸測試。 為了支援共用語料,我們把 where 從精準比對改成了 $in,這正是最容易把角色隔離改壞的一刀。改完必須驗回來。
【2】時刻問「甜點」→ 不該命中莉莉的設定
  [shike] (無,全部超過門檻 0.7)
  撈到莉莉設定的筆數:0 ← 必須是 0

【3】兩位角色問「傲嬌」→ 都命中同一筆共用語料
  [lily  ] (共用/0.412) 傲嬌指的是嘴上態度強硬冷淡、其實內心關心對方的性格……
  [shike] (共用/0.412) 傲嬌指的是嘴上態度強硬冷淡、其實內心關心對方的性格……
  兩邊撈到同一筆:True ← 語料只存一份,不是複製兩份

【4】「我今天好累」→ 兩位角色都不該有 lore
  [lily  ] (無,全部超過門檻 0.7)
  [shike] (無,全部超過門檻 0.7)

【5】莉莉問「你的能力」→ 空;時刻問同一句 → 命中時淵之盤
  [lily  ] (無,全部超過門檻 0.7)
  [shike] (自己/0.697) 時刻的能力來自時之器物「時淵之盤」,共有延、溯、存三種權能……
案例 5 這組並排看最有意思:同一句話「你的能力是什麼?」,時刻命中 0.697,莉莉回空。 這才是我們要的行為,不是「每個角色都有話說」,而是「有設定的人才開口」。
分區標示也如預期。問莉莉「你的本命偶像是誰?」:
【檢索到的角色設定 (Lore)】:
- 莉莉喜歡帥哥類型的偶像,對於少女漫畫風格的情節容易害羞。

【ACG 共通常識(背景知識,不是你的個人設定)】:
- 本命指的是一個人最喜歡、無可取代的那位角色。
一筆是她的人設,一筆是她該懂但不屬於她的常識,兩者在 Prompt 裡清清楚楚分開。
Day 26 表面上是「加資料」,做起來卻是整季少數幾天讓我改變既有結論的一天。
最大的收穫是那個 0.771:我原本以為檢索品質是門檻的問題,量完才發現是語料措辭的問題。 使用者說「能力」,語料寫「器物、權能、借與還」,這中間的落差不是任何一個閾值能彌補的。門檻能做的只有「把明顯不相干的擋掉」,它救不了「相干的東西寫得讓人找不到」。
所以 RAG 的品質其實是兩層:
大家調 RAG 時通常只動第二層,換 embedding 模型、調 top-k、加 rerank。但第一層才是上游,上游髒了,下游怎麼濾都是髒的。今天改一句話帶來的改善(0.771 → 0.697),比我調任何參數都有效。
第二個收穫是關於門檻本身:Day 24 量的 0.72,在 Day 26 就過期了。 不是當時量錯,是語料從 7 筆變 24 筆,分佈整個變了。量測結論有保鮮期,把它寫死在腦子裡當常識用,遲早會出事,所以我把量測腳本留在專案裡(measure_lore_threshold.py),下次語料再擴充時直接重跑就好。


 iThome鐵人賽
 看影片追技術