

前幾天的單機壓測中,目睹了伺服器在極限流量下崩潰的瞬間。不論如何優化Netty的Event Loop,當請求像海嘯般湧入時,記憶體指標依然無情地飆升,最終迎來OOM的悲慘結局。
是不是 Java 太笨重了?如果我今天改用極速著稱的 Node.js,或是寫起來超流暢的 Python 來做非同步 I/O,結果會不會不一樣?
今天我們就暫時放下前面的測試,回頭從語言設計的歷史背景與底層執行緒模型出發,釐清 Java、Node.js 與 Python 底層運行的巨大差異,我們不只要破解非同步萬靈丹的迷思,更要親手用程式碼證明當非同步遇到 CPU 密集型運算與背壓(Backpressure)缺失時,系統是如何瞬間癱瘓的!
程式語言的底層設計,往往深受其誕生時代所要解決的核心問題所影響:
為了不讓觀念混淆,我們借用notebook LM的一張圖來釐清併發 (Concurrency)與平行 (Parallelism)在底層運作上的本質差異:
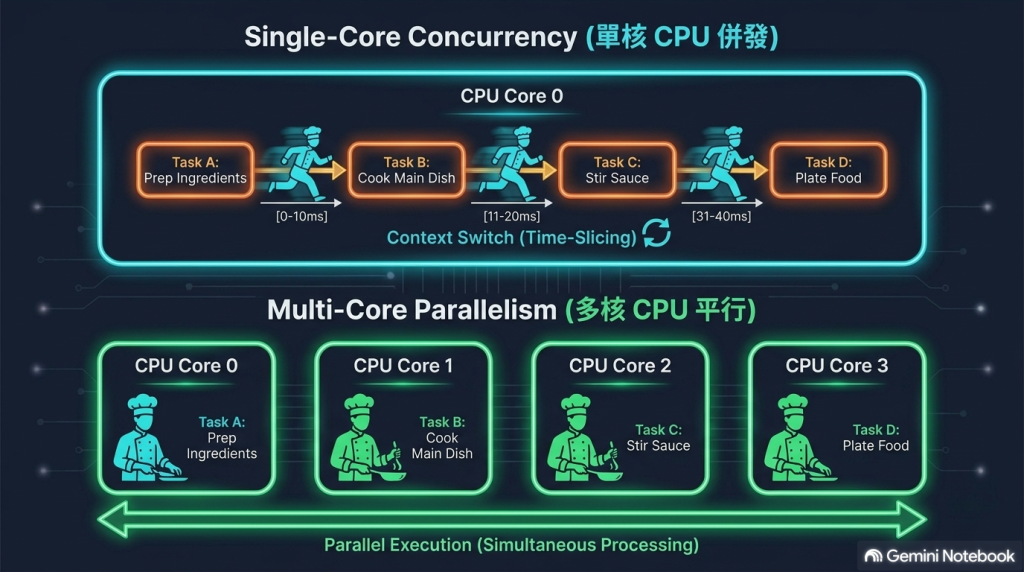
單核併發 (Concurrency):Node.js 的流派,就像一個手速極快的單人廚師。他一下準備食材,然後馬上準備煮魚,再準備醬汁,然後還要裝盤。在客人的微觀視角裡,覺得餐點很快的同時在準備;但事實上,在同一個微秒下,廚師的手只能握著一把刀或一把湯勺,一次只能做一件事,只是他熟成生巧每一件事都處理得非常快而已,切換的過程中就是需要Context Switch做轉換
多核平行 (Parallelism):Java內建,就像廚房裡真的站了四位廚師,各自在獨立的核心上運作,各司其職。備料與煮菜在物理時間軸上是完全同時進行的,平行處理。
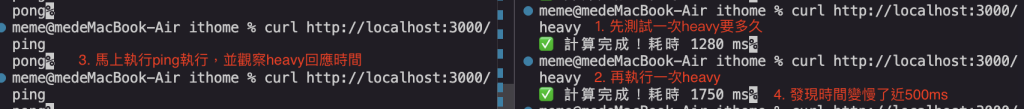
很多人以為只要用了非同步(setTimeout, async/await 等),伺服器就不會卡死了。其實不然,讓我們用最簡單、直觀的程式碼來親眼實證:當單核非同步遇到CPU 密集計算時,系統是如何瞬間癱瘓的。
我們用 Node.js 寫一個極簡的 Express 服務。我們設計兩個 API:
/heavy:模擬一個 CPU 密集計算(例如跑一億次的 for 迴圈)。
/ping:模擬一個超輕量的正常非同步請求(如回傳 "pong")。
方法很簡單,先下載node.js並建立一個新專案資料夾
 # 1. 初始化 package.json (-y 代表全部使用預設設定,不用一直按 Enter)
 npm init -y
 # 2. 安裝 Express 網頁框架
 npm install express
 # 3. 建立 server.js 檔案,將下方程式碼貼上後執行伺服器
 node server.js
// server.js (Node.js)
const express = require('express');
const app = express();
const PORT = 3000;

// 1. 模擬 CPU 密集運算(卡死主執行緒)
app.get('/heavy', (req, res) => {
    console.log("⚠️ 開始執行 CPU 密集運算...");
    let start = Date.now();

    // 跑一億次無意義的計算
    let count = 0;
    for (let i = 0; i < 2000000000; i++) {
        count++;
    }

    let duration = Date.now() - start;
    res.send(`✅ 計算完成!耗時 ${duration} ms`);
});

// 2. 正常的輕量非同步請求
app.get('/ping', (req, res) => {
    res.send("pong");
});

app.listen(PORT, () => {
    console.log(`🚀 Node.js 服務已啟動,監聽 Port ${PORT}`);
});
現在,我們看看 Java 怎麼處理同樣的情況。我們用 Spring Boot 建立一個控制器,懶得開新專案的話可以直接把這一段貼在我們原本專案的主要程式碼中,再直接用mvn spring-boot:run執行專案:
package com.example.s3service;

import org.springframework.boot.SpringApplication;
import org.springframework.boot.autoconfigure.SpringBootApplication;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RestController;
import java.util.concurrent.CompletableFuture;

@SpringBootApplication
@RestController
public class S3ServiceApplication {

    // 1. 模擬 CPU 密集運算(丟到獨立的執行緒池)
    @GetMapping("/heavy")
    public CompletableFuture<String> heavy() {
        return CompletableFuture.supplyAsync(() -> {
            System.out.println("⚠️ [Thread: " + Thread.currentThread().getName() + "] 開始執行 CPU 密集運算...");
            long start = System.currentTimeMillis();

            long count = 0;
            for (long i = 0; i < 2000000000L; i++) {
                count++;
            }

            long duration = System.currentTimeMillis() - start;
            return "✅ 計算完成!耗時 " + duration + " ms";
        });
    }

    // 2. 正常的輕量請求
    @GetMapping("/ping")
    public String ping() {
        System.out.println("ℹ️ [Thread: " + Thread.currentThread().getName() + "] 處理 ping 請求");
        return "pong";
    }

    public static void main(String[] args) {
        SpringApplication.run(S3ServiceApplication.class, args);
    }
}
pong了!然後/heavy才執行結束/heavy 在 CPU 核心 A 上拼命計算時,/ping 會被分配到獨立的執行緒在 CPU 核心 B 上處理,且時間差不多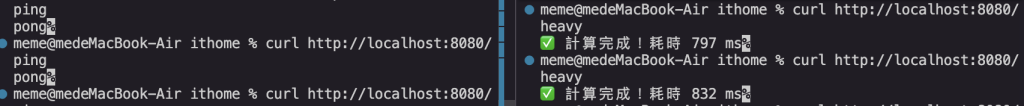
透過兩次的簡單實驗我們可以將時間整理成下表:
| 測試情境 | Node.js (單執行緒 Event Loop) | Java Spring Boot (多執行緒/多核) | 架構診斷與差異 |
|---|---|---|---|
單獨執行 /heavy |
1,280 ms | 792 ms | Java 多核 JIT 編譯與計算速度較快 |
** /heavy 途中打 /ping** |
1,750 ms (飆升 +470ms) | 832 ms (微增 +40ms) | Node.js 主執行緒阻塞,/ping 佇列卡頓;Java 多核心 Thread 隔離,/ping 瞬間完成 |
/ping API 體驗 |
卡住死等(需等 Event Loop 釋放) | 1 ms 瞬間回應(毫無感官延遲) | Node.js 無法隔離 CPU 計算;Java 輕鬆發揮多核平行 |
透過上面的實測數據,我們得出了最關鍵的架構結論:
非同步 (Async) 擅長解決的是等待 (I/O Blocking) 期間的資源浪費,但它無法縮短物理上的計算時間!
更可怕的是,當你把系統改寫成非同步(如 Netty 模型)後,伺服器確實不會因為等待 AWS S3 上傳而卡死了,但這反而會引發另一個維度的災難:請求湧入速度 > 寫入處理速度的記憶體海嘯!
更可怕的是,當你把整個系統改寫成非同步(如 Netty 模型)後,伺服器確實不會因為等待 AWS S3 上傳而卡死了,但這反而會引發另一個維度的災難:
在傳統同步模型中,執行緒池滿了,系統會自然拒絕新連線(產生天然的閥門阻擋流量)。 但在非同步系統中,由於連線不會阻塞,系統會在極短時間內接納所有的 TCP 連線與請求。如果這時 S3 的上傳速度變慢(例如頻寬被占滿),而你前端依然以每秒 5000 個請求的速度狂塞,這些「已經進來、但來不及處理」的巨量檔案與任務資料,就會全部堆積在 JVM 的記憶體中(Queue / Channel Buffer)。
[客戶端高併發請求 5000 req/s] ───> [Netty 非同步引擎 (暢通無阻接單)]
                                      │
                                      ▼
                        [ JVM 堆積記憶體 Queue ] ⚠️ (持續積壓)
                                      │
                                      ▼
                        [ 限速 S3 寫入 1000 req/s ] (木桶效能短板)
當堆積的任務超過了 JVM 堆記憶體(Heap Memory)的極限,系統就會毫無懸念地報出: java.lang.OutOfMemoryError: Java heap space
這就是為什麼現代非同步架構中,背壓(Backpressure) 如此重要的原因。這正是我們在前面章節引入 Semaphore(50) 限流門閥 與 Resilience4j 斷路器 的根本原因!非同步不是能塞多少塞多少,而是當後端寫入(如 S3 或 Database)遇到瓶頸、內部佇列累積到一定水位時,系統必須主動通知前端降低發送速率,或是採取「拋棄策略」、「限流降級」等手段,否則非同步只會讓你的系統死得比同步模型更快、更難看。
今天我們從底層基因拆解了三大語言的非同步真相:
- Node.js 適合 I/O 密集,最怕 CPU 計算:千萬不要在 Node.js 主執行緒裡寫耗時的密碼雜湊、大檔案解壓縮,這會讓你的整個微服務瞬間癱瘓。
- Python 的多執行緒是虛胖,多核得靠多行程:寫 Python 高併發,除非是純 I/O 呼叫,否則遇到 CPU 計算時請果斷選擇 Multiprocessing 或改用 Go/Java。
- Java 是重灌戰車,但要注意履帶切換的成本:Java 雖然多核強大,但在傳統多執行緒下會因為頻繁的 Context Switch 導致效能損耗。這也是為什麼我們需要 Netty,以及明天我們要探討的終極武器——Java 21 虛擬執行緒 (Virtual Threads)!
當然實務上程式語言的選擇有更大一部份來自於團隊的習慣和傳承,說明這些事讓大家了解這些不同的程式語言間,它們的歷史流變以及擅長的方式,如此一來在效能調整或是debug時就可以更清楚了解各種架構的優缺點!
接著我們再來思考一個真實生產環境的驚悚場景:
當 CI/CD 自動化流水線要發佈新版本、或是我們敲下 docker stop 準備重啟容器時,那些背景傳到一半的非同步 S3 封包會發生什麼事?
要如何在微服務重啟與更新時,做到不拒絕新連線、也不掐斷舊任務,實現真正的 0 封包遺失平滑滾動更新(Rolling Update)? 答案將在明天揭曉! 教大家如何為 Spring Boot 與 Embedded Netty 裝上最關鍵的保險絲 !


 iThome鐵人賽
 看影片追技術