iT邦幫忙

2026 iThome 鐵人賽

DAY 22
0
Software Development

學校沒教的後端生存指南:30 天打造非同步 S3 微服務,部署 K8s 實現 HA 架構系列 第 22

[ Day 22 ] 重新部署就爆出 5xx 警報?零停機部署與 0 封包遺失的優雅停機!

  • 分享至 

  • xImage
  •  

前幾天我們完成了微服務容器化(Docker)、Prometheus/Grafana 監控服務建立、破除長 Timeout 迷思、並透過壓力測試驗證了listObject和PutObject的防禦效能。非同步 S3 微服務不但在 1.5 核 CPU 限制下展現了驚人的吞吐量,更能彈性擋下流量海嘯與網路波動。

下一步應該要準備把 Docker 容器交付給 DevOps 團隊,準備部署到雲端進行正式上線與滾動更新(Rolling Update),但新的問題又出現了:

如果在 CI/CD 發佈新版本或是系統進行滾動更新重啟容器時,如果背景剛好有 10 個使用者正在上傳大檔案,容器突然被停掉,這些正在傳輸到一半的 S3 非同步封包會怎樣?

如果沒有經過特殊處理,這些請求會被當場掐斷!客戶端會收到沒有狀態的A Non HTTP reponse code 報錯,S3 上還可能會留下傳到一半的孤兒碎片,使用者體驗極差無比!

所以今天我們要來實作優雅停機(Graceful Shutdown)機制,確保在系統收到關機訊號時,能夠拒絕新客、清空舊客,達成 0 封包遺失的平滑滾動更新!

零停機部署 (Zero-Downtime Deployment) 三大策略

在傳統單體架構時代,每次要更換新版本程式碼,常常需要在半夜兩點公告「系統維護中,停機 2 小時」。但在現代 24/7 不間斷運作的雲端微服務中,零停機部署(Zero-Downtime Deployment)已成為企業 SLA (99.99% 高可用) 的基本門檻。

零停機部署的核心目標是:在不中斷對外服務、使用者完全無感的情況下,將線上運行中的舊版本 (v1) 平滑替換為新版本 (v2)。常見方法有三 :

  1. 藍綠部署 (Blue-Green Deployment):
  • 機制:維持藍(舊 v1)與綠(新 v2)兩套獨立環境,測試無誤後透過 Load Balancer 一鍵原子切換。
  • 優缺點:切換與回滾極快,但需要雙倍伺服器資源成本。
  1. 滾動更新 (Rolling Update):
  • 機制:K8s 預設模式,分批替換 Pod(例如一次刪除 2 個舊 Pod 並拉起 2 個新 Pod)。
  • 優缺點:極度節省資源成本;但新舊版本會在部署過渡期 short-lived 共存。
  1. 金絲雀部署 (Canary Deployment):
  • 機制:先切 5% 流量給金絲雀節點觀察 Error Rate,確定無異常後再全量發佈。
  • 優缺點:爆炸半徑最小,風險控制極致。

藍綠/滾動部署還不夠?優雅停機是最後一塊拼圖!

我們常以為在設定了 Rolling Update,或是使用了藍綠部署,系統就自動零停機了!事實卻不然,思考一下當負載均衡器 (Load Balancer) 切離流量或遇到問題中斷時:

  1. 上游流量已切走:新請求確實不會再打到舊容器。
  2. 但已在車上的請求呢? 那些在切離流量前一毫秒才剛打進來、正在背景執行上傳 S3 的 10 個請求,依然在舊容器的記憶體與 Socket 中處理!

如果舊容器在收到關機通知時,沒有具備優雅停機 (Graceful Shutdown) 能力,作業系統會直接下達 kill -9 (SIGKILL) 強制拔插頭。結果就是這 10 個正在處理中的使用者立刻收到 5xx 警報!

💡 零停機部署黃金公式:零停機部署 = 上游流量切換 (藍綠 / 滾動更新) + 下游應用優雅停機 (Graceful Shutdown)兩者缺一不可,才能達成真正 0 封包遺失的平滑發佈!

Linux 訊號機制與 Graceful Shutdown 的兩階段撤退

要理解優雅停機,我們必須先搞懂 Linux 作業系統是如何向進程(Process)發送關機訊號的。

  1. 暴力 SIGKILL vs. 禮貌 SIGTERM
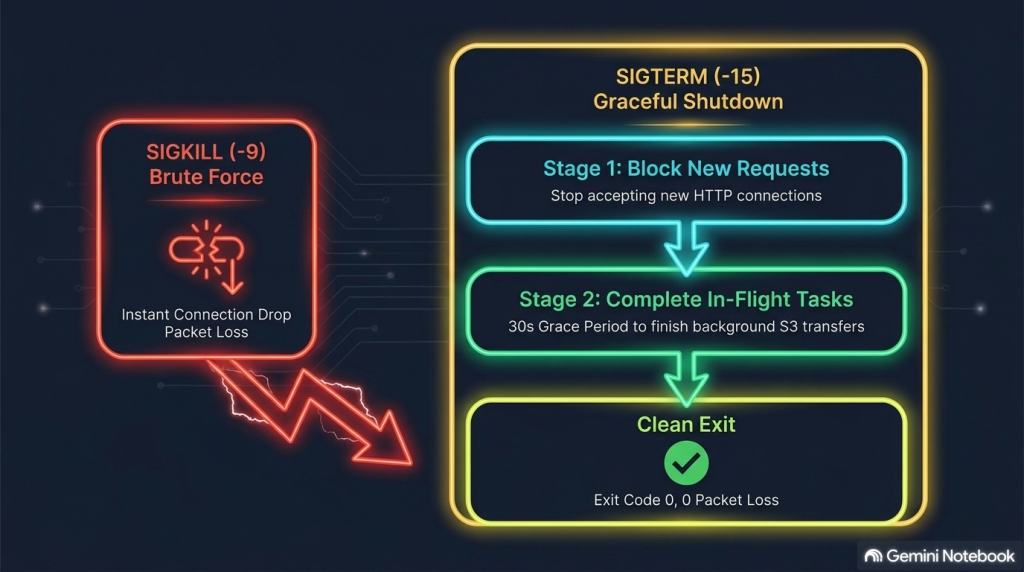
    在 Linux 世界中,關閉一個進程有兩種截然不同的方式,參考下方gemini產生的輔助圖:
  • 左側 SIGKILL (Signal 9 / kill -9) 暴力中斷:

    • 當 Docker 發射 SIGKILL 訊號時,作業系統會不經過應用程式同意,直接強制終止 JVM 進程。
    • 進程無法被捕捉、無法執行任何 Cleanup 邏輯。正在背景進行到一半的非同步 Netty 傳輸與 S3 PutObject 封包會瞬間中斷,造成 Socket 連線遺失、前端用戶當場報錯。
  • 右側 SIGTERM (Signal 15 / kill -15) 禮貌通知:

    • 發送 SIGTERM 訊號時,當執行 docker stop 或 K8s 進行滾動更新(delete pod)時,系統發射禮貌通知,觸發 Spring Boot 與 Netty 的關機 Hook。
    • 階段一 拒絕新客 (Block New Requests):
      • 關閉 HTTP Accept 門閥,停止 Port 8080 監聽,讓 upstream 的負載均衡器(Load Balancer)將流量切走。
      • 後續湧入的新請求直接回傳 503 Service Unavailable 或秒退,不再接納任何新乘客。
    • 階段二:清空舊客 (Complete In-flight Tasks)
      • 開啟 Grace Period 緩衝倒數(預設 30 秒),允許已經在車上的背景 Netty EventLoop、CompletableFuture 與 S3 上傳任務繼續執行。
      • 在冷卻時間(Quiet Period)內等待所有傳輸順利 completion 下車。
    • 優雅退場 Clean Exit (Process Exit Code 0)
      • 所有背景任務清空,安全釋放堆外記憶體(Direct Memory)與 Socket 資源,JVM 以 Exit Code 0 安全關閉,達成 0 掉包的平滑滾動更新!

https://ithelp.ithome.com.tw/upload/images/20260914/20183864E9IrnZntkv.png

優雅停機的 Sequence Diagram

我們用一張時序圖來呈現上述當kill -15禮貌通知,系統內部如何精準執行兩階段退場:
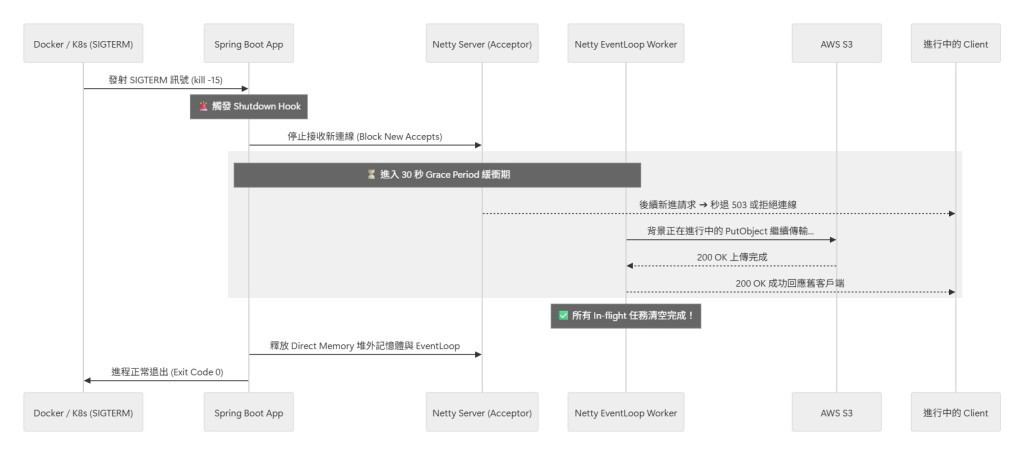
https://ithelp.ithome.com.tw/upload/images/20260914/20183864nZCImFjx6L.jpg

實戰演練:配置 Spring Boot 3 & Netty 優雅停機

Spring Boot 中要開啟這個兩階段優雅停機非常簡單,我們只需要在 application.yml 裡進行宣告:

Step 1: 修改 application.yml

server:
  port: 8080
  #  1. 啟用優雅停機機制 (預設為 immediate 立即暴力關閉)
  shutdown: graceful

spring:
  lifecycle:
    #  2. 設定優雅停機各階段的最大等待緩衝期 (Grace Period)
    # 给予背景 S3 Async Client 與 Netty EventLoop 最多 30 秒完成手頭上的傳輸
    timeout-per-shutdown-phase: 30s

本地測試:暴力 kill -9 vs. 優雅 SIGTERM

現在,我們打開 Terminal,親眼見證有沒有優雅停機在重啟容器時的差異

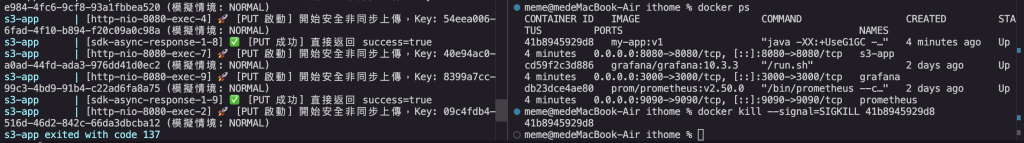
實驗一:暴力 docker kill

  1. 打開Jmeter 20並發數,檔案上傳protected api
  2. 先用docker ps 查看my-app微服務的conatiner id
  3. 在傳輸第 2 秒時,執行暴力關閉 docker kill --signal=SIGKILL <container_id>
  4. 可以觀察到docker console出現s3-app exited with code 137

https://ithelp.ithome.com.tw/upload/images/20260916/20183864nXT1pcsJgs.png

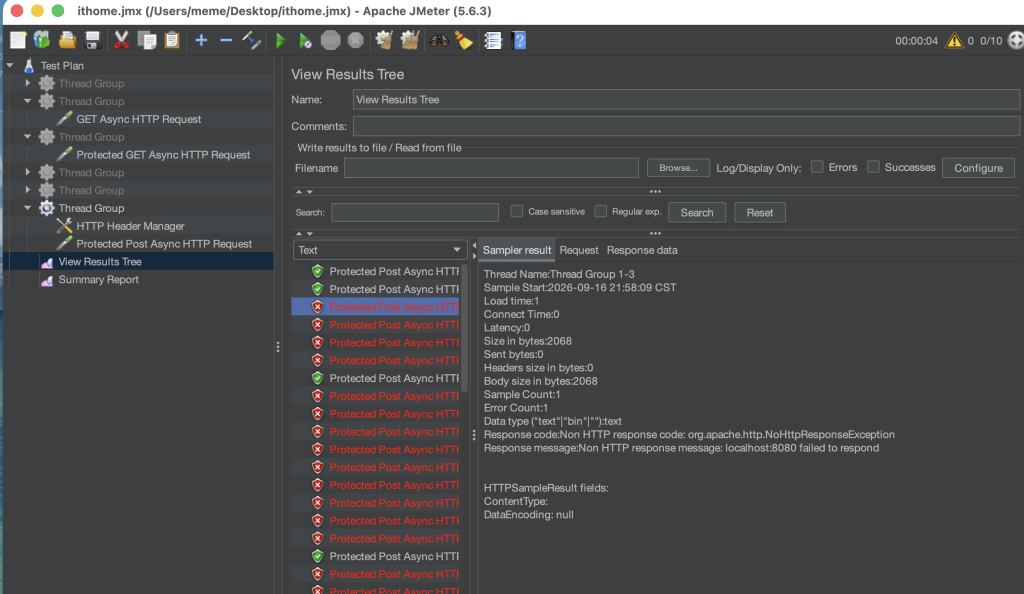
  1. Jmeter客戶端 Console NoHttpResponseException!傳輸當場中斷,S3 上留下無人收拾的碎片,系統日誌完全沒留下任何退場紀錄!
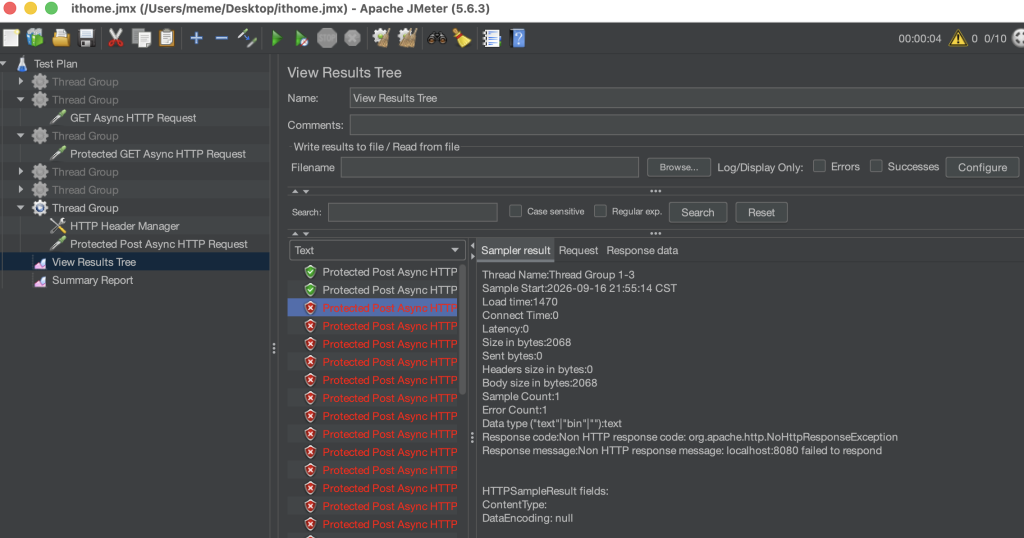
    https://ithelp.ithome.com.tw/upload/images/20260916/20183864XkLkV22goK.png

實驗二:優雅 docker stop

  1. 重新打包並啟動具備 Graceful Shutdown 配置的容器docker compose up -d --build

  2. 再次使用Jmeter併發發射大檔案上傳。用docker ps 查看my-app微服務的conatiner id

  3. 在傳輸第 2 秒時,執行優雅關閉(docker stop 預設會發送 SIGTERM 訊號):docker stop <container_id>

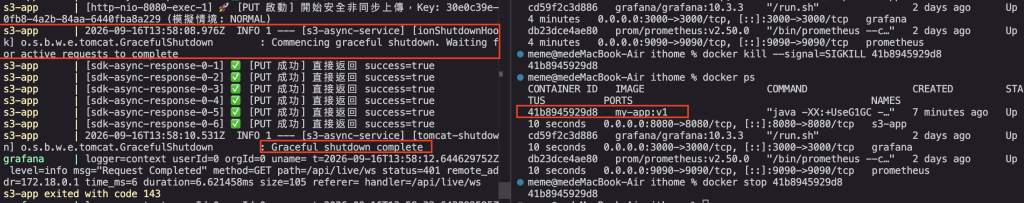
  4. 可以觀察到docker console出現[tomcat-shutdown] o.s.b.w.e.tomcat.GracefulShutdown : Graceful shutdown complete
    https://ithelp.ithome.com.tw/upload/images/20260916/20183864FMTUTHAUIB.png

  5. Jmeter客戶端 Console 可以看到穿插成功和失敗的reponse其中 HTTP/1.1 200 OK
    Upload success: 888e8400-e29b-41d4-a716-446655448888
    當 docker stop 下達時,微服務沒有終止,優雅地擋下了後續的新流量,並給予正在傳輸的連線 2.15 秒時間完成寫入 S3。客戶端順利拿到 200 OK,隨後進程平靜退場,達成 0 封包遺失!
    https://ithelp.ithome.com.tw/upload/images/20260916/20183864yA7fHo4twK.png

  • Commencing graceful shutdown: 收到 SIGTERM 後,Spring Boot 立即啟動關機流程,停止接納新連線。
  • 背景服務全數安全下車: 請仔細觀察 Log!在收到停機通知後,背景已經在處理的 6 個 S3 非同步上傳任務 (sdk-async-response-0-10-6) 依然陸續傳輸成功,並印出 [PUT 成功]
  • Graceful shutdown completeExit Code 143: 花了約 1.55 秒等所有既有任務完成後,系統印出 Graceful shutdown complete 並以 Exit Code 143 平靜退場。
  • JMeter 的真實反映: 在停機瞬間,已經進站的請求穿插著全數成功拿到回應;而在停機宣告後才發射的新請求則被秒拒。這完美證明了優雅停機保住了所有舊客的資料完整性!

延伸技術

額外補充分享一下,在企業級微服務與 K8s 架構中,除了應用程式本身的 Graceful Shutdown,通常還會搭配以下工具

1. K8s Readiness Probe與 PreStop Hook

  • 觀念:在 K8s 準備刪除 Pod 時,透過 PreStop Hook 執行腳本,並先將 Readiness Probe 標記為 Unready(不健康)
  • 作用:這會強制 K8s Ingress / Service 提前 5~10 秒把流量切走,確保連一個新請求都不會再打到這個準備關閉的 Pod 上。

2. 負載均衡器 Connection Draining(如 AWS ALB / Nginx)

  • 觀念:負載均衡器側的「連線排水機制」。
  • 作用:當 ALB 收到某個節點要註銷(Deregister)時,ALB 會開啟一段 Deregistration Delay(如 30 秒),在這 30 秒內不再派發新 Request,但保持舊 TCP 連線持續傳輸

3. Service Mesh(如 Istio / Linkerd)與 Sidecar 代理

  • 觀念:將網路流量交由 Sidecar 代理程式接管。
  • 作用:當 Sidecar 偵測到主要應用容器正在停機並回傳 503 時,Sidecar 可以自動執行 無感重試(Automatic Retry),把該筆請求秒級重定向到其他健康的 Pod,連 503 都不會讓前端看到!

4. 前端/客戶端指數退避重試(Client-side Retry with Exponential Backoff)

  • 觀念:搭配我們在 Day 12 實作的 冪等性 (Idempotency) 設計。
  • 作用:就算少數新請求不幸吃到 503(因為門閥已關),前端 SDK 只要偵測到 503,在背景靜默重試一次,使用者端連頁面都不用重新整理就能自動恢復!

總結

今天的內容我們學到優雅停機是微服務走向 99.99% 高可用與零停機部署的必要入場券。商業價值方面,它讓我們在重啟與更新容器時,而是做到拒絕新客、清空舊客,不僅保住了最後一個非同步封包的完整性,捍衛了企業的商業 SLA 與用戶信任。

當單一容器學會了如何體面退場,我們也已經將單一容器調校到了極致——具備高吞吐、防衝擊、可觀測、與優雅退場能力。

但是,單一容器再怎麼完美,依然是一個單點主機。當實體斷電、當網路卡爆死、或是突發流量遠超單機 1.5 核極限時,我們的微服務依然無法自救。明天開始我們將進入下一個階段,告別單機 Docker,踏入雲端原生的分散式領域,手把手教大家撰寫 K8s YAML、部署本地 Minikube 叢集、設定 HPA 水平自動擴展、以及設定 Liveness & Readiness 雙探針,帶大家體驗什麼是高可用自我修復叢集!


上一篇
[ Day 21 ] 程式語言底層對決Java vs Node.js vs Python:為什麼非同步不是萬靈丹?單核、多核與OOM的挑戰
系列文
學校沒教的後端生存指南:30 天打造非同步 S3 微服務,部署 K8s 實現 HA 架構22
圖片
  熱門推薦
圖片
{{ item.channelVendor }} | {{ item.webinarstarted }} |
{{ formatDate(item.duration) }}
直播中

尚未有邦友留言

立即登入留言