
把人的登入與機器取 Token 分開後,請求離開登入入口,責任卻不會自動跟著走。假設值班工程師請 Agent 查服務的 latency。隔天,同一支 Agent 又被排程喚起,查的是同一個 MCP Tool。兩次請求可能從相同的 runtime、帶著相同的服務憑證出去,但第一筆有人交辦,第二筆沒有。如果紀錄只剩最後送出的 client_id,兩件事就會長得一模一樣。
這也是我在整理 AWS Cognito 的 Human 與 M2M 路徑時,發現單一 actor 欄位不夠用的原因。登入者、取得下游權限的服務、選擇 Tool 的 Agent,以及實際運行它的程序,各自回答不同問題。Pod 名稱能幫忙定位程序,卻無法告訴我們前面是誰交辦的。
以 query_metrics 為例,觀測服務透過 MCP 提供這個查詢工具,Agent 再透過 MCP client 呼叫它。人工交辦的路徑是「值班工程師登入 → 在 MCP console 發出調查需求 → Agent 選擇 Tool → runtime 呼叫下游」。排程路徑則從 scheduler 開始,沒有那位登入的工程師。兩條路從 Agent runtime 往後可能完全相同,差異卻決定了事後該找誰釐清目的、該檢查哪一種授權。
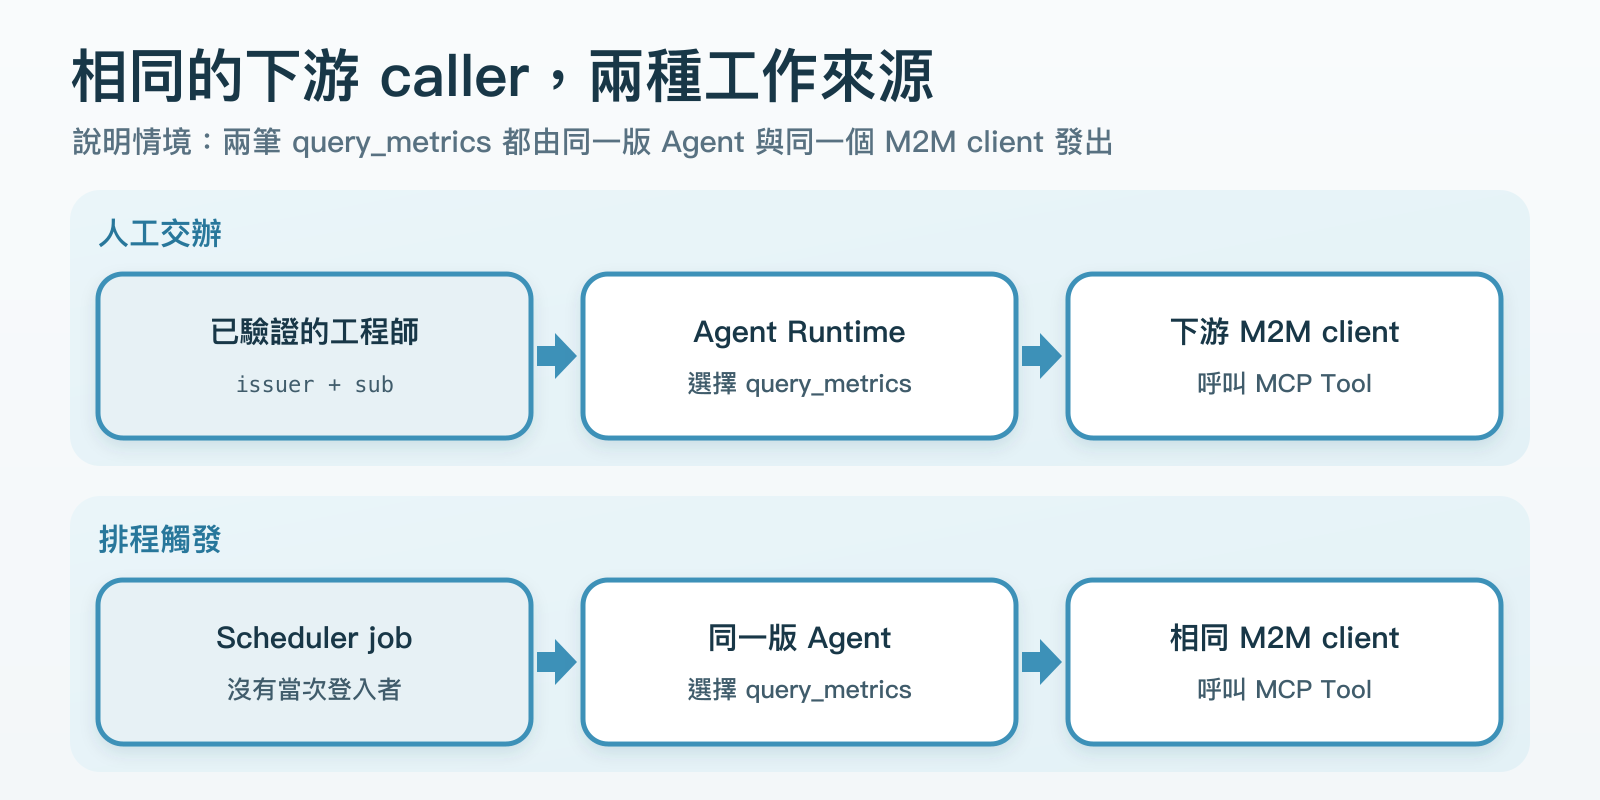
排程任務本來沒有當次的 Human caller,應留下 job 與服務 owner。人工交辦則要留下已驗證的 issuer、sub 和入口。兩條路還都需要知道哪版 Agent 選了 Tool、請求在哪個 runtime 執行。這些資訊不必擠進每一枚 Token,但要能沿著同一筆 Action 找回來。
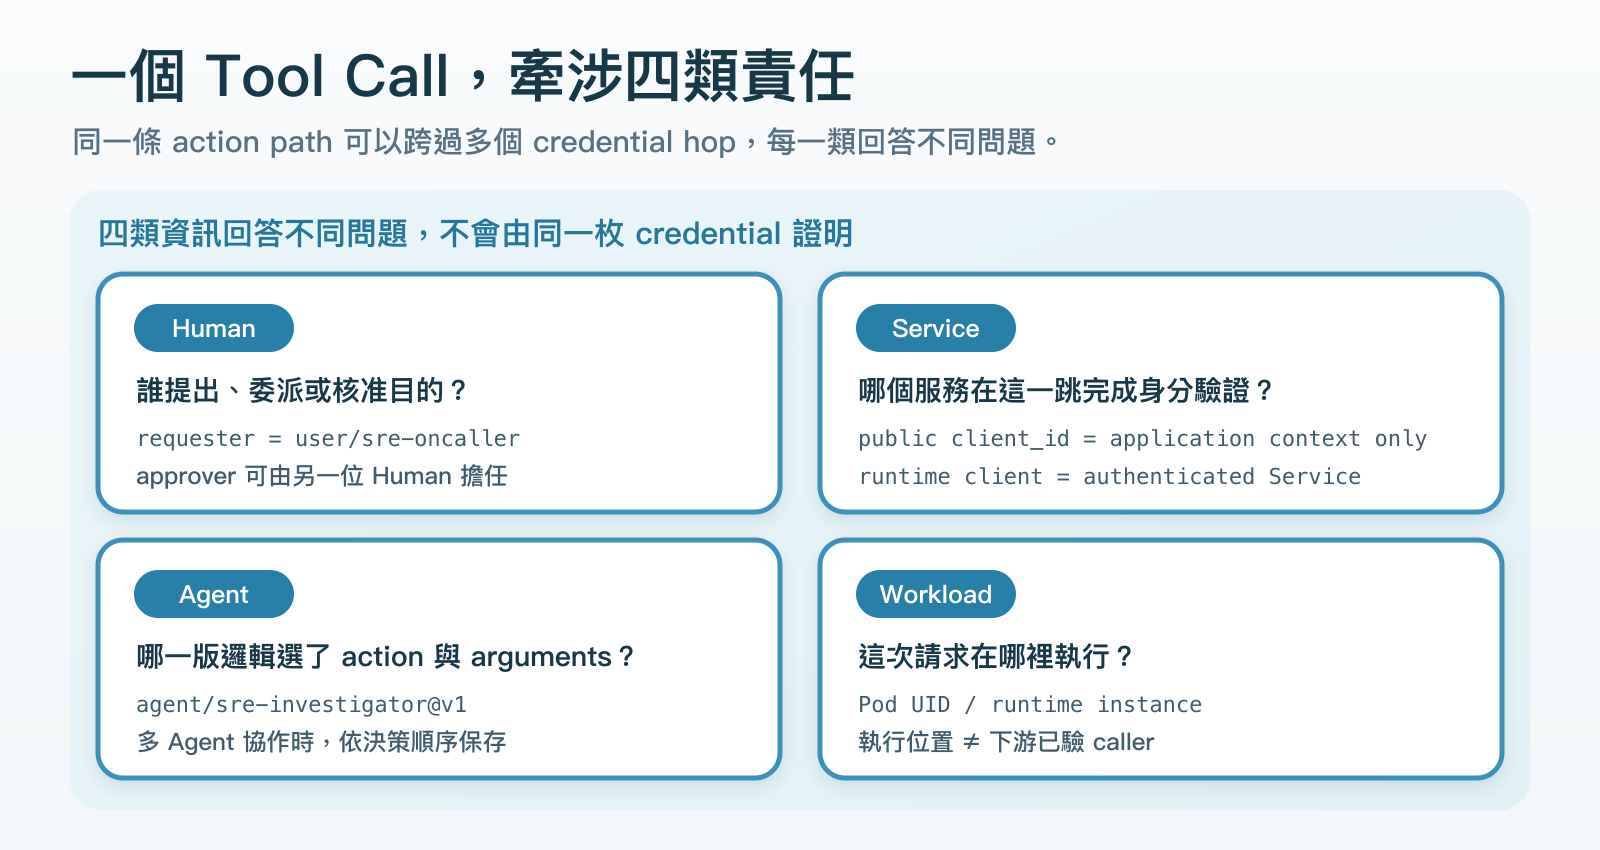
人工交辦時,入口 Token 的 sub 可用來辨認登入者,前提是 Gateway 已驗證 Token。MCP console 的 public client_id 告訴我們是哪個應用程式參與登入,卻不是那個應用已完成 client authentication 的證明。等 Agent runtime 另取憑證呼叫下游,對下游而言,眼前通過驗證的 caller 就是這個服務。原本的工程師仍是工作的來源,不應直接複製成每一跳的 caller。
這個區別會影響調查。若某次 query_metrics 查了不該查的資源,光看工程師的 sub,無法知道是哪版 Agent 做了 Tool 選擇。光看 M2M client,又不知道這次是人交辦還是排程觸發。當下游只認服務憑證時,平台至少要在自己掌握的紀錄裡保留請求來源與 Agent 版本,後面才有辦法把這段路接回來。Day 9 會處理它如何跨元件保存,這篇先把「誰是當前 caller」與「工作從哪裡來」分清楚。
至於 Kubernetes,它主要幫我們定位執行環境。值班工程師通常從 Pod 名稱就能找到部署和 Log。Pod 回答的是請求在哪裡執行,不能反推交辦者。Kubernetes audit 記錄 Kubernetes API 操作,不會因為 Pod 呼叫外部 MCP 服務,就自動產生那筆 query_metrics 的 audit event。這段呼叫仍要靠 Agent、Gateway 或 MCP 服務自己的紀錄關聯。
假設觀測服務發現 Agent 查了一個不在任務範圍內的資料來源。若兩次執行都用了同一個 M2M client,光憑下游的 client ID 無法判斷是工程師交辦的調查,還是凌晨的排程。值班時我會先把下游請求對回 Agent 的執行紀錄:這次由哪個入口觸發、是哪版 Agent、選了哪個 Tool、帶了什麼目標參數。若入口是人工交辦,再對回已驗證的登入者。若入口是排程,就查該 job 的設定與 owner,而不是猜一位當時根本沒登入的同事。
這條追查路徑也能把問題送回正確的修補處。Agent 選錯 Tool 或參數,要看 Agent 版本與它讀到的上下文。API 本來不該讓這個服務查該資源,要改下游 policy。若連請求從哪個入口來都對不起來,先補跨元件的關聯紀錄。三種問題最後都可能顯示為一次成功的 query_metrics,只盯著 200 OK、Pod 名稱或登入者帳號,看不出該修哪一層。
我會把這四類資訊當成閱讀一筆 Agent action 的線索。Human 告訴我們誰提出或批准目的,Service 是當前哪個已驗證的服務取得權限,Agent 指向哪版程式與設定選了動作,Workload 則說明它在哪裡運行。它們可能分散在不同地方,也不一定每次都有 Human。單看 Token、Pod 或模型名稱,都無法補出其餘三段。
實際設計時,可以拿 Identity Flow Matrix 畫自己的人工交辦與排程兩條路,再問「換憑證的那一跳,是否還能知道這筆工作從哪裡來?」不同的授權點未必需要全部資訊:M2M rate limit 可能只看服務,高風險 Tool 則可能需要交辦者、Agent 和目標資源一起判斷。先把來由記對,比急著發明一個涵蓋所有情況的 actor 更有用。
不過,紀錄裡看得到 sub 或 client_id,不表示它們已經可信。下一篇會回到入口那枚 JWT,從實際 payload 開始看:Gateway 要先確認什麼,才能把這些欄位交給 policy 使用?



 iThome鐵人賽
 看影片追技術