
感謝點進來看這個系列文章,我是轉職軟體工程師一年半的菜雞 Min。
撰寫這個系列,是為了記錄近期在公司完成的測試及生產環境「雲-地混合」災害復原專案。過程都是靠自己研究,完成從 MariaDB 到 MySQL 的遷移、架設 Azure MySQL、VPN Gateway、網路設定,到 binlog 資料同步、監控建置等。
這些在網上其實很難找到相關實作文章,都是每天勤勉不懈地與 AI 協作對話,才靠一人獨自完成專案。想以此挑戰回顧當初的建置過程,也希望能與相關經驗的人交流,畢竟我也不確定自己這套是不是正規作法,目前在公司跑起來能用就是了。
這個系列裡提到的東西,都是我真實遇到的,很多還是邊查邊做、跟 AI 一起磨出來的,不敢說是標準答案!不過為了保護公司,一些數據、內網位址、可識別的細節我會隱藏或改寫過,所以如果內容跟你們公司的狀況雷同,純屬巧合,就請別多想 XD
那,就先從最根本的問題說起:為什麼我們一家輔聽耳機公司,非得做這個不可?
遷移前:我們原本長什麼樣子
在動手改之前,先帶你看看我們遷移前長什麼樣子。
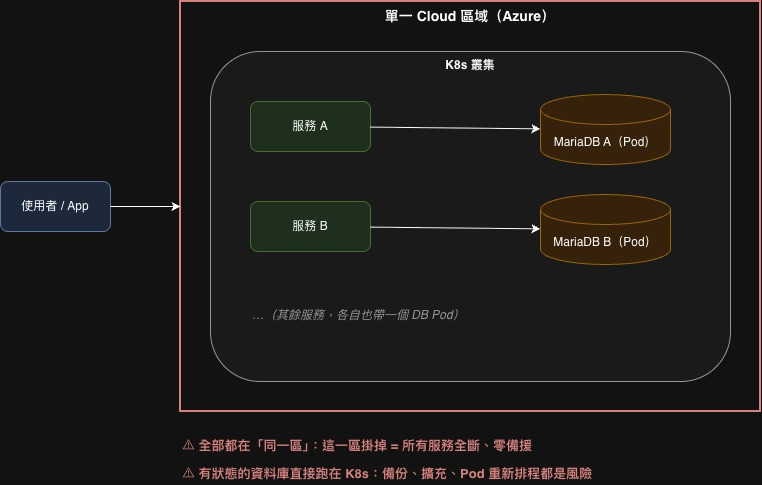
如上圖,我們把所有服務,以及最重要的資料庫,全部放在 Azure 的同一個區域裡。平常跑得好好的,效能也夠,看起來一點問題都沒有。
但只要這一區出事,使用者就會登入不了、註冊不了,整個服務直接全斷,而我們手上連一份備援都沒有。
而且問題不只「單區」這一個
你可能也注意到了,圖裡每個服務的資料庫,是直接跑在 K8s 裡的。但 K8s 為「無狀態」而生,若是突然出現升級、節點擴縮,上面的 Pod 隨時可能被重排。
而資料庫是有狀態的:就算資料靠 PVC 存著不會掉,Pod 一被重排,那段重啟、重新掛載的時間,服務就是中斷的。
更麻煩的是,PVC 常常是 ReadWriteOnce(一個磁碟同時只能掛在一個節點上),這讓資料庫很難像無狀態服務那樣跑多副本、做高可用。所以這次遷移還有一個重點:把資料庫搬出 K8s,改用託管的 Azure MySQL。
於是就有了那句話
作為一家輔聽耳機的 B2C 小公司,這種「一區掛掉就全滅」的狀態其實很脆弱。而真正讓主管在意的是,把命脈全押在單一雲端供應商上,風險比想像中高。
這不是杞人憂天。2025 年 10 月 29 日,Azure Front Door(微軟的全球邊緣流量入口)因為一次設定變更觸發了潛藏的程式錯誤,造成全球性中斷:Microsoft 365、Xbox、Minecraft 全掛,連阿拉斯加航空的系統都受到影響,光第一個小時就湧入超過三萬筆故障回報,前後花了大約八個半小時才恢復。
而在那之前九天,AWS 才剛在 us-east-1 出過一次規模更大的。那次是 DynamoDB 的 DNS 出問題,連鎖影響數十個服務,Snapchat、Signal、Fortnite、一堆銀行 App 全躺,持續了大約十五個小時。
這兩件事都有原廠的官方報告可查:Azure 那次的事故追蹤編號是 YKYN-BWZ ,可以在 Azure 狀態歷史 查到;AWS 的官方事件報告則在 aws.amazon.com/message/101925 。AWS 那份把根因一路追到「DNS 管理系統裡的競態條件」,蠻推薦讀一下。
九天之內,兩大雲各掛一次。這件事給我的感覺不是「Azure 很爛」,而是這種規模的系統出事只是時間問題,沒有一朵雲例外。
所以問題從來不在我們選錯了雲。問題在於,等哪天真的輪到我們,我們手上什麼都沒有。
於是就有了主管那句話:「我們需要一份 Azure 之外的退路。」而接下來這 30 天,就是我怎麼把這單一籃子,變成雲端 + 地端兩個籃子的故事。
這 30 天會走過什麼
我想帶你從頭走一遍這場遷移,從當初的選型與踩坑、怎麼打通雲地網路、資料怎麼搬、複製與定序踩了哪些雷,到停機當天的意外,以及最後的 failover 演練。而以下所列的規劃,有可能會有變動哦:
不過,「多一個籃子」講起來簡單,真要動手才發現,第一個問題是:這個退路到底該長什麼樣子? 這個~我們就明天再說。


 iThome鐵人賽
 看影片追技術