
上一篇講了我們為什麼需要一份「Azure 之外的退路」,也留了一個問題沒回答:這份退路到底該長什麼樣,我又該拿什麼標準去選。
這篇就來拆這兩件事。先講當時擺在桌上的三個選項,再講我們用什麼尺去量它們。而其中一條,老實說,我當時根本沒認真評估過 (咦!可以這麼偷懶的嗎)
最省事的做法:東西還是放 Azure,只是多開一個區域當備援。網路不用重打通、工具不用重學、帳單還是同一張。
但主管第一個就把這條劃掉了,理由很直接:Azure 之前那幾次大當機,不是某一區的機房淹水,是整個服務出事。多開一個區域,碰上那種等級的故障根本躲不掉。
回頭看上一篇提到的那兩次,他是對的。Azure Front Door 那次是全球邊緣入口出問題、AWS 那次是 DynamoDB 的 DNS 出問題,兩個都是全域性的。換一個區域,擋不住這種等級的問題。所以他要的才是「Azure 之外」的退路,而不只是「另一個機房」。
另一個方向是跨雲,東西同時放 AWS 或 GCP,一家掛了還有另一家。
這條老闆一句「太貴」就否決了。我也沒去查證,沒算過成本、沒畫過架構圖,因為我自己也覺得麻煩:兩朵雲的網路要怎麼打通?資料要怎麼同步?
跨雲確實是貴的,多一朵雲就多一套帳單和一堆要學的東西。老闆大概沒說錯,只是沒人真的去算過。
最後選的是這條:雲端當主力,公司自己的機房當備援。我們地端本來就有一套自建的 K8s。基礎已經在那裡了,不用從零開始租機器、找機房、拉網路。相較於「從零長出另一朵雲」,這條路的起跑點就領先一大段。
代價當然也有,而且全都得自己扛:雲和地之間的網路要自己打通、備援的資料庫要自己顧、資料怎麼即時同步過去也得自己解。後面那二十幾天,講的基本上就是這三件事。
三條路擺在眼前,我卻答不出「哪一條夠好」。因為我手上根本沒有一把尺。
在講專有名詞之前,先用白話說。做災害復原,其實只需要回答兩個問題:
就這兩個。後面所有的設計、選型、花費,全部是從這兩個答案推出來的。
想像你在玩一款沒有自動存檔的遊戲,玩到一半電腦當機。你上一次存檔是 30 分鐘前,所以這 30 分鐘的進度沒了。你重開機、載入存檔、回到剛才的地方,花了 5 分鐘。
那 30 分鐘,就是 RPO。那 5 分鐘,就是 RTO。
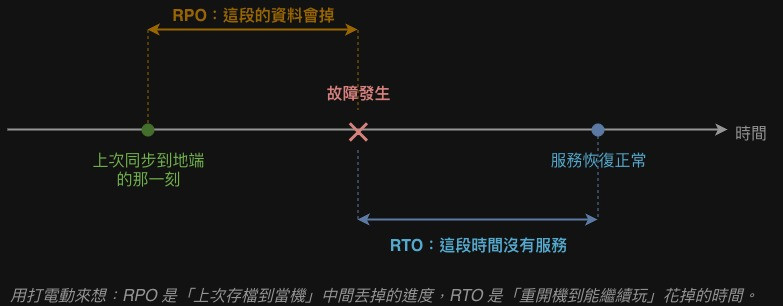
我很喜歡這個比喻,因為它一次點出兩件事:「掉多少」和「多久回來」是兩個分開的問題,而且改善方法完全不同:想少掉進度,要更常存檔;想快點回來,要開機更快。這是兩筆不同的投資。
順帶一提,這兩個詞的最後一個字都是 Objective(目標)。它們是「你希望達到的」,不是「你實際做得到的」。這個差別聽起來像在挑意思,但後來發現還真的是這樣。
因為它們直接決定架構,而架構直接決定錢。RPO 想多短,決定你用什麼方式保存資料:
| 想要的 RPO | 作法 | 成本感 |
|---|---|---|
| 一天 | 每天備份一次 | 幾乎免費 |
| 幾分鐘 | 定期快照 + 交易紀錄備份 | 中等 |
| 幾秒 | 即時複製到另一個站點 | 要一條專線 + 一台備援機 |
RTO 想多短,決定你的備援站點要「多熱」:
| 想要的 RTO | 作法 | 成本感 |
|---|---|---|
| 一天 | 出事再從備份慢慢還原 | 幾乎免費 |
| 幾小時 | 有備份 + 寫好還原步驟 | 低 |
| 十分鐘內 | 備援站點隨時是熱的,能馬上接手 | 那台機器要一直開著 |
所以說到底:
DR 不是「要不要做」的問題,是「你願意花多少錢,買多短的時間」。
不過上面那套順序我們當時其實沒有照做。照理說應該先把 RTO、RPO 定出來,再照著去選架構。我們是倒過來的:先把整套東西做出來、跑完一次 failover 演練,才量出實際要多久,然後帶著那個數字回去跟主管討論 SLA。
這樣做也不是完全沒好處,至少那個數字是真的跑過一遍量出來的,不是先寫一個好聽的目標再想辦法達成。但如果重來一次,我還是會希望先定個粗略的區間,因為它會影響選型,尤其是要花錢的那些。
RPO 這一半倒是很好決定:
掉幾秒的資料可以接受,最多是使用者最後一個動作要重做一次。掉一天的資料不行,那是使用者的聽力檢測紀錄,重做不回來。
所以 RPO 必須壓到秒級,我們選了即時複製。實務上跑起來,複製延遲長期都是 0。不過它是非同步複製,真出事的時候,最後那幾筆還沒傳到地端的資料還是會掉。
RTO 這一半就複雜多了,因為切換不是一個動作,是一串:發現故障 → 判斷要不要切 → 地端資料庫升成主庫 → 把網域指過去 → 驗證服務。每一步都要時間,而且有些步驟卡在我控制不了的地方。
比如我們的網域託管在 GoDaddy,DNS 的 TTL 最短只能設到 600 秒(介面限制是 600 到 604800,我試著設 60,直接被拒絕)。所以就算我三秒鐘把設定改好,全世界的 DNS 快取還是要等最多十分鐘才會過期。這十分鐘省不掉,RTO 也就不可能比十分鐘更短。
至於最後實際量出來是幾分鐘、機制和 DNS 各佔多少,等演練那幾篇再說。
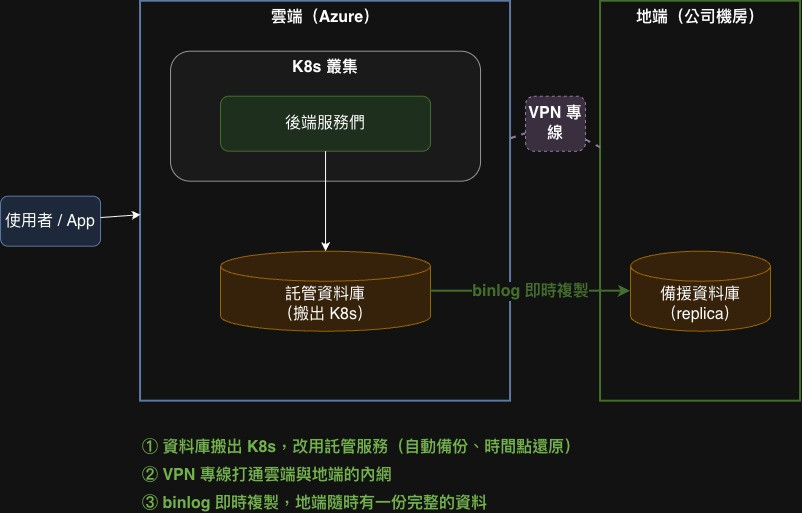
跟上一篇那張現況圖對照,其實只有三個改變:
接下來的內容基本上就是繞著這張圖走:先把中間那條線打通,再把左邊的資料搬過去,然後讓右邊那台跟得上,看右邊接不接得住。
這段我覺得最該講,因為網路上談 DR 的文章很多,講錢的很少。我們這次順便把環境搬了家、架構也升級,月成本從 US$371 變成 US$660,多了 US$289。拆開來看:
| 多花的項目 | 金額/月 | 換到什麼 |
|---|---|---|
| 託管 MySQL | US$80 | 自動備份、時間點還原、不用自己顧 |
| VPN Gateway | US$153 | 雲地之間的複製專線 |
| 節點機型升級 | US$55 | 跟 DR 無關,趁重建順便做的 |
其中 US$233 才是「災害復原」本身的價格,佔了多出來的八成。我們等於是用每個月兩百多美金,買到了「Azure 那一區整個掛掉時,還有一份完整、即時的資料躺在自己公司的機房裡」。
值不值得就看資料掉了會怎樣。使用者的聽力檢測紀錄不見,對我們來說是不能接受的。如果你的服務掉一天資料只是有點麻煩,那可能根本用不到 VPN Gateway,每天備份一次就夠了。這也是為什麼要先定 RPO 和 RTO 再來選架構,順序反過來就會買到用不到的東西。
這一路下來我覺得最重要的一件事是:RTO 和 RPO 說到底是商業決策,不是技術決策。工程師的工作不是自己想一個數字出來,是把每個選項要花多少錢算清楚,讓能拍板的人去決定。
我一開始也是埋頭在想「技術上我能做到多快」,想了很久才發現,該先問的其實是「業務上需要多快」。這兩個問題長得很像,方向卻完全相反。
另外還有一件事。當初讓我覺得跨雲太複雜的,就是網路怎麼打通、資料怎麼同步這兩件事,結果走雲地混合也一樣要面對,一件都沒躲掉,只是對象從兩朵雲變成一朵雲和一間機房而已。
明天開始進入決策篇,而且第一個坑來得非常快:建 Azure 資料庫的時候,有一個叫「連線方式」的選項,分成 Public access 和 Private access。建立當下我隨手選了一個,後來整台砍掉重建。
Day 3 見。


 iThome鐵人賽
 看影片追技術