
上一篇,我們把 npm 專案看成了一張 Dependency Graph。
當一個 package 依賴另一個 package 時,我們可以把關係畫成 A → B 代表:
B依賴A
前面幾篇談 dependency 時,我們關心的通常是:
誰必須先完成?
例如拓樸排序要解的是:
在這些 dependency constraint 之下,事情應該按照什麼順序進行?
但 dependency 還有另一個很重要的用途。
假設:
A原本有值,只是現在改變了
那原本的問題就變成:
A改變之後,哪些東西可能也需要跟著改變?
假設購物車裡有一項商品:
price = 100
quantity = 2
小計可以寫成:
subtotal = price × quantity
所以:
subtotal = 200
接著總金額可能還會考慮折扣:
total = subtotal - discount
如果把這些關係畫成 dependency graph,大概會像: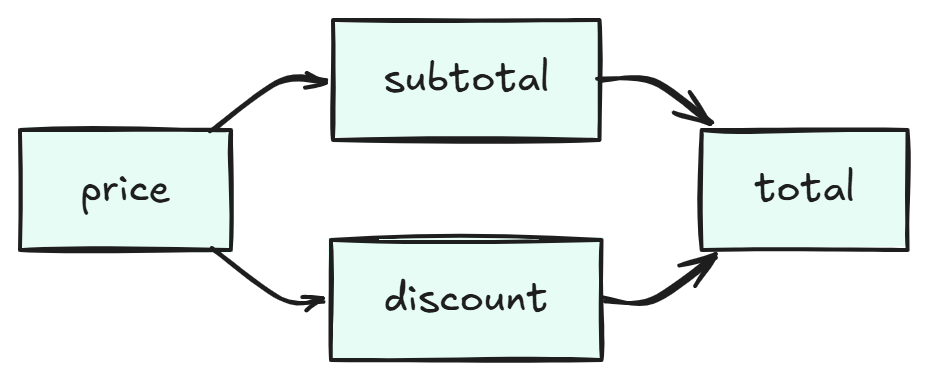
這裡的箭頭仍然代表 A → B,也就是:
B的結果依賴A
所以 subtotal 依賴 price,discount 也可能根據 price 決定。
最後 total 又依賴 subtotal 與 discount。
現在:
price = 120
第一個很明顯的問題是 subtotal 原本:
100 × 2 = 200
現在應該變成:
120 × 2 = 240
所以原本的:
subtotal = 200
已經不能再保留了,但是事情還沒結束,因為 subtotal → total 的關係,total 又依賴 subtotal。
也就是說,一旦 subtotal 的結果可能改變,total 原本的結果也要失效。
而且別忘了另一條關係 price → discount → total。
如果折扣規則也依賴商品價格,那麼 price 改變之後 discount 同樣可能需要重新判斷。
於是一次很簡單的價格改變,可能一路影響:
price
├─→ subtotal
│    └─→ total
│
└─→ discount
     └─→ total
這就是 dependency 帶來的另一個重要問題:
改變會沿著 dependency 往下游傳遞
假設有 A → B → C 以及 A → D → E,可以畫成: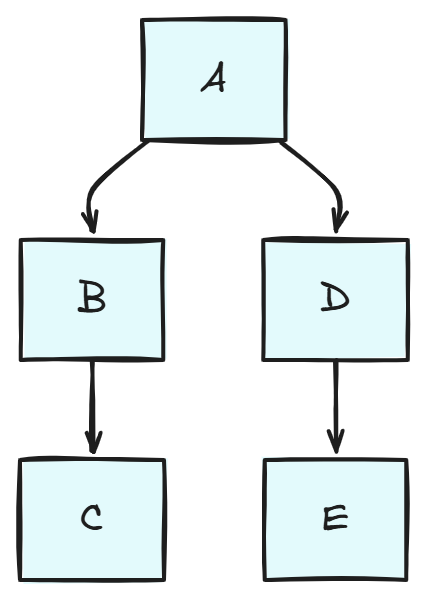
如果我們的箭頭代表 被依賴者 → 依賴者,那麼對 A 來說:
B
C
D
E
都位於它的 下游 downstream,也就是:
它們的結果直接或間接依賴
A
其中 B、D 是 A 的直接 dependency consumer。
而 C、E 雖然沒有直接依賴 A,卻會透過 A → B → C 或 A → D → E 受到影響。
所以當 A 改變時,我們不能只看:
誰直接連著
A?
還要繼續問:
這些節點改變之後,又會影響誰?
這種「改變沿著 dependency graph 傳下去」的過程,可以稱為:
傳遞 propagation
例如:
price changed 先影響 subtotal 和 discount,接著它們又影響 total,形成:
price
  ↓
subtotal
  ↓
total
以及:
price
  ↓
discount
  ↓
total
所以 dependency graph 不只是靜態描述誰依賴誰,它同時也告訴我們:
當某個地方發生改變時,影響可能往哪裡傳
這裡有一個很重要的差別。
假設:
discount = price >= 100 ? 20 : 0
原本:
price = 120
discount = 20
現在把價格改成 price = 130,discount 的確依賴 price。
所以 price 改變之後,我們不能直接假設原本的 discount 一定還有效。
但重新判斷之後 discount = 20 對結果並沒有改變。
因此 dependency propagation 傳遞的,未必是:
你的值一定改了
更準確地說是:
你依賴的東西改了,所以你原本的結果可能已經不能直接相信
這個概念通常可以用一個詞描述:
無效 invalidation
假設 A → B,B 的結果是根據 A 計算出來的。
如果 A 改變 A',那麼原本的 B,可能已經不再正確。
這時我們可以先把 B 視為 invalid,或者更直覺地說 stale,也就是:
這份結果可能過期了
注意,這跟立即重新計算 B 並不是完全相同的事情。
例如某個節點可能根本暫時沒有人需要它。
那麼系統可能只需要先記住 B is invalid,等真正有人需要 B 時,再決定怎麼處理。
這篇先不深入不同策略,現在只需要建立一個概念:
dependency changed
        ↓
dependent may become invalid
問題是 A → B → C,如果 A 改變了,那麼 B 可能 invalid。
但 C 又依賴 B,所以:
A changed
↓
B invalid
↓
C invalid
這個過程其實就是沿著 graph 不斷尋找:
還有哪些下游節點受到影響?
換句話說,我們又遇到了前面幾篇熟悉的概念:
Traversal
前面學 DFS 與 BFS 時,我們通常把 Graph Traversal 想成:
從一個節點出發,尋找其他節點
例如:
捷運站 A
↓
找去 F 的路
或者:
資料夾
↓
搜尋某個檔案
但 traversal 本身其實沒有規定:
一定要找目的地
它真正描述的是:
按照 graph 的 edge,逐步拜訪可以到達的 node
因此今天的問題:
price 改變後,哪些結果可能失效?
其實也可以看成一次 traversal。
我們從 price 開始,沿著 dependency 往下走:
price
├─→ subtotal
│    └─→ total
│
└─→ discount
     └─→ total
一路找到所有可能受到影響的下游節點。
差別只在於:
再看看這張圖:
從 price 出發時,price → subtotal → total 會到達一次 total。
另一條路 price → discount → total 也會到達 total。
所以如果只是很單純地看到 edge 就一直往下走,同一個 node 可能被重複處理。
這跟我們之前談 DFS、BFS 時遇到的問題其實很像。
因此 propagation 同樣可能需要記錄 visited 或者某種 already invalidated 的狀態。
目的是因為:
只要問題是在 Graph 上傳遞,就會重新遇到 Graph Traversal 的基本問題
到這裡,可以重新整理一下我們最近幾篇對 Dependency Graph 的理解。
A → B 代表 B 依賴 A。A → B → C → A 就形成 Cycle。dependency graph 不只是用來回答 誰依賴誰? 或 誰應該先執行? 它也可以回答某個東西改變之後,哪些地方可能受到影響?
這就是:
change
  ↓
dependency propagation
  ↓
invalidation
  ↓
downstream traversal
這也是 Dependency Graph 很有意思的地方。
一張 A → B → C,看起來只是三個節點與兩條 edge,但它其實同時包含兩種資訊。
從 dependency 的角度看:
C depends on B
B depends on A
而從 change propagation 的角度反過來看:
A 改變
↓
可能影響 B
↓
可能再影響 C
也就是說:
dependency 同時決定了資料怎麼被計算,也決定了改變可能往哪裡傳播
所以 Graph 不只是拿來「找路」。
它也可以成為:
傳遞改變的結構
今天的例子都有一個共同前提:
price → subtotal
price → discount
subtotal → total
discount → total
這些 Node 與 Edge 在一開始就已經確定,而且傳遞改變時不會調整。
因此我們只需要:
從改變的 Node 出發
↓
沿著既有 Edge traversal
↓
找出受到影響的 downstream dependency
但現實中的 dependency 不一定永遠固定。
使用者操作可能新增一條關係,也可能讓原本的關係消失。
這時真正要問的是:
如果 Node 與 Edge 本身也會持續改變,我們還能用同樣的方式維護 Dependency Graph 嗎?
下一篇,我們就從這個問題開始。


 iThome鐵人賽
 看影片追技術