
上一篇,我們談到 dependency 不只可以描述:
誰必須先完成?
也可以幫助我們回答:
當某個東西改變時,哪些地方可能需要跟著重新計算?
例如: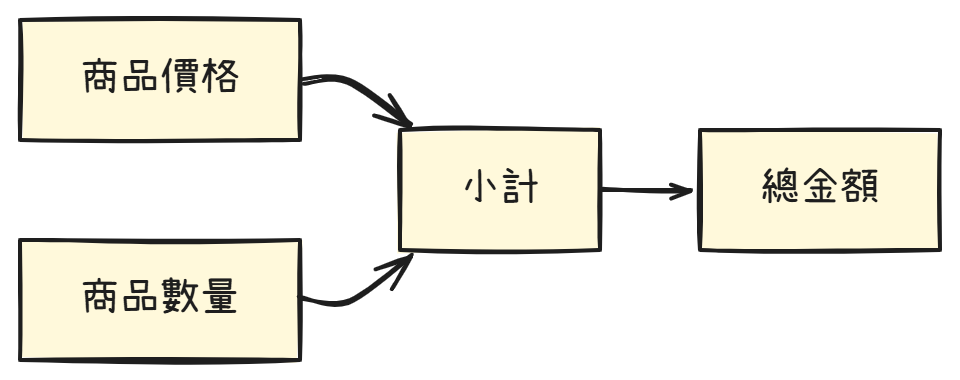
當商品數量改變時,我們可以沿著 dependency 往後找到:
商品數量
→ 小計
→ 總金額
然後只更新真正受到影響的部分。
到這裡,我們一直有一個沒有特別說明的前提:
這張 Graph 本身沒有改變
節點還是那些節點,edge 也還是那些 edge。
改變的只是節點裡面的資料。
但真實世界裡,事情往往沒有這麼單純。
有時候變的不只是資料,而是:
資料之間的關係本身
前面介紹 Graph 時,我們用了捷運路網。
例如: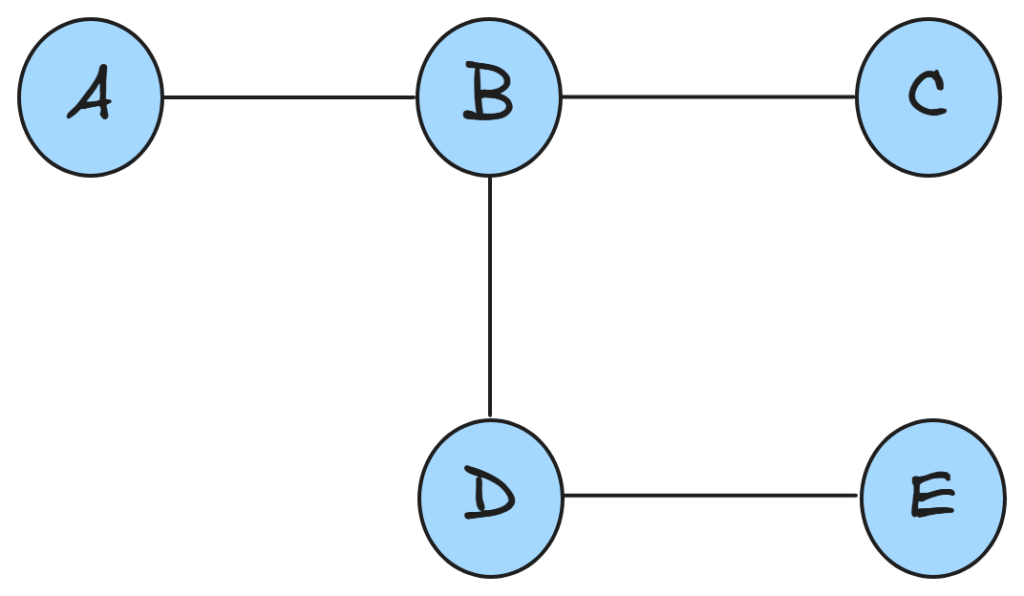
如果我們今天要從 A 找到 E,可以在這張 Graph 上執行 BFS、DFS,甚至在加入行車時間之後使用 Dijkstra。
在我們尋找答案的這段時間裡,通常可以假設:
A 還是連到 B
B 還是連到 C
B 還是連到 D
D 還是連到 E
也就是 Graph 的結構相對穩定。
這類情況可以先粗略理解成:
靜態圖 Static Graph
這裡的 Static 並不是說它永遠不能修改,捷運當然可能新增車站、改線,甚至暫停某一段路線。
真正的差異是:
在我們解這個問題的期間,可以把 Graph 的結構當成固定的
因此我們可以先建立 Graph,再在上面搜尋,事情相對單純。
現在換成一個專案工作流程。
一開始我們可能有:
需求確認
   ↓
API 設計
   ↓
前端開發
但專案進行到一半,可能突然發現:
前端開發之前,還必須先完成 UI Design
於是 Graph 變成:
需求確認
   ├→ API 設計  ─┐
   │             ├→ 前端開發
   └→ UI Design ─┘
這次發生的事情,不是某個 node 的內容改了。
是直接:
新增了一條 dependency
也就是 Graph 的 structure 發生變化。
Graph 的改變不只有新增 edge。
例如原本:
A → B → C
後來我們發現 B 其實不再需要等待 A:
A

B → C
這就是移除 dependency,甚至整個 node 也可能出現或消失。
例如新的工作被加入:
A → B → C
        ↓
        D
或者某個任務被取消、拆分,甚至從目前的 dependency model 中移除。
如果拿 npm dependency 來想,也可能是:
app
├─ package-a
└─ package-b
某次修改之後變成:
app
├─ package-a
├─ package-b
└─ package-c
又或者 package-b 開始依賴 package-c:
package-c
    ↓
package-b
    ↓
   app
這時我們面對的已經不是:
在一張固定的 Graph 上找答案
而是:
一邊使用這張 Graph,它的結構還可能一邊改變
當 Graph 的 node 或 edge 會隨時間變動時,可以把它理解成:
動態圖 Dynamic Graph
例如可能發生:
新增 node
移除 node
新增 edge
移除 edge
也就是:
G₁
↓
某些關係改變
↓
G₂
↓
又有新的關係改變
↓
G₃
我們面對的不再只是單一 Graph:
G
而是一連串不同時間點的 Graph:
G₁ → G₂ → G₃ → ...
這個差異看起來不大,卻會讓很多問題突然變得麻煩。
假設原本有一張 dependency graph:
A → B → C
我們已經知道執行順序可以是 A → B → C,現在突然加入一條新的 dependency:D → B。
Graph 變成: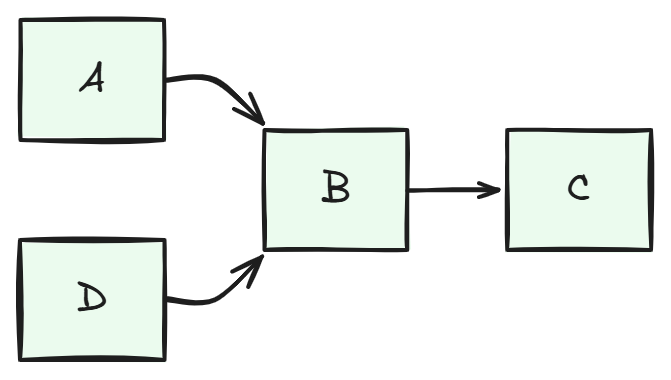
原本 A → B → C 這個結果就不完整了,因為 B 現在不只依賴 A,也依賴 D。
我們必須重新考慮:
A, D
↓
B
↓
C
這件事揭露了一個很重要的問題:
Graph 改變之後,建立在舊 Graph 上的答案,也可能失效
假設某個計算很昂貴,所以我們把結果暫存起來。
例如:
A → B → C
我們已經計算過 C:
C = 100
於是下一次有人詢問 C 時,不需要重新計算:
cache["C"] = 100
這很合理,但現在 Graph 變成:
C 多了一個新的 dependency:D。
這時候問題來了:
100還是正確答案嗎?
不一定。
因為原本算出 100 時,D 根本還不是 C 的 dependency。
所以真正困難的問題往往不是卡在:
Cache 要怎麼存?
是卡在:
什麼時候我們還能相信舊的結果?
當相依關係改變時,原本 cached result 所依據的條件也可能跟著改變。
因此某些結果必須 invalidate 甚至重新計算。
以前我們可能只注意演算法本身的成本。
例如:
但 Dynamic Graph 多出另一種成本:
維護關係的成本
假設我們加入了一個新的 dependency:A → B。
系統可能不只是把這條 edge 塞進資料結構裡就結束。
它還可能需要考慮:
也就是說,一次很小的關係修改 addEdge(A, B),背後可能改變很多我們之前已經算好的資訊。
這也是為什麼:
修改 Graph,不只是修改資料
它可能同時代表我們對問題的描述也變了。
Dynamic Graph 並不只存在於大型系統。
其實 UI 裡也很常見,想像一個試算表:
A1 = 10
A2 = 20
A3 = A1 + A2
dependency 可以畫成:
A1 ─┐
    ├→ A3
A2 ─┘
如果使用者只是把 A1 = 10 改成 A1 = 30,Graph 沒有改變。
只是資料變了:
A1
↓
A3 重新計算
但如果使用者把公式改成:A3 = A1 + B1,那就完全不同了。
Graph 從:
A1 ─┐
    ├→ A3
A2 ─┘
變成:
A1 ─┐
    ├→ A3
B1 ─┘
這次改變的不只是 value,而是:
dependency 本身
這個差異很值得特別分開來看。
Graph 不變:
A → B → C
只是 A 的值變了:
A = 1
↓
A = 2
我們關心的是:
哪些下游節點需要更新?
Graph 本身改了:
A → B → C
變成:
A ─┐
   ├→ B → C
D ─┘
這次要問的問題更多:
因此 Value Change 與 Structure Change,雖然都叫「改變」,但其實是兩個不同層級的問題。
前面介紹 BFS、DFS、Dijkstra、Topological Sort 時,我們的思考方式大致都是:
給我一張 Graph
↓
回答一個問題
例如:
A 能不能到 F?A 到 F 最少幾步?但當 Graph 會變動之後,問題開始變成:
Graph 改變了
↓
哪些既有答案失效?
↓
哪些地方需要重新計算?
↓
哪些地方仍然可以保留?
從 解一次性問題 變成需要考量:
持續維護問題與答案之間的一致性
從 Directed Graph 開始,我們先用方向描述:
接著依序遇到:
Dependency
↓
Cycle
↓
DAG
↓
Topological Sort
開始處理 dependency 是否矛盾,以及工作應該按照什麼順序執行。
後來,我們又把同一張 Graph 用來回答:
上游改變後,哪些下游結果可能失效?
到了今天,問題再多了一層:
Node 與 Edge 本身也可能改變
↓
原本的路徑、順序與 cached result
都可能需要重新檢查
因此 Dynamic Graph 真正帶來的問題是:
當 Graph 不斷改變時,我們要怎麼讓依賴它的結果繼續保持有效?
這些概念會在系列最後,重新回到 Signal 與 Reactive System。
到目前為止,我們主要在問:
但現實問題還有另一種困難。
有時候可行答案不只一個,而我們能使用的時間、空間與資源卻有限。
這時問題就從:
能不能找到答案?
轉向為:
在很多可行答案之中,我們應該選哪一個?
更進一步來說:
當我們沒有辦法嘗試所有可能時,演算法要怎麼做出選擇?
下一篇,我們就從這個問題開始。


 iThome鐵人賽
 看影片追技術