
來到第三天啦!
相信很多人第一次接觸 Kubernetes,看到官方架構圖時,都有類似的反應:
API Server
etcd
Scheduler
Controller Manager
kubelet
kube-proxy
Container Runtime
光看這些名稱就已經頭昏眼花,更別說還要理解它們之間的關係。
試著一個一個了解,結果每個元件好像都看懂了,卻不知道它們實際上如何合作。
其實,我們不需要一開始就死背所有元件。
今天,我們只需要回答一個問題:
當我們告訴 Kubernetes:「我要建立 3 個 Nginx Pod」時,整個 Cluster 到底發生了什麼事情?
只要理解這個過程,就能掌握 Kubernetes Architecture 最重要的運作邏輯。
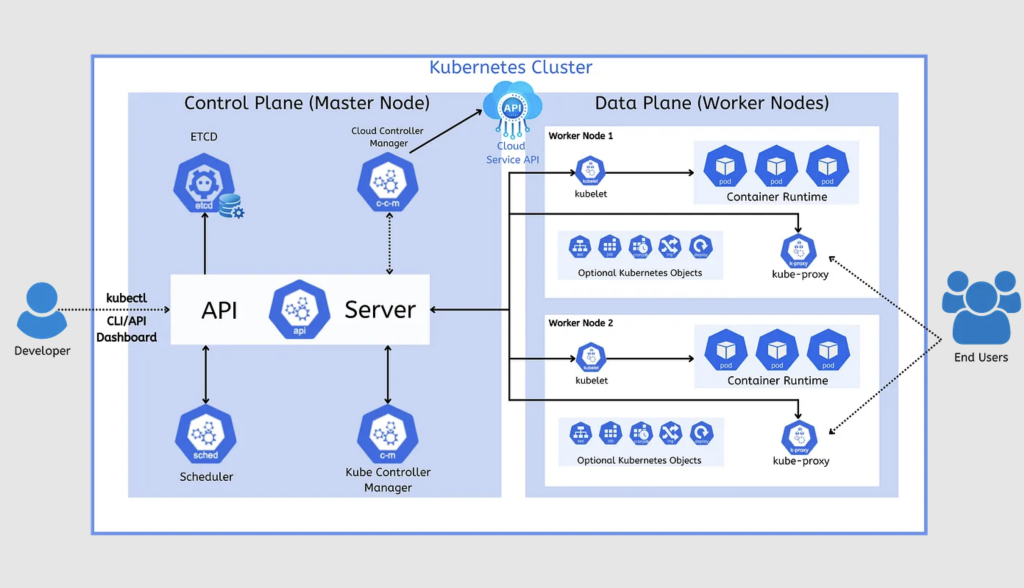
Source: https://aws.plainenglish.io/kubernetes-architecture-c93cb9c798d8
首先,Kubernetes Cluster(叢集)是由多台 Node 所組成的,而這些 Node 可以依照職責區分為 Control Plane 與 Worker Node。
Kubernetes Cluster
│
├── Control Plane
│   ├── API Server
│   ├── etcd
│   ├── Scheduler
│   └── Controller Manager
│
├── Worker Node 1
│   ├── kubelet
│   ├── kube-proxy
│   └── Container Runtime
│
└── Worker Node 2
    ├── kubelet
    ├── kube-proxy
    └── Container Runtime
這裡先理解兩個重要角色。
Control Plane 可以理解成 Kubernetes 的大腦,Worker Node 則是真正負責執行 Application 的工作節點。
Control Plane 負責管理整個 Cluster,例如接收使用者指令、儲存叢集狀態、決定 Pod 要部署在哪台 Node,以及持續維持系統的預期狀態。
Worker Node 則負責實際執行 Pod,並回報執行狀態。
需要注意的是,Control Plane 本身通常也有 kubelet 和 Container Runtime,只是正式環境一般會將 Application 部署到 Worker Node。
接下來,我們就按照建立 Pod 的實際流程,一個一個認識這些元件。
假設我們已經寫好一份 Deployment YAML,希望 Kubernetes 幫我們建立 3 個 Nginx Pod。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: nginx
spec:
  replicas: 3
  selector:
    matchLabels:
      app: nginx
  template:
    metadata:
      labels:
        app: nginx
    spec:
      containers:
        - name: nginx
          image: nginx
接著執行:
kubectl apply -f nginx.yaml
這時候,kubectl 並不會直接跑到 Worker Node 上建立 Container。
它會先透過 Kubernetes API 將請求傳送給 kube-apiserver(API Server)。
kubectl
   │
   │ Kubernetes API
   ▼
API Server
API Server 是整個 Kubernetes Control Plane 的主要入口,負責接收與處理 API 請求,包含驗證、授權及資源資料的讀寫。
不只有 kubectl,Scheduler、Controller Manager、kubelet 及其他外部管理工具,也都是透過 API Server 與 Kubernetes 互動。
因此,我們可以先把它理解成:
API Server 就是 Kubernetes 的正門,負責提供統一的 API,讓各個元件可以交換資訊。
當 API Server 收到我們建立 Deployment 的請求,並完成相關驗證後,就需要把這份設定保存起來。
因為 Kubernetes 必須記得整個 Cluster 的重要資訊,例如目前有哪些 Deployment、Pod、Service,各個 Node 的狀態,以及使用者希望系統達成的 Desired State(預期狀態)。
這些資訊主要儲存在 etcd。
etcd 是一套分散式 Key-Value Store,也就是透過 Key 與 Value 儲存資料的分散式資料庫。
kubectl
   │
   ▼
API Server
   │
   │ 儲存與讀取 Cluster State
   ▼
etcd
以剛才的例子來說,我們希望建立 3 個 Nginx Pod,這項要求會記錄在 Deployment 的設定中,並透過 API Server 保存到 etcd。
要特別注意,etcd 本身不負責建立 Pod,也不會主動調整 Cluster。
它的主要工作是保存 Kubernetes 的重要狀態資料。
其他控制元件則透過 API Server 取得這些資訊,而不是直接操作 etcd。
簡單來說,etcd 就是 Kubernetes 的記憶系統,讓整個 Cluster 知道目前的設定與狀態。
到目前為止,我們只是告訴 Kubernetes 希望建立 3 個 Pod,並把設定保存起來。
但究竟是誰負責真正建立這些 Pod?
這就需要介紹 kube-controller-manager(Controller Manager)。
還記得 Day 1 提到的 Desired State 嗎?
假設目前的情況如下:
Desired State:3 個 Pod

Actual State:0 個 Pod
Kubernetes 發現預期狀態與實際狀態不同,就必須採取行動。
而 Controller Manager 內部運作著多種 Controller(控制器),負責持續觀察 Cluster,並協調資源,讓實際狀態逐漸接近預期狀態。
以 Deployment 為例,過程稍微複雜一點。
當我們建立 Deployment 時,Deployment Controller 會負責建立對應的 ReplicaSet,而 ReplicaSet Controller 再根據 replicas: 3 的設定,建立需要的 Pod。
Deployment
 replicas: 3
     │
     ▼
Deployment Controller
     │
     ▼
ReplicaSet
     │
     ▼
ReplicaSet Controller
     │
     ├── Pod 1
     ├── Pod 2
     └── Pod 3
這裡的 ReplicaSet 可以理解成負責維持指定 Pod 數量的 Kubernetes 資源。
如果其中一個 Pod 意外消失,ReplicaSet Controller 就會發現目前只剩下 2 個 Pod,接著建立新的 Pod,讓數量恢復到 3 個。
這種運作方式稱為 Reconciliation Loop(調諧迴圈),也經常稱為 Control Loop。
Observe
   │
   ▼
Compare
   │
   ▼
Act
   │
   └────────┐
            │
            ▼
          Repeat
簡單來說,就是不斷觀察目前狀態、比較預期狀態,發現差異就採取行動,然後重複這個過程。
這正是 Kubernetes 最重要的設計理念之一。
經過前面的步驟,Controller 已經建立了 3 個 Pod。
但是,這些剛建立的 Pod 還不知道應該部署在哪一台 Node。
這時候,就輪到 kube-scheduler(Scheduler) 登場。
假設我們的 Cluster 有三台 Worker Node:
Worker Node 1
Worker Node 2
Worker Node 3
Scheduler 會透過 API Server 觀察尚未分配 Node 的 Pod,並根據各種條件選擇適合的 Node。
例如,Scheduler 需要考慮 Node 是否具有足夠的 CPU 與 Memory 資源,以及 Pod 設定的 nodeSelector、Affinity、Taint 與 Toleration 等排程條件。
這些名詞後面的文章都會實際操作,目前只需要知道它們會影響 Pod 可以部署在哪台 Node。
假設 Scheduler 最後決定:
Pod 1 → Worker Node 1

Pod 2 → Worker Node 2

Pod 3 → Worker Node 2
Scheduler 就會透過 API Server 完成 Pod 與 Node 的綁定。
這裡有個重要觀念:
Scheduler 只負責決定 Pod 要去哪台 Node,並不負責實際建立或啟動 Container。
接下來才是真正執行 Pod 的階段。
每一台 Kubernetes Node 都會執行一個名為 kubelet 的代理程式。
當 Scheduler 決定將 Pod 部署到某台 Node 後,該 Node 上的 kubelet 就會透過 API Server 得知自己需要執行哪些 Pod。
例如,Worker Node 2 的 kubelet 發現自己被分配了兩個 Nginx Pod,就會開始處理建立工作。
API Server
    │
    │ 提供 Pod 的設定與分配資訊
    ▼
Worker Node 2
    │
    ▼
  kubelet
    │
    ├── Nginx Pod 2
    │
    └── Nginx Pod 3
大致流程: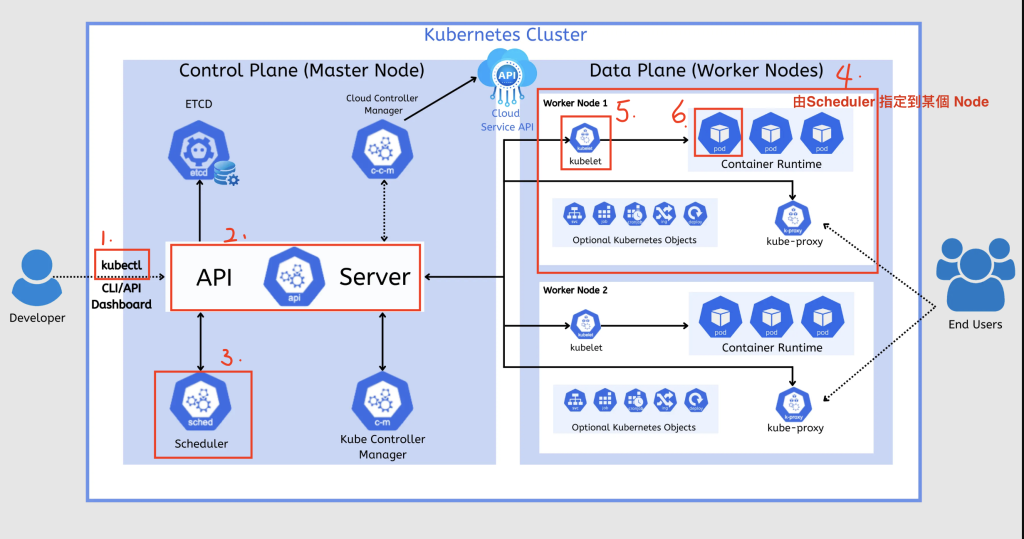
不過,kubelet 本身並不是 Container Runtime,它不會親自建立或執行 Container。
它的主要工作是確保 Node 上的 Pod 按照設定執行,並持續監控與回報 Pod 的執行狀態。
因此,它還需要與下一個元件合作。
我們終於來到實際啟動 Container 的階段。
Kubernetes 使用 Container Runtime 執行及管理容器,例如 containerd 或 CRI-O。
而 kubelet 與 Container Runtime 之間,則透過 CRI(Container Runtime Interface)進行溝通。
CRI 是 Kubernetes 定義的一套標準介面,讓 kubelet 可以使用統一的方式,要求不同的 Container Runtime 執行容器管理工作。
以 containerd 為例:
kubelet
   │
   │ CRI
   ▼
containerd
   │
   ▼
containerd-shim
   │
   ▼
runc
   │
   ▼
Nginx Container
當 kubelet 需要執行 Nginx Pod 時,就會透過 CRI 請求 containerd 準備 Pod Sandbox、下載所需 Image,並建立及啟動 Container。
containerd 再透過 containerd-shim 與 runc 等底層元件完成執行工作。
最終,我們的 Nginx Container 才會真正開始運作。
所以,記住這兩者的差異:
kubelet 負責確保 Pod 正常運作,而 Container Runtime 負責實際執行及管理 Container。
至於 CRI、containerd、Docker 和 Podman 之間的完整關係,我們會在後續文章進一步介紹。
前面已經完成建立 3 個 Nginx Pod 的主要流程,但架構圖上還有一個元件尚未介紹,那就是 kube-proxy。
kube-proxy 是 Kubernetes 的網路元件,通常部署在各個 Node 上,主要負責實作 Service 的網路轉送規則。
例如,我們建立了一個 Nginx Service,讓其他 Application 不需要知道每個 Nginx Pod 的實際 IP,就可以透過同一個 Service 存取後端 Pod。
在傳統的 kube-proxy 架構中,它會監看 API Server 提供的 Service 與 EndpointSlice 等資訊,並設定對應的網路轉送規則。
需要注意的是,kube-proxy 不是實際建立 Pod 網路的元件,也不是所有 Kubernetes Cluster 都一定需要使用它。例如,部分 CNI(Container Network Interface)方案可以使用 eBPF 等技術取代 kube-proxy 的功能。
目前只需要記住:
Scheduler 負責決定 Pod 在哪裡執行,kubelet 與 Container Runtime 負責執行 Pod,而 kube-proxy 主要負責 Service 的網路轉送。
現在,回到今天最開始的問題。
當我們執行:
kubectl apply -f nginx.yaml
希望 Kubernetes 建立 3 個 Nginx Pod 時,實際上會發生以下事情:
1. kubectl apply
       │
       ▼
2. API Server 接收並驗證請求
       │
       ▼
3. etcd 儲存 Deployment
       │
       ▼
4. Deployment Controller
       │
       │ 建立 ReplicaSet
       ▼
5. ReplicaSet Controller
       │
       │ 建立 3 個 Pod
       ▼
6. Scheduler
       │
       │ 選擇適合的 Node
       ▼
7. Node 上的 kubelet
       │
       │ 發現需要執行的 Pod
       ▼
8. Container Runtime
       │
       │ 建立與啟動 Container
       ▼
9. Nginx Pods 開始運作
這裡要補充的是,上面的圖屬於方便理解的概念流程。
實際上,Kubernetes 的各個元件不是依序直接呼叫下一個元件,而是大多透過 API Server 讀取、監看及更新資源狀態。不同 Controller 也可能同時進行工作。
理解這個差異非常重要,因為它直接影響 Kubernetes 的設計方式,以及後續遇到問題時的排查方法。
例如,當我們發現 Pod 一直無法正常運作時,就可以開始判斷問題可能發生在哪個階段。
如果 Pod 長時間處於 Pending 狀態,就可以檢查 Scheduler 是否找到符合條件的 Node;如果 Pod 已經分配 Node,卻一直處於 ContainerCreating 狀態,就可以進一步檢查 kubelet、Container Runtime、Image 下載或網路相關問題。
這樣一來,我們就不再只是把 Kubernetes 當成一個黑盒子。
你可能會好奇,為什麼 Kubernetes 不直接接收指令、建立 Container,反而要透過這麼多元件合作?
因為 Kubernetes 本質上是一套 Distributed System(分散式系統)。
它的目標不只是建立 Container,而是持續維持整個 Cluster 的預期狀態。
例如,我們要求 Kubernetes 維持 3 個 Nginx Pod,即使其中一個 Pod 意外消失,Controller 仍然會嘗試重新建立,讓系統回到預期狀態。
而 Scheduler、kubelet、Container Runtime 等元件,則各自負責不同階段的工作。
這種設計讓 Kubernetes 能夠持續協調大量資源,但也代表許多操作不是立即完成,而是透過不同元件逐步協調、更新狀態。
因此,執行 kubectl apply 成功,只代表 API Server 已經接受相關設定,並不代表所有 Pod 都已經建立完成並且正常運作。
這也是為什麼我們後續經常需要使用:
kubectl get pods -w
持續觀察 Pod 的狀態變化。
今天不需要死背所有 Kubernetes Component,只需要理解它們在建立 Pod 的過程中,各自負責什麼工作。
| Component | 主要職責 | 記憶方式 |
|---|---|---|
| API Server | 接收並處理 Kubernetes API 請求 | Kubernetes 的正門 |
| etcd | 儲存 Cluster 的重要狀態 | Kubernetes 的記憶 |
| Controller Manager | 持續協調實際狀態與預期狀態 | 維持 Desired State |
| Scheduler | 決定 Pod 應該部署在哪台 Node | 幫 Pod 選擇 Node |
| kubelet | 確保 Node 上的 Pod 按照設定執行 | Node 上的管理員 |
| Container Runtime | 實際建立及管理 Container | 執行 Container |
| kube-proxy | 實作 Service 的網路轉送 | Service 網路轉送 |
整個 Kubernetes Architecture 最重要的觀念,就是不同元件各司其職,透過 API Server 交換資訊,並持續將 Cluster 維持在預期狀態。
理解這個過程之後,後面學習 Deployment、ReplicaSet、Scheduler、NetworkPolicy,以及 Kubernetes 故障排查時,就會更容易知道每個操作背後究竟發生了什麼事情。
明天開始,我們就要實際在自己的電腦上建立 Kubernetes Cluster!
1 Control Plane
       +
2 Worker Nodes
而且不需要準備三台實體 Server。
我們會透過 kind,直接在自己的電腦上建立完整的 Kubernetes 實驗環境,開始實際操作今天介紹的各個元件。


 iThome鐵人賽
 看影片追技術