
到目前為止,我們在 Kubernetes 裡面用過很多 Resource,例如:
Pod
Deployment
Service
ConfigMap
Secret
StatefulSet
所謂 Resource,可以先把它理解成:
Kubernetes API 裡面可以被建立、查詢、修改、刪除的一種物件。
例如你建立一個 Deployment:
kubectl get deployment
Kubernetes API Server 就知道:
Deployment 是什麼
它有哪些欄位
它應該怎麼被管理
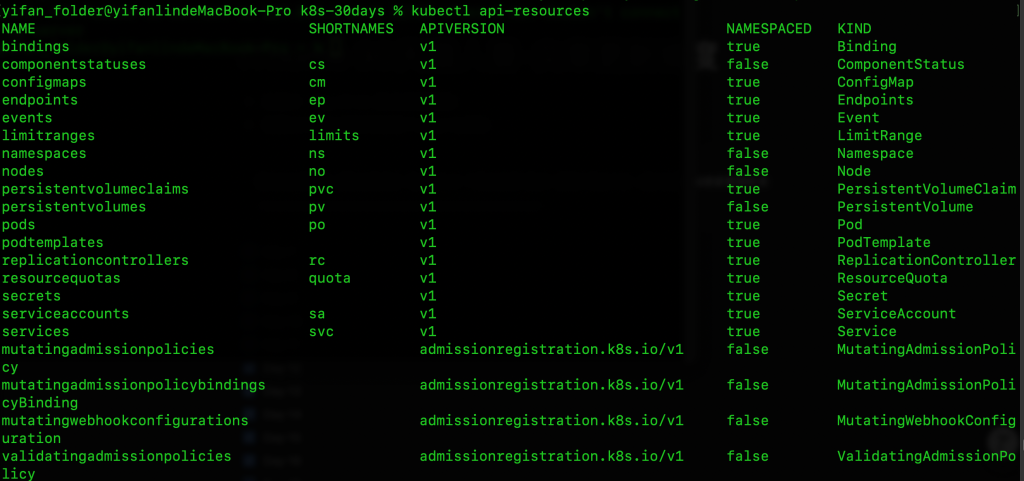
你可以先執行:
kubectl api-resources
會看到 Kubernetes 目前認識的 Resource:
pods
deployments
services
configmaps
secrets
...
密密麻麻 超多!
不過這裡有一個非常重要的地方:
Kubernetes 認識的 Resource
並不只有 Kubernetes 原生內建的 Resource。
因為 Kubernetes 的 API 是可以被擴充的。
先執行:
kubectl get crd
CRD 全名叫做:
CustomResourceDefinition
中文可以理解成:
自訂 Resource 的「定義」。
前面我們安裝過:
Calico
Gateway API
這類 Cloud Native 工具通常會額外加入一些 Kubernetes 原本沒有的 Resource,所以你現在執行:
kubectl get crd
很可能會看到一大堆陌生名稱。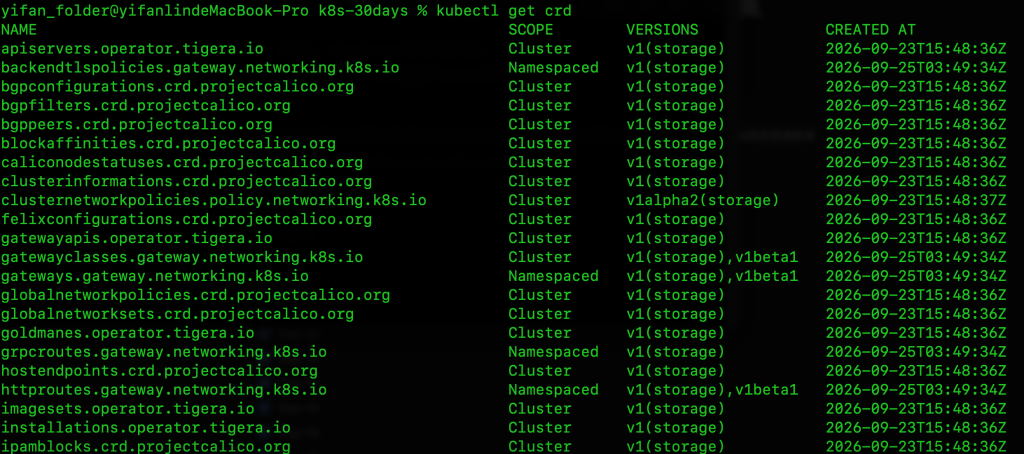
這並不是 Kubernetes 突然多出很多內建功能,而是我們安裝的軟體利用 CRD 擴充了 Kubernetes API。
假設 Kubernetes 原本只有:
Pod
Deployment
Service
但是今天我們希望 Kubernetes 也可以管理:
Database
甚至希望以後可以這樣操作:
kubectl get databases
問題是 Kubernetes 原本根本不知道:
Database 是什麼東西?
這時就可以透過 CRD 告訴 Kubernetes:
我要增加一種新的 Resource,它叫做 Database。
所以 CRD 最核心的功能就是:
擴充 Kubernetes API
你不需要自己重新寫一套 API Server。
仍然可以繼續使用:
kubectl
API Server
YAML
RBAC
Namespace
這整套 Kubernetes 原本的機制。
我們直接做一次。
建立:
vim database-crd.yaml
內容如下:
apiVersion: apiextensions.k8s.io/v1
kind: CustomResourceDefinition

metadata:
  name: databases.example.ironman

spec:
  group: example.ironman

  scope: Namespaced

  names:
    plural: databases
    singular: database
    kind: Database
    shortNames:
      - dbdemo

  versions:
    - name: v1

      served: true
      storage: true

      schema:
        openAPIV3Schema:
          type: object

          properties:
            spec:
              type: object

              properties:
                engine:
                  type: string

                size:
                  type: string
這一段第一次看會很陌生,我們拆開來看。
kind: CustomResourceDefinition這代表我們現在不是在建立 Database。
而是在建立:
Database 這種 Resource 的「定義」
可以想成:
CRD = 設計圖
Custom Resource = 根據設計圖建立出來的物件
等等我們才會真的建立:
my-database
這裡:
group: example.ironman
是在建立一個新的 API Group。
你以前其實已經看過 API Group。
例如 Deployment:
apiVersion: apps/v1
這裡:
apps
就是 API Group。
我們現在自己定義:
example.ironman
所以等等 Database 的 apiVersion 就會變成:
apiVersion: example.ironman/v1
也就是:
API Group / Version
這裡:
scope: Namespaced
代表這個 Resource 屬於某個 Namespace。
所以等等我們可以建立:
cka-lab Namespace
└── my-database
查詢時也需要:
kubectl get databases -n cka-lab
另一種 scope 是:
Cluster
代表整個 Cluster 只有一份,不隸屬某個 Namespace。
這段:
names:
  plural: databases
  singular: database
  kind: Database
  shortNames:
    - dbdemo
是在告訴 Kubernetes 這個 Resource 要叫什麼。
所以我們之後可以:
kubectl get databases
也可以:
kubectl get database
甚至:
kubectl get dbdemo
而 YAML 裡面的:
kind:
則會寫:
kind: Database
這裡:
schema:
  openAPIV3Schema:
是在定義這個 Resource 的資料結構。
我們目前允許:
spec:
  engine: postgres
  size: small
其中:
engine:
  type: string
代表 engine 必須是字串。
例如:
postgres
mysql
redis
而:
size:
  type: string
也代表 size 是字串。
例如:
small
medium
large
所以 CRD 不只是在取一個名字。
它也可以規定:
這個新的 Kubernetes Resource 可以有哪些欄位,以及欄位必須是什麼資料型態。
執行:
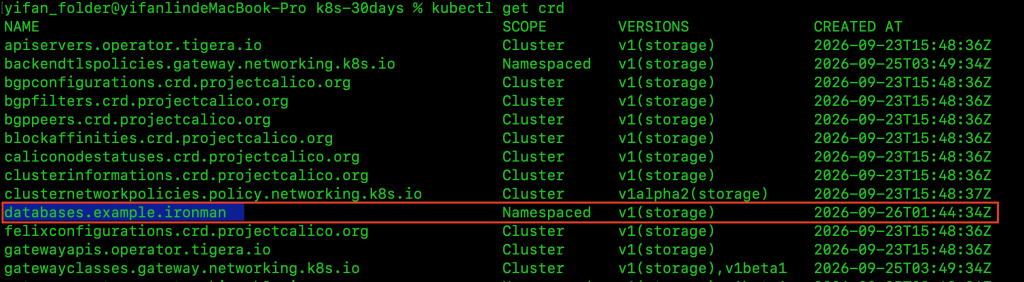
kubectl apply -f database-crd.yaml
確認:
kubectl get crd
應該可以看到:
databases.example.ironman
接著執行:
kubectl api-resources | grep -i database
你會發現真的出現:
databases

這件事情其實非常關鍵。
因為在幾秒鐘前:
Kubernetes 根本不知道 Database 是什麼。
現在 API Server 已經認識:
Database
了。
這時我們才真正建立一個 Database。
先看一下官方的描述:
After the CustomResourceDefinition object has been created, you can create custom objects. Custom objects can contain custom fields. These fields can contain arbitrary JSON. In the following example, the cronSpec and image custom fields are set in a custom object of kind CronTab. The kind CronTab comes from the spec of the CustomResourceDefinition object you created above.
https://kubernetes.io/docs/tasks/extend-kubernetes/custom-resources/custom-resource-definitions/
先建立:
vim my-database.yaml
寫入:
apiVersion: example.ironman/v1
kind: Database

metadata:
  name: my-database
  namespace: cka-lab

spec:
  engine: postgres
  size: small
這個物件就叫做:
Custom Resource
簡稱:
CR
所以一定要把這兩個東西分清楚:
CRD
=
定義 Database 這種 Resource 在 k8s API 中

CR
=
真的利用我們先前的 CRD 去建立一個 Database Resource
用 OOP 的觀念來看的話,就可以類比成:
Class
↓
Object
CRD 比較像 Class。
Custom Resource 比較像真正建立出來的 Object。
執行:
kubectl apply -f my-database.yaml
現在查詢:
kubectl get databases -n cka-lab
應該會看到:
也可以:
kubectl describe database my-database -n cka-lab
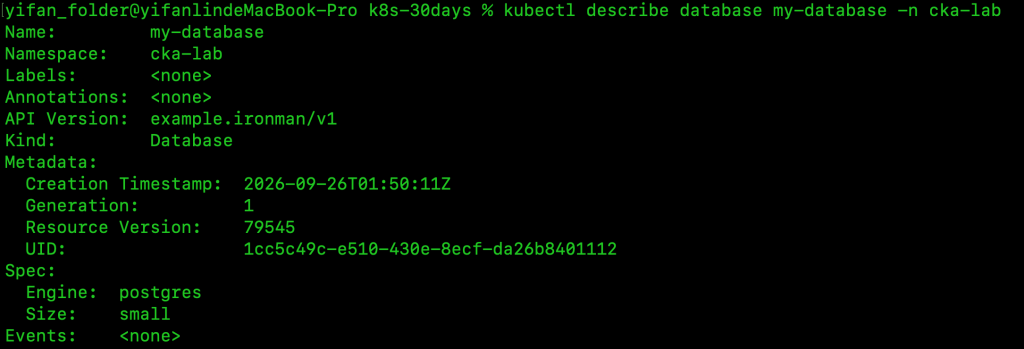
或者:
kubectl get database my-database \
  -n cka-lab \
  -o yaml
到這一步,你已經真的:
自己擴充了 Kubernetes API。
這時很多人會產生一個非常合理的疑問。
我們明明寫了:
spec:
  engine: postgres
  size: small
那執行:
kubectl get pods -n cka-lab
為什麼沒有新的 PostgreSQL?
原因就是:
CRD 只負責定義「Database 這種資料可以存在」。
Kubernetes 現在只知道:
有一個 Resource
叫做 my-database

它的 engine 是 postgres
它的 size 是 small
但沒有人告訴 Kubernetes:
engine = postgres

代表要建立 PostgreSQL Container
也沒有人告訴它:
size = small

到底代表幾 CPU
多少 RAM
多少 Storage
所以:
CRD 本身不會幫你執行任何應用程式。
這時就缺少另一個核心角色:
Controller
其實 Controller 從 Kubernetes 一開始就在大量使用。
Controller 可以先理解成:
持續觀察目前狀態,並想辦法讓 Actual State 靠近 Desired State 的程式。
也就是最核心的 Kubernetes 思想:
Desired State
      ↓
Controller
      ↓
Actual State
例如 Deployment:
replicas: 3
代表 Desired State 是:
我要 3 個 Pod。
如果現在只有:
2 個 Pod
Controller 發現:
Desired = 3
Actual = 2
就會再建立一個。
既然我們現在透過 CRD 自己建立了一種新的 Kubernetes Resource:
Database
那麼接下來就可以自己寫一個專門管理 Database 的 Custom Controller。
Controller 可以把它想成一個「一直在巡邏的自動管理程式」。它會持續觀察 Kubernetes API Server 裡的 Resource,確認目前狀態是否符合我們在 spec 中宣告的期望狀態(Desired State)。這也是 Kubernetes Controller 最核心的設計概念。
例如我們建立:
kind: Database

spec:
  engine: postgres
  size: small
Custom Controller 看到這個 Database 之後,就可以自動幫我們建立真正需要的 Kubernetes Resource:
Database: my-database
        ↓
Custom Controller
        ↓
建立 PostgreSQL StatefulSet
        ↓
建立 Service
        ↓
建立 PVC
        ↓
持續檢查目前狀態
也就是說,使用者只需要告訴 Kubernetes:
我要一個 PostgreSQL Database
至於背後要建立 StatefulSet、Service、PVC 等細節,就交給 Controller 自動處理。
Controller 最重要的工作可以用一個詞表示:
Reconcile
Reconcile 可以理解成:
比較「你想要的狀態」和「現在真正的狀態」,如果不同,就想辦法把它修正回來。
例如:
期望狀態
PostgreSQL Replica = 3

        ↓ Reconcile

實際狀態
PostgreSQL Replica = 2

        ↓

Controller 發現少一個
        ↓
重新建立
        ↓

實際狀態 = 3
所以 Controller 並不是只在第一次建立 Resource 時執行一次,而是會不斷進行這種:
Watch
 ↓
Compare
 ↓
Reconcile
 ↓
Watch
 ↓
...
這正是 Kubernetes 能夠做到「自動修復」的重要原因。
如果想了解最原始、比較接近 Kubernetes 本身的 Controller 寫法,可以參考 Kubernetes 官方的:
kubernetes/sample-controller
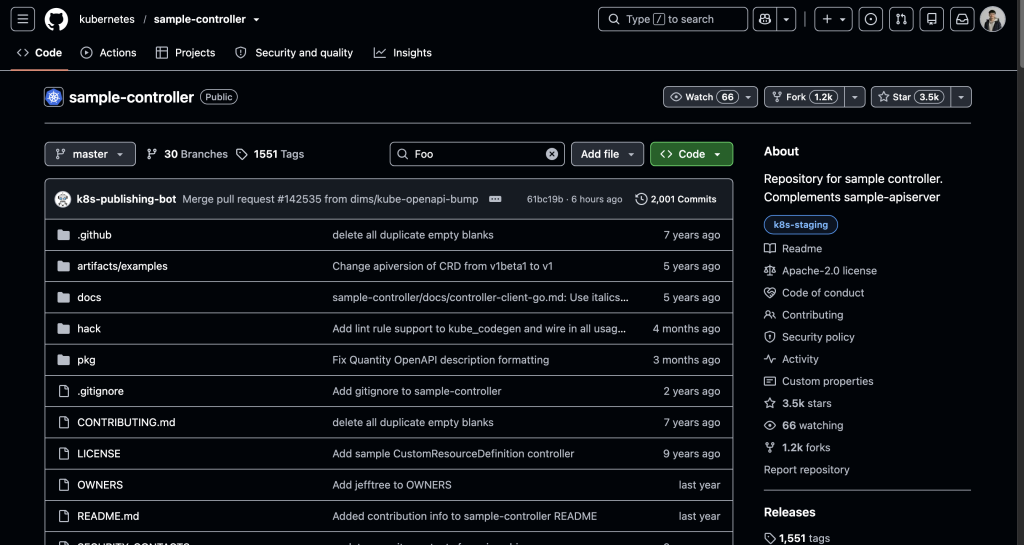
https://github.com/kubernetes/sample-controller
這個 Repository 是 Kubernetes 官方提供的 Controller 教學範例,它自己定義了一個叫做:
Foo
的 Custom Resource,然後示範如何用 Go 與 client-go:
建立 CRD
↓
監看 Foo Resource
↓
收到 Create / Update / Delete 事件
↓
放入處理 Queue
↓
執行 Controller 邏輯
↓
建立或修改其他 Kubernetes Resource
Repo 中也示範了 Typed Client、Informer、Lister、DeepCopy 等 Controller 常見元件,部分程式碼則透過 Kubernetes code-generator 自動產生。
而且官方 README 本身就有提到類似 Database 的使用案例,例如透過 Custom Resource 管理 CloudSQL、RDS 等 Database,或利用一個高階 Resource 自動建立底層的 Service 與其他 Kubernetes Resource。
不過要注意:
sample-controller
比較適合拿來理解 Controller 底層到底怎麼運作,而不是代表現在所有 Custom Controller 都直接複製這個專案。
現在實務開發新的 Controller / Operator 時,更常見的是:
Kubebuilder
      ↓
controller-runtime
      ↓
自己寫 Reconcile()
controller-runtime 本身就是 Kubernetes SIG 維護的 Controller 開發函式庫,而 Kubebuilder 與 Operator SDK 都建立在它之上,因此可以幫我們省掉大量 Informer、Queue、Client 等底層樣板程式。
因此可以把兩者理解成:
sample-controller
      ↓
理解 Controller 底層原理

Kubebuilder / controller-runtime
      ↓
實務上更方便地開發 Controller
所以學習時看 sample-controller 非常有價值,因為它能讓我們真正理解:
Watch → Queue → Process → Reconcile
這整套 Kubernetes Controller 背後到底在做什麼。
知道:
CRD
Custom Resource
Custom Controller
之後,Operator 就很好理解了。
Operator 可以大致理解成:
CRD
+
Custom Controller
+
Domain Knowledge
其中 Domain Knowledge 指的是:
某個特定軟體或系統的專業維運知識。
例如管理 PostgreSQL,其實不是單純建立一個 Container 就結束。
真正管理 Database 時,還需要處理:
怎麼初始化 Database Cluster

怎麼建立 Replica

Primary 掛掉怎麼 Failover

怎麼 Backup

怎麼 Restore

怎麼 Upgrade PostgreSQL

怎麼管理 Storage
這些原本通常是 DBA 或維運工程師需要處理的事情。
Operator 的核心概念就是:
把原本需要人類維運專家執行的操作與知識,寫進 Kubernetes Controller 裡。
因此 PostgreSQL Operator 可能讓我們只需要建立:
kind: PostgreSQLCluster

spec:
  replicas: 3
  storage: 100Gi
Operator 看到這個 Custom Resource 後,就會按照我們設定的 Desired State,自動管理背後真正需要的:
StatefulSet
Service
PVC
Replica
Failover
Backup
Restore
而且不是只「建立一次」就結束。
Operator 會持續執行:
Watch
  ↓
檢查 Desired State
  ↓
檢查 Actual State
  ↓
Reconcile
  ↓
持續監控
所以如果 Replica 掛掉、設定改變,甚至某些 Operator 支援 Backup、Upgrade 或 Failover,它都可以自動進行對應處理。
OperatorHub 對 Operator 的描述也特別強調這一點:Operator 不只可以處理 Day 1 的安裝與設定,也可以把更新、備份、故障切換、還原等 Day 2 維運工作自動化。
實務上我們當然不一定要每次都自己從頭寫 Operator。
Kubernetes 生態系裡已經有很多現成的 Operator,因此有一個網站:
https://operatorhub.io
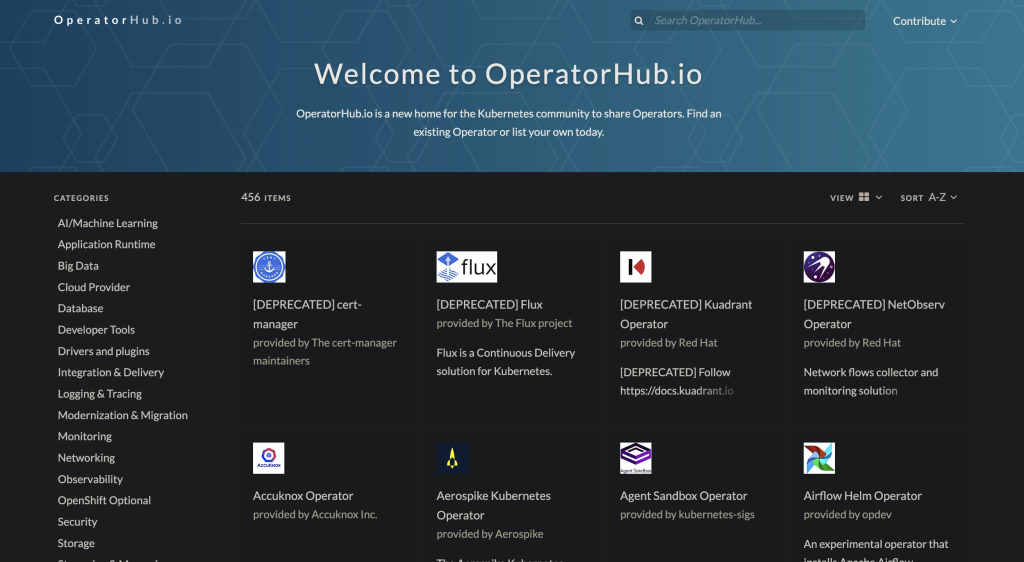
叫做:
OperatorHub.io
可以把它理解成:
Kubernetes Operator 的集中目錄。
OperatorHub.io 的目標就是提供一個集中位置,讓使用者可以尋找社群已經開發好的 Operator。
例如裡面可以找到不同種類的 Operator:
Database
Monitoring
Logging
Security
Storage
Networking
AI / Machine Learning
...
網站本身也可以依照:
Category
Provider
Capability Level
來搜尋 Operator。
所以假設今天我們想在 Kubernetes 裡部署某個複雜系統,不一定要立刻開始寫:
CRD
+
Controller
+
Reconcile Logic
而可以先去 OperatorHub 搜尋:
有沒有別人已經寫好的 Operator?
概念就像:
想部署 Application
        ↓
可能先找 Helm Chart

想讓 Kubernetes
自動管理某個複雜系統
        ↓
可以先找 Operator
        ↓
OperatorHub.io
不過要注意,OperatorHub.io 並不是 Operator 本身,也不是 Kubernetes 內建功能。
它比較像:
Operator Catalog / Registry
背後的 Operator 主要來自社群提交,目前 OperatorHub.io 的資料來源是 community-operators GitHub Repository。
另外 OperatorHub 上的 Operator 通常會搭配:
OLM
Operator Lifecycle Manager
進行安裝與生命週期管理。
OLM 可以幫忙處理:
Operator 安裝
Operator 更新
Version Channel
Subscription
也就是不只是把 Operator 裝進 Cluster,而是進一步管理 Operator 本身的版本與更新。
因此可以先記成:
OperatorHub
=
找 Operator 的地方

OLM
=
管理 Operator 安裝與更新

Operator
=
真正負責管理 Application 的 Controller
前面安裝 Calico 的時候,其實我們就已經使用過:
Tigera Operator
只是當時還不知道它背後的概念。
當時我們先安裝:
Tigera Operator
接著建立 Calico 所需要的 Custom Resource。
整體其實就是:
Calico Custom Resource
        ↓
Tigera Operator
        ↓
讀取 Desired State
        ↓
建立 Calico Components
        ↓
calico-node
calico-kube-controllers
其他元件
        ↓
持續 Reconcile
因此 Operator 並不是一個很抽象的新東西。
我們前面其實已經真的使用過它。
這兩個非常容易混在一起。
Helm 主要解決的是:
如何把大量 Kubernetes YAML 整理、參數化並方便安裝。
流程比較像:
Helm Chart
    ↓
Template
    ↓
Render YAML
    ↓
送進 Kubernetes API
    ↓
建立 Resource
因此 Helm 可以把它想成:
Kubernetes Package Manager
例如:
helm install redis ...
Helm 可以幫我們建立:
Deployment
Service
ConfigMap
Secret
...
Operator 則不太一樣。
Operator 本身是一個長時間運行在 Cluster 裡面的:
Controller
它會一直做:
Watch Resource
      ↓
Desired State 改變
      ↓
檢查 Actual State
      ↓
執行操作
      ↓
Reconcile
      ↓
繼續 Watch
因此最簡單的記法是:
Helm
=
幫你把東西「安裝進去」

Operator
=
幫你把東西「持續管理下去」
可以把 Helm 想成:
Installer / Package Manager
而 Operator 比較像:
24 小時待命的自動化 System Administrator
當然兩者並不是互斥的。
實務上反而很常看到:
使用 Helm
   ↓
安裝 Operator
   ↓
Operator 開始運作
   ↓
建立 Custom Resource
   ↓
Operator 持續管理 Application
所以最後可以把整個關係記成:
CRD
│
├── 定義新的 Resource
│
▼
Custom Resource
│
├── 描述 Desired State
│
▼
Operator / Custom Controller
│
├── Watch
├── Reconcile
├── Domain Knowledge
│
▼
真正的 Kubernetes Resources
Deployment / StatefulSet / Service / PVC ...
而如果今天不想自己寫 Operator:
先去 OperatorHub.io 看看
有沒有現成的 Operator
這就是 Kubernetes Operator 生態系很重要的一部分。
因為今天的:
Database
只是我們拿來學 CRD 的測試 Resource。
可以直接刪除 CRD:
kubectl delete crd \
  databases.example.ironman
接著確認:
kubectl get crd | grep database
以及:
kubectl api-resources | grep -i database
應該就不會再看到它。
但這裡一定要記住一件非常重要的事情。
如果刪除:
CRD
那這個 CRD 底下存在的:
Custom Resources
也會被一起刪除。
例如:
Database CRD
├── database-a
├── database-b
└── database-c
如果直接:
kubectl delete crd databases.example.ironman
不是只有「定義」消失。
底下的 Custom Resource 也會一起消失。
所以 Production 環境看到:
kubectl delete crd ...
一定要非常小心。
到這裡你真正需要理解的,不是背:
CRD
CR
Controller
Operator
四個英文名詞。
而是要理解它們之間的關係。
原本 Kubernetes 已經有:
Pod
Deployment
Service
StatefulSet
...
這叫:
Built-in Resources
如果 Kubernetes 沒有我們需要的 Resource:
Database
我們可以使用:
CRD
告訴 Kubernetes:
我要新增 Database 這種 Resource。
接著建立:
Custom Resource
例如:
my-database
但這目前只是一筆 Desired State。
因此還需要:
Custom Controller
負責:
Watch
↓
Reconcile
↓
真的建立與維護資源
當 Controller 裡面再加入:
PostgreSQL
Calico
Kafka
Prometheus
這些特定領域的維運知識,就逐漸形成:
Operator Pattern
所以整體可以記成:
Kubernetes API
│
├── Built-in Resource
│   ├── Pod
│   ├── Deployment
│   └── Service
│
└── CRD
    │
    └── Custom Resource
          │
          ▼
    Custom Controller
          │
          ▼
       Reconcile
          │
          ▼
     Actual Resources
而 Operator 則可以理解為:
CRD
+
Custom Resource
+
Custom Controller
+
Domain Knowledge
=
Operator
這也是為什麼 Kubernetes 可以承載這麼龐大的 Cloud Native 生態。
它並不是一套:
只能使用官方功能的封閉系統
而是一個可以不斷被擴充的:
API + Controller Platform
理解這一點之後,你再回去看:
Calico
Gateway API
Prometheus Operator
PostgreSQL Operator
Argo CD
很多以前看起來很神秘的 Kubernetes 工具,就會突然變得合理很多。
理解:
CRD
Custom Resource
Controller
Reconcile
之後,其實就很適合順便認識另一個 Kubernetes 生態中非常重要的工具:
Argo CD
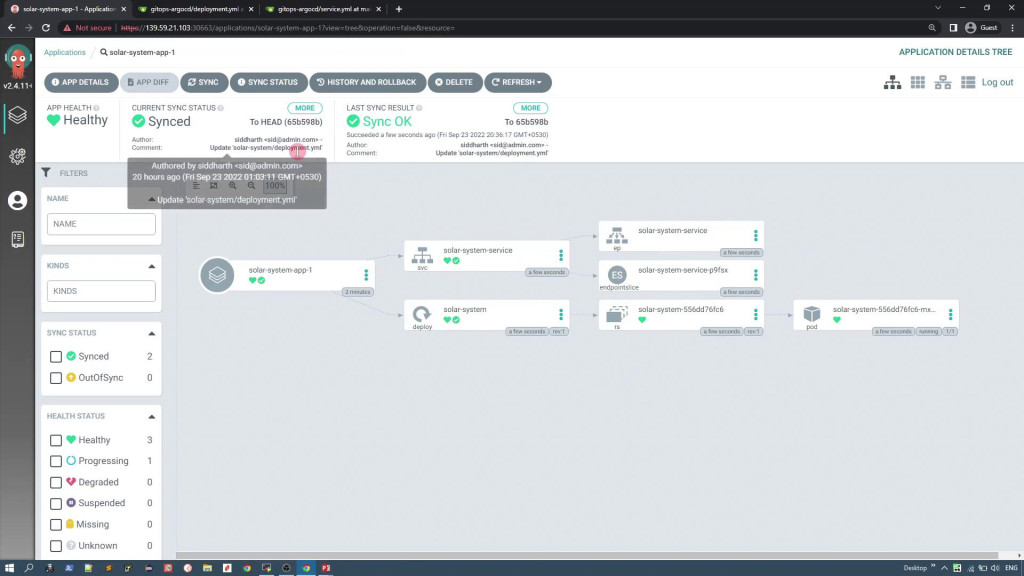
Argo CD 是一套專門替 Kubernetes 做 GitOps Continuous Delivery(持續部署) 的工具。
這裡先解釋一個新名詞:
GitOps
GitOps 的核心概念是:
把 Git Repository 裡面的設定,當成 Kubernetes「應該長什麼樣子」的唯一真實來源。
例如以前我們修改 Deployment,可能直接:
kubectl apply -f deployment.yaml
但使用 GitOps 之後,理想流程變成:
修改 deployment.yaml
        ↓
git commit
        ↓
git push
        ↓
Git Repository
        ↓
Argo CD 發現變更
        ↓
同步到 Kubernetes
也就是說,工程師不需要每次都直接進 Production Cluster 執行:
kubectl apply
而是:
改 Git
↓
Argo CD 幫你讓 Cluster 跟 Git 一致
Argo CD 官方就是以這種 GitOps 模型管理 Kubernetes Application:Desired State 放在 Git,而 Argo CD 持續比較 Git 與 Cluster 的實際狀態。
其實關係非常大。
還記得 Kubernetes Controller 的核心概念:
Desired State
      ↓
Controller
      ↓
Actual State
Deployment Controller 可能看到:
Desired replicas = 3
Actual replicas = 2
所以:
建立一個 Pod
Argo CD 做的事情非常像。
只是它的 Desired State 主要來自:
Git Repository
所以整體變成:
Git
│
│ Kubernetes YAML
│ Helm
│ Kustomize
│
▼
Desired State
        │
        ▼
Argo CD Application Controller
        │
        ▼
Kubernetes API Server
        │
        ▼
Actual State
Argo CD 裡有一個非常重要的元件:
argocd-application-controller
它就是一個 Kubernetes Controller。
它會持續查看目前 Cluster 裡真正存在的 Resource,並且和 Git 裡面定義的 Desired State 比較。官方文件也直接將 Application Controller 描述為「持續監控 Application,並比較 Live State 與 Git 中 Desired Target State」的 Controller。
所以你現在應該會發現:
Argo CD 並不是魔法。
它其實仍然建立在我們這幾天一直學的:
Watch
↓
Compare
↓
Reconcile
這套 Kubernetes 思想上。
這裡就更有趣了。
安裝 Argo CD 之後,它也會替 Kubernetes 加入自己的:
CRD
其中最重要的一個叫:
Application
所以安裝 Argo CD 後可以查:
kubectl get crd | grep argoproj
你會看到 Argo CD 自己定義的一些 Custom Resource。
也可以:
kubectl api-resources | grep argoproj
其中會看到類似:
applications
applicationsets
appprojects
也就是說:
Application
並不是 Kubernetes 原生 Resource。
它是 Argo CD 透過:
CRD
新增進 Kubernetes API 的 Custom Resource。官方文件也明確將 Application 與 AppProject 定義為 Kubernetes Custom Resource。
例如可以建立:
apiVersion: argoproj.io/v1alpha1
kind: Application

metadata:
  name: my-api
  namespace: argocd

spec:
  project: default

  source:
    repoURL: https://github.com/example/k8s-config.git
    targetRevision: main
    path: deploy/overlays/production

  destination:
    server: https://kubernetes.default.svc
    namespace: cka-lab
你現在應該已經可以看懂很多地方了。
首先:
apiVersion: argoproj.io/v1alpha1
kind: Application
代表:
這不是 Kubernetes 原生 Resource
而是:
Argo CD Application CRD
        ↓
建立出來的 Custom Resource
而:
source:
是在告訴 Argo CD:
我的 Desired State 在哪一個 Git Repository?
例如:
repoURL: https://github.com/example/k8s-config.git
targetRevision: main
path: deploy/overlays/production
代表:
Repository
    ↓
main branch
    ↓
deploy/overlays/production
就是我要部署的 Kubernetes 設定。
而:
destination:
則是在告訴 Argo CD:
這些 Resource 要部署去哪一個 Kubernetes Cluster 與 Namespace?
官方 Application CRD 的核心就是 source 指向 Desired State,destination 指向要部署的 Cluster 與 Namespace。
假設 Git 裡面有:
deploy/overlays/production/
├── deployment.yaml
├── service.yaml
└── kustomization.yaml
其中 Deployment 寫:
replicas: 3
Argo CD 會讀 Git:
Git Desired State

Deployment
replicas = 3
接著去問 Kubernetes API Server:
現在 Cluster 是什麼狀態?
假設發現:
Actual State

Deployment
replicas = 2
Argo CD 就知道:
Git
replicas = 3

Cluster
replicas = 2
兩邊:
不一致
Argo CD 把這種狀態稱為:
OutOfSync
當執行 Sync,或設定 Automatic Sync 時,Argo CD 就會把 Git 裡的 Desired State 套用到 Cluster。
最後重新變成:
Git
replicas = 3

        ↓ Sync

Kubernetes
replicas = 3
這其實又回到:
Desired State
↓
Reconcile
↓
Actual State
可以先用一個非常簡化的方式記:
Git
=
Application Desired State

Argo CD
=
負責 Reconcile 的 Controller

Kubernetes
=
Actual State
也就是:
Git Repository
      │
      │ Desired State
      ▼
┌───────────────┐
│    Argo CD    │
│  Application  │
│  Controller   │
└───────┬───────┘
        │
        │ Compare / Sync
        ▼
┌───────────────┐
│  Kubernetes   │
│    Cluster    │
└───────────────┘
這也是為什麼學完:
CRD
Controller
Reconcile
再學 Argo CD 會突然非常好理解。
概念上它和 Operator Pattern 有非常多共同基礎,因為 Argo CD 本身同樣大量使用:
CRD
+
Custom Resource
+
Controller
+
Reconciliation Loop
例如:
Application CRD
        +
Application Resource
        +
Application Controller
不過平常我們比較直接把 Argo CD 稱為:
GitOps Continuous Delivery Tool
而不是單純稱它為某個 Application 的 Operator。
因為 PostgreSQL Operator 的 Domain Knowledge 是:
如何管理 PostgreSQL
Calico Operator 的 Domain Knowledge 是:
如何建立與維護 Calico Networking
而 Argo CD 關心的是:
如何讓 Git 中宣告的 Kubernetes Desired State
持續與 Cluster Actual State 保持一致
所以它們底層大量使用相同的 Kubernetes Extensibility 與 Controller 思想,但解決的問題不同。
到這裡這三個東西就不要混在一起了。
Helm
│
│ 解決
▼
「這一大包 Kubernetes YAML
 要怎麼 Template、打包、安裝?」
例如:
helm install
比較像:
Package Manager
Operator 解決:
某個複雜 Application
部署之後要怎麼持續維運?
例如 PostgreSQL Operator:
建立 Database
Backup
Replica
Failover
Upgrade
比較像:
Automated Administrator
Argo CD 則解決:
Git 裡宣告的 Kubernetes 設定
怎麼持續與真正的 Cluster 保持一致?
比較像:
Git
↓
GitOps Controller
↓
Kubernetes
而且這三個東西甚至可以一起使用。
例如:
Git Repository
│
│ Application.yaml
▼
Argo CD
│
│ 發現要安裝 Helm Chart
▼
Helm Template
│
│ Render Kubernetes YAML
▼
Kubernetes
│
▼
Operator
│
│ 持續管理 Application
▼
PostgreSQL / Calico / Prometheus
所以它們不是互相取代的關係。
而是常常:
一起合作。
之後真的要練 Argo CD 時,可以先建立專用 Namespace:
kubectl create namespace argocd
接著安裝 Argo CD:
kubectl apply \
  -n argocd \
  --server-side \
  --force-conflicts \
  -f https://raw.githubusercontent.com/argoproj/argo-cd/stable/manifests/install.yaml
https://argo-cd.readthedocs.io/en/latest/getting_started/
官方 Getting Started 也是以 argocd Namespace 安裝 Argo CD,再建立 Application 指向 Git Repository 的方式開始操作。
安裝後可以先觀察:
kubectl get pods -n argocd
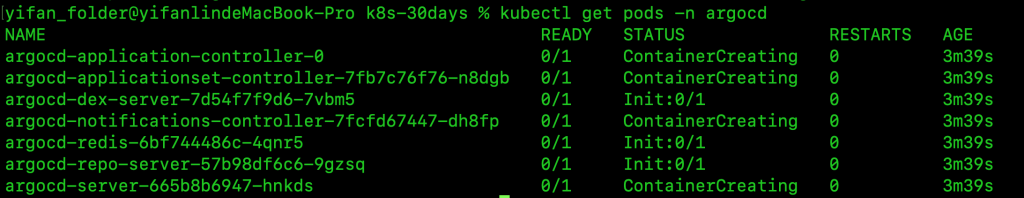
這個要等一下子才會變成 Running!
接著:
kubectl get crd | grep argoproj

這一步非常值得看。
因為你會親眼看到今天學的:
CRD
Argo CD 新增到 Kubernetes API 裡面的 Resource,
真的出現在眼前。
現在所有核心 Pod 狀態都是 1/1 Running,代表 Argo CD 已經在背景正常運行中。
接下來只需要打開它的 Web UI 介面並取得初始管理員密碼即可開始使用:
在終端機執行以下指令,將 argocd-server 的連接埠轉發到本機:
Bash
kubectl port-forward svc/argocd-server -n argocd 8080:443
執行後不要關閉該終端機視窗。
打開瀏覽器訪問:https://localhost:8080
(因為預設使用的是自我簽署憑證,瀏覽器出現「您的連線不是私人連線」警告是正常的,點擊「進階」並選擇「繼續前往」即可。)
登入的使用者名稱固定為:admin
預設初始密碼存放在 K8s Secret 裡,另開一個終端機分頁執行以下指令即可印出解碼後的密碼:
Bash
kubectl -n argocd get secret argocd-initial-admin-secret -o jsonpath="{.data.password}" | base64 -d; echo
複製輸出的這串密碼,貼回網頁即可順利登入 Argo CD 控制台。
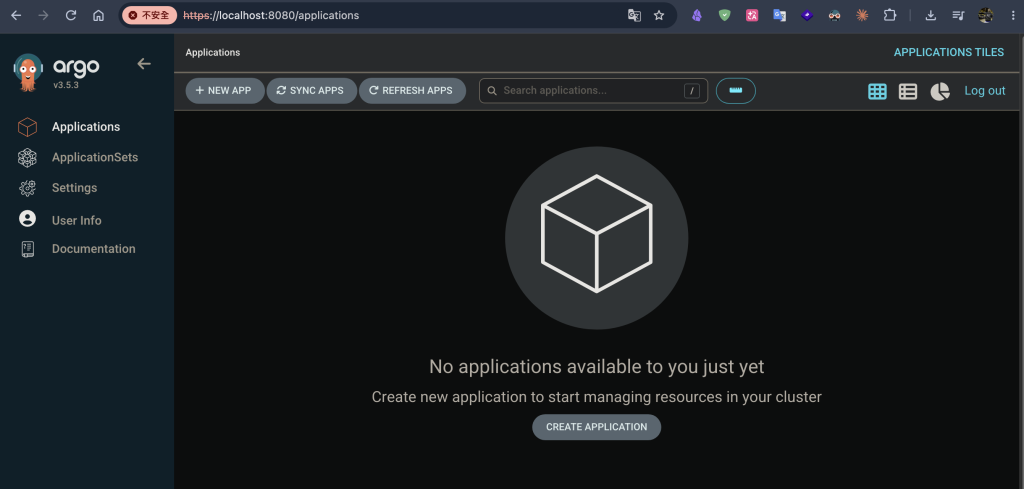
這時今天整堂課就真正串起來了:
Kubernetes 原本
│
├── Pod
├── Deployment
└── Service

        +

安裝 Argo CD
        │
        ▼
      CRD
        │
        ├── Application
        ├── ApplicationSet
        └── AppProject
                │
                ▼
            Controller
                │
                ▼
        Watch / Reconcile
                │
                ▼
Git Desired State ─────── Kubernetes Actual State
所以學 CRD、Controller、Operator 並不是只為了記 Kubernetes 冷門名詞。
因為往後接觸:
Argo CD
Prometheus Operator
Cert-Manager
Istio
Calico
Kafka Operator
PostgreSQL Operator
你會一直反覆看到同一套設計哲學:
宣告 Desired State
        ↓
Custom Resource
        ↓
Controller Watch
        ↓
Reconcile
        ↓
讓 Actual State 靠近 Desired State
而這正是 Kubernetes 最強大的地方之一:
Kubernetes 不只是拿來「跑 Container」,而是一個可以透過 API、CRD 與 Controller 不斷擴充的 Declarative Automation Platform。


 iThome鐵人賽
 看影片追技術