
Day 3 的時候,我們曾經看過 Kubernetes Control Plane 的核心架構:
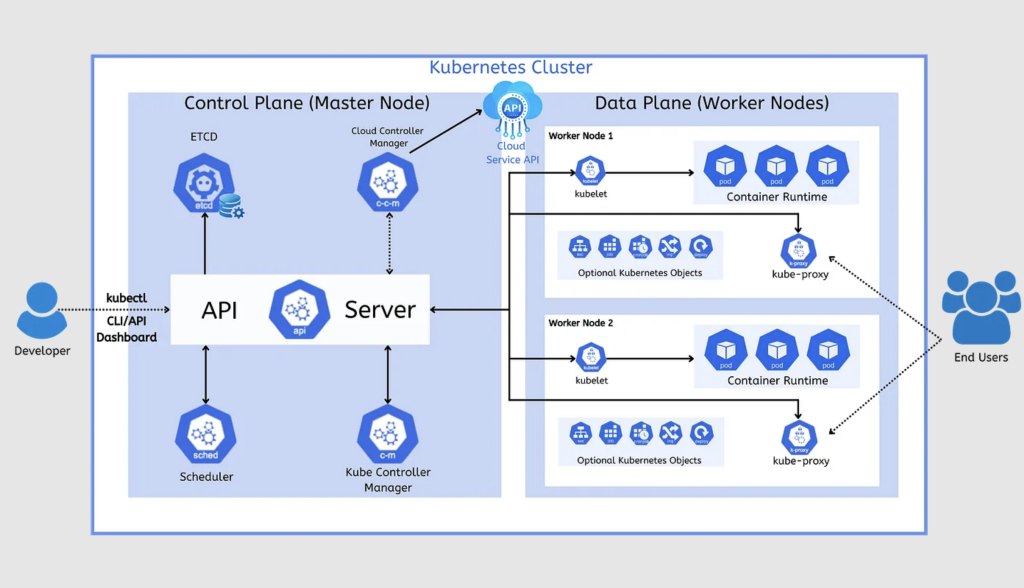
Image Source: https://aws.plainenglish.io/kubernetes-architecture-c93cb9c798d8
API Server
etcd
Scheduler
Controller Manager
kubelet
再給個解釋xd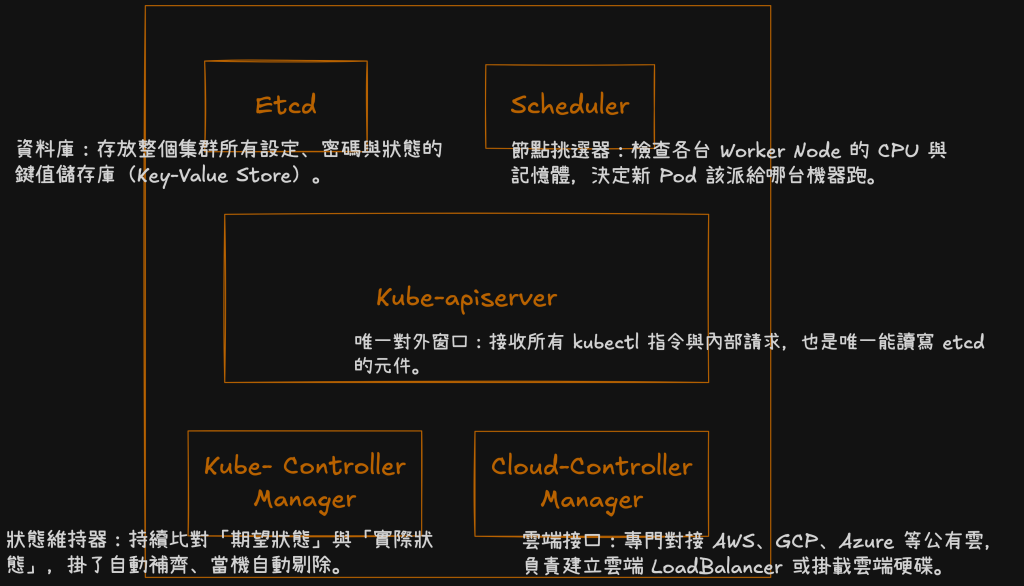
當時比較像是在「看架構圖」。
到了今天,我們不只看圖,而是直接進 Kubernetes Node 裡面,看看這些元件到底在哪裡、怎麼被啟動,以及當 kubectl 都不能用了之後,我們還能怎麼 Troubleshooting。
今天會開始碰到比較底層的 Kubernetes Cluster Lifecycle,也是 CKA 很重要的一部分。
Kubernetes Cluster 大致可以分成兩個角色:
Control Plane
Worker Node
Control Plane 可以理解成 Kubernetes 的「大腦」。
它負責接收指令、儲存 Cluster 狀態、決定 Pod 要跑在哪個 Node,以及持續確認實際狀態有沒有符合我們宣告的狀態。
其中最重要的幾個 Component 是:
kube-apiserver
kube-controller-manager
kube-scheduler
etcd
我們先直接看看目前的 Cluster。
kubectl get pods \
  -n kube-system \
  -o wide
如果使用的是我們前面建立的:
cka-lab
kind Cluster,應該會看到類似:
kube-apiserver-cka-lab-control-plane
kube-controller-manager-cka-lab-control-plane
kube-scheduler-cka-lab-control-plane
etcd-cka-lab-control-plane
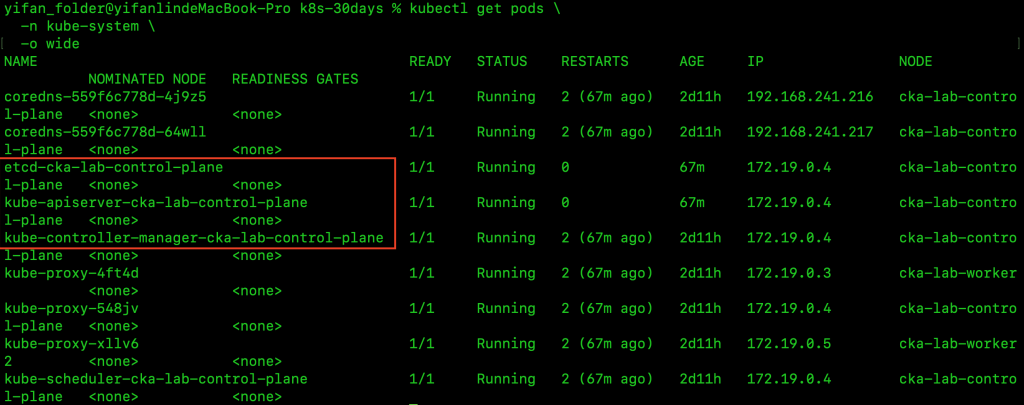
看到這裡其實有一個很有趣的問題。
這些東西看起來都是 Pod。
可是:
如果 API Server 本身都是 Pod,那 Kubernetes API Server 還沒啟動之前,到底是誰建立 API Server Pod?
如果一般 Pod 都要:
kubectl
↓
API Server
↓
Scheduler
↓
kubelet
↓
Pod
那 API Server 自己怎麼出生?
答案就是今天第一個重要名詞:
Static Pod
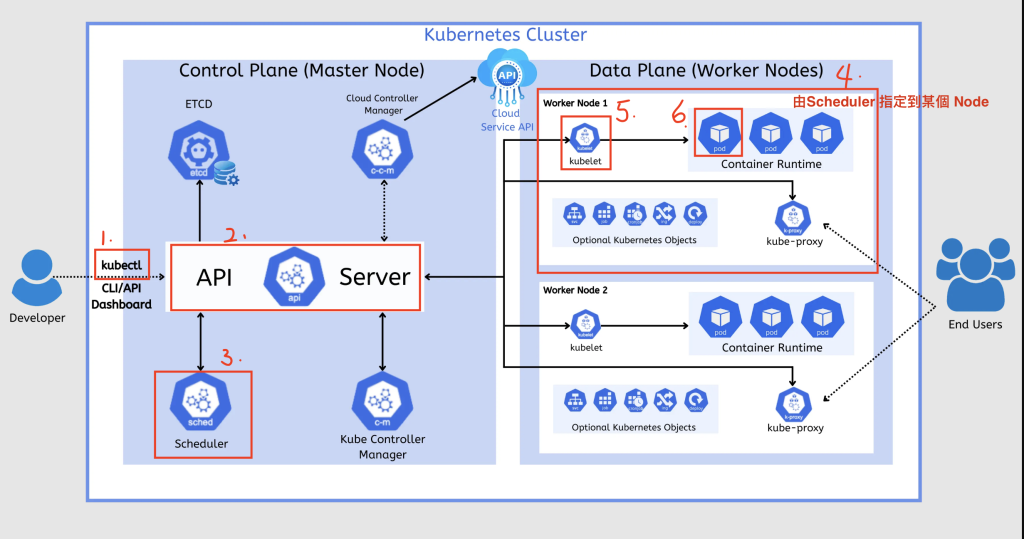
一般的 Pod 是由 Kubernetes API 管理的。
例如我們:
kubectl apply -f deployment.yaml
背後大致會經過:
kubectl
↓
API Server
↓
Scheduler
↓
指定 Node
↓
Node 上的 kubelet
↓
建立 Pod
示意圖:
但是 Static Pod 不一樣。
Static Pod 不需要先把 Pod YAML 丟給 API Server,也不需要 Scheduler 幫它選 Node。
它是:
Manifest File
↓
kubelet
↓
Pod
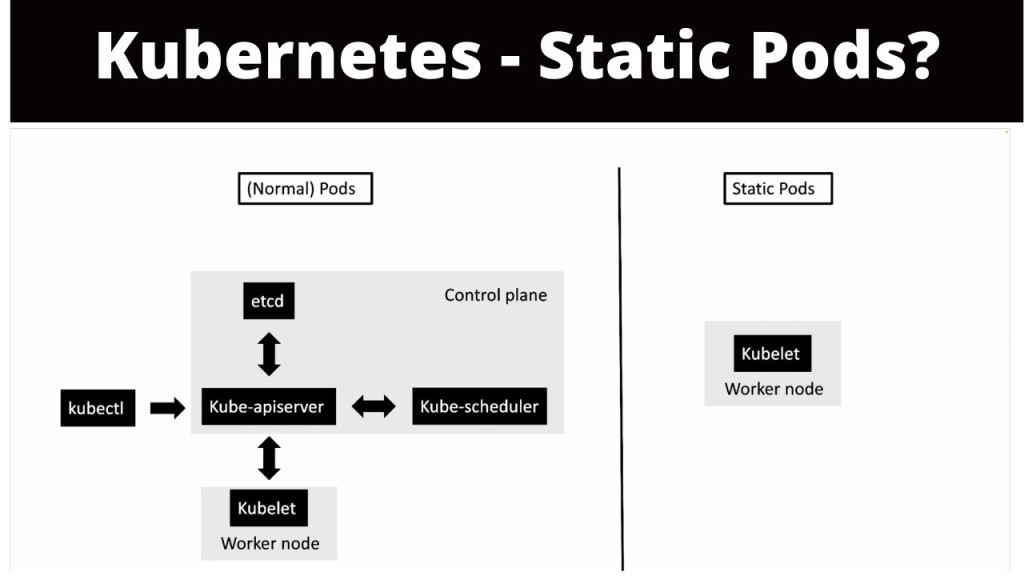
也就是某一台 Node 上的:
kubelet
直接監控本機的一個 Directory。
只要那個 Directory 裡面出現 Pod Manifest:
apiVersion: v1
kind: Pod
...
kubelet 就會直接把 Pod 建起來。
因此 Control Plane 才能解決剛才的「雞生蛋問題」。
即使:
API Server 還沒有啟動
Node 上面的 kubelet 還是可以先根據本機檔案,把:
etcd
kube-apiserver
kube-controller-manager
kube-scheduler
啟動起來。
這就是 Static Pod 最重要的用途之一。
我們現在使用的是:
kind
kind 全名是:
Kubernetes IN Docker
它的做法是把 Kubernetes Node 做成 Docker Container。
所以可以直接從 Mac 進入 Control Plane Node:
docker exec \
  -it \
  cka-lab-control-plane \
  bash
現在你已經不是在 Mac Terminal 的環境,而是在:
Kubernetes Control Plane Node
裡面。
接著查看:
ls /etc/kubernetes/manifests
應該會看到:
etcd.yaml
kube-apiserver.yaml
kube-controller-manager.yaml
kube-scheduler.yaml
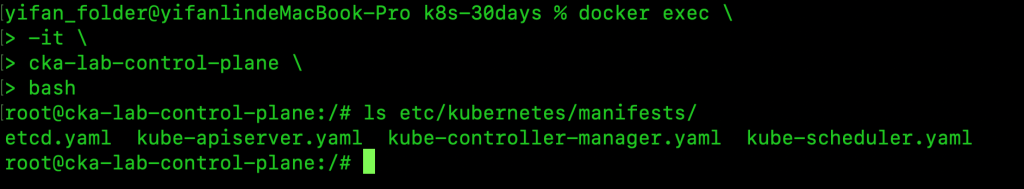
這幾個檔案非常重要。
因為它們不是概念圖,也不是 Kubernetes 偷偷藏起來的設定。
它們就是 Control Plane Component 真正在使用的:
Static Pod Manifest
可以直接:
cat /etc/kubernetes/manifests/kube-apiserver.yaml
你會看到類似:
apiVersion: v1
kind: Pod
metadata:
  name: kube-apiserver

spec:
  containers:
  - command:
    - kube-apiserver
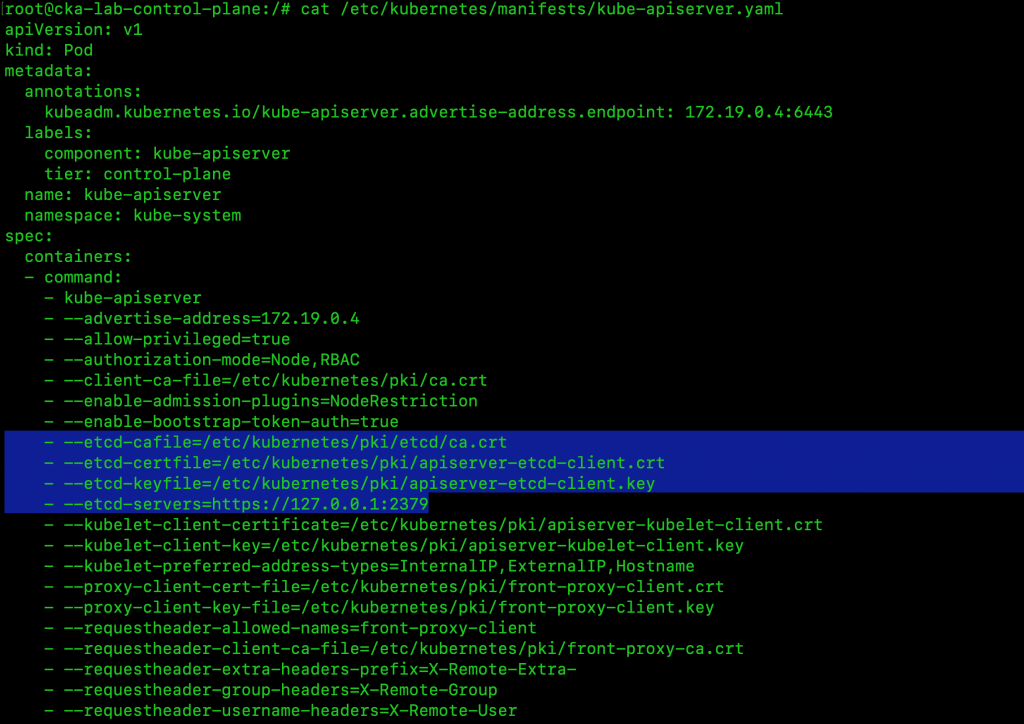
下面還會有大量參數,例如:
--etcd-servers
--client-ca-file
--tls-cert-file
--tls-private-key-file
也就是說,我們平常看到的:
kube-apiserver
其實最後還是透過一個 Pod Manifest 定義它要怎麼啟動。
/etc/kubernetes/manifests/kube-apiserver.yaml 是一份 Static Pod Manifest,它是在告訴 kubelet:
「請在這台 Control Plane Node 上,啟動一個
kube-apiserverContainer,而且要用這些參數、憑證、Port、Volume 與健康檢查方式來啟動。」
而你看到這一大串:
command:
- kube-apiserver
- --advertise-address=172.19.0.4
- --authorization-mode=Node,RBAC
- --etcd-servers=https://127.0.0.1:2379
- --secure-port=6443
- --tls-cert-file=/etc/kubernetes/pki/apiserver.crt
...
本質上就很像在 Linux Terminal 執行:
kube-apiserver \
  --advertise-address=172.19.0.4 \
  --authorization-mode=Node,RBAC \
  --etcd-servers=https://127.0.0.1:2379 \
  --secure-port=6443 \
  --tls-cert-file=/etc/kubernetes/pki/apiserver.crt \
  ...
只是現在不是你手動執行,而是:
Static Pod Manifest
        ↓
      kubelet
        ↓
    containerd
        ↓
kube-apiserver Container
        ↓
執行 kube-apiserver + 這些參數
所以那些 --xxx 可以理解成 kube-apiserver 這支程式的啟動參數(flags)。
例如:
- --secure-port=6443
意思就是:
kube-apiserver 的 HTTPS API 使用 6443 Port。
這也就是為什麼你平常 kubeconfig 裡的 API Server 常會看到:
https://...:6443
而:
- --etcd-servers=https://127.0.0.1:2379
是在告訴 API Server:
etcd 在哪裡?請連到本機的
127.0.0.1:2379。
因此整個關係是:
kubectl
   │
   ▼
kube-apiserver :6443
   │
   │ --etcd-servers
   ▼
etcd :2379
像這兩個:
- --tls-cert-file=/etc/kubernetes/pki/apiserver.crt
- --tls-private-key-file=/etc/kubernetes/pki/apiserver.key
則是在告訴 API Server:
你要提供 HTTPS,所以你的 Server Certificate 和 Private Key 在這裡。
而:
- --authorization-mode=Node,RBAC
是在告訴 API Server:
收到 API Request 之後,授權判斷要使用 Node Authorization 與 RBAC。
Node 上的 kubelet 會持續監控:
/etc/kubernetes/manifests
因此假設存在:
/etc/kubernetes/manifests/kube-apiserver.yaml
kubelet 就會知道:
這台 Node 應該存在 kube-apiserver Static Pod。
概念可以理解成:
/etc/kubernetes/manifests 裡面只要有yaml
          │
          ▼
       kubelet 就會自動去 create
          │
          ▼
     Static Pod 就會產生
如果 Container crash:
kubelet
↓
發現狀態不符合
↓
重新建立 Container
如果 Manifest 被修改:
kubelet
↓
發現設定改變
↓
依照新的 Manifest 自動更新 Static Pod
因此即使 Kubernetes API 本身還沒完全啟動:
kubelet
仍然可以管理這些 Control Plane Component。
你可能會想到另一個問題。
既然 Static Pod:
不是 API Server 建的
那為什麼:
kubectl get pods -n kube-system
還是看得到:
kube-apiserver-cka-lab-control-plane
?
這裡要認識第二個名詞:
Mirror Pod
Mirror Pod 可以理解成:
Static Pod 在 Kubernetes API 裡面的「投影」。
真正控制 Static Pod 的仍然是:
Node 上的 kubelet
但是等 API Server 啟動後,kubelet 會讓 API Server 裡出現一個對應的 Mirror Pod。
因此我們才能使用:
kubectl get pods
觀察它。
概念上是:
Static Pod Manifest
        │
        ▼
     kubelet
        │
        ├── 真正建立 Container
        │
        └── API Server
               │
               ▼
           Mirror Pod
所以:
kubectl 看到它
不代表:
kubectl 控制它。
真正的 Source of Truth 還是:
/etc/kubernetes/manifests
接下來進 Worker Node:
exit
回到 Mac 後:
docker exec \
  -it \
  cka-lab-worker \
  bash
這裡要認識 Kubernetes Node 上最重要的程式之一:
kubelet
kubelet 可以理解成:
Kubernetes 派駐在每一台 Node 上的 Agent。
Control Plane 會告訴 Node:
這裡應該跑哪些 Pod。
真正負責在 Node 上確保這些 Pod 存在的,就是 kubelet。
所以一台 Worker Node 可以粗略理解成:
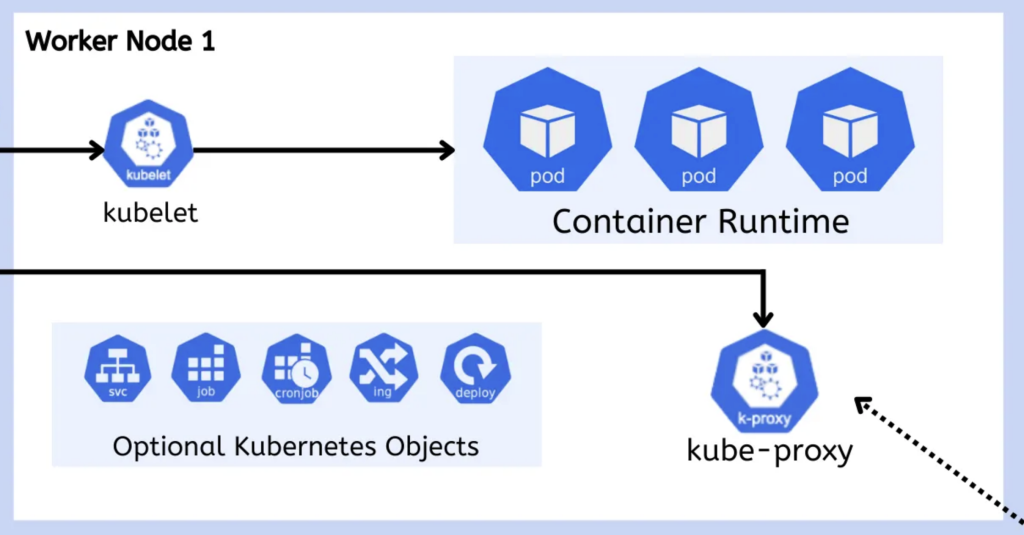
Worker Node
   │
   ├── kubelet
   │
   └── Container Runtime
其中 kubelet 負責:
我要哪些 Pod?
Pod 現在正常嗎?
Container 要不要重新啟動?
如果是真正的 Ubuntu VM,通常 kubelet 是由:
systemd
管理。
因此可以:
systemctl status kubelet
查看狀態。
Log 則常使用:
journalctl -u kubelet
但是我們現在使用的是:
kind
kind Node 本質上是 Docker Container,不是一般完整的 Ubuntu VM,因此通常不能把它完全當成一台 systemd 主機來操作。
在 kind Node 裡可以先使用:
ps aux | grep kubelet
查看 kubelet Process。
你應該會看到包含:
kubelet
的 Process。
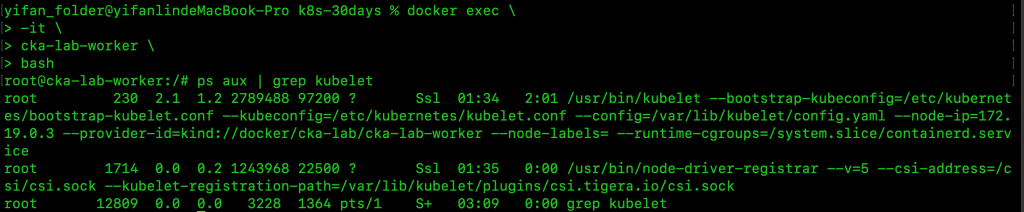
所以這裡要建立一個很重要的 Troubleshooting 觀念:
kind Lab
→ Docker / Process 層觀察

真正 Linux VM
→ systemctl / journalctl
之後真的在 CKA 或 Production Linux Node 上遇到:
Node NotReady
常見的第一件事就是:
systemctl status kubelet
再看:
journalctl -u kubelet
這裡很容易混淆。
平常 Application 出問題,例如:
FastAPI Pod
Redis Pod
PostgreSQL Pod
我們通常:
kubectl logs <pod-name>
因為我們要看的是:
Container / Application Log
但假設今天是:
Node NotReady
或:
kubelet 根本沒有正常工作
那問題已經不是 Application Layer。
這時在真正的 Linux Node 上會看:
journalctl -u kubelet
所以可以記:
Application / Container 問題
→ kubectl logs

Node Agent / kubelet 問題
→ systemctl
→ journalctl
這就是不同 Troubleshooting Layer 的差異。
接下來還有一個很重要的觀念。
kubelet 雖然負責:
確保 Pod 正常運行
但 kubelet 本身並不是 Container Runtime。
也就是:
kubelet
≠
真正執行 Container 的程式
kubelet 會透過:
CRI
跟 Container Runtime 溝通。
在 Kubernetes 中,kubelet 負責管理 Node 上的 Pod,但它並不會親自建立或執行 Container。 真正負責這些工作的,是 Container Runtime(容器執行環境)。
因此,Kubernetes 定義了一套標準介面,稱為 CRI(Container Runtime Interface),讓 kubelet 可以透過統一的方式與不同的 Container Runtime 溝通。
例如:
kubelet
   │
   │ CRI
   ▼
containerd
   │
   ▼
runc
   │
   ▼
Container
當 Kubernetes 需要建立 Pod 時,kubelet 就會透過 CRI 要求 containerd 建立 Pod Sandbox、下載 Image、建立及啟動 Container。
containerd 收到請求後,再透過 runc 等底層 OCI Runtime 建立實際的 Container。
簡單來說,CRI 是溝通規格,containerd 是實際接收並執行請求的 Container Runtime。
要理解這三者的關係,首先要知道 Container Runtime 其實可以分成不同層級。
現在讓我們先理解一下 Docker Architecture
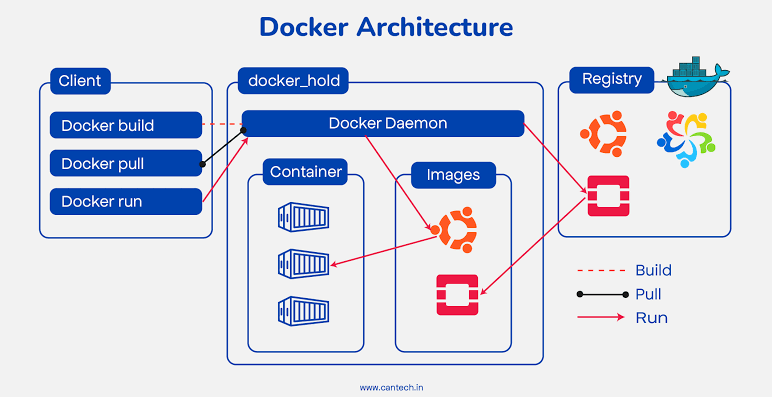
Source: https://www.cantech.in/blog/what-is-docker/
Docker 採用 Client-Server Architecture(客戶端-伺服器架構),主要包含三個部分:
docker build、docker pull 和 docker run。dockerd)負責接收 Client 的請求,並管理 Images、Containers、Networks 等資源。當我們使用 Docker CLI 執行指令時,Client 會透過 Docker API 與 Docker Daemon 溝通,再由 Daemon 協調後續工作。
圖中三個指令分別代表:
| 指令 | 運作流程 |
|---|---|
docker build |
根據 Dockerfile 建立 Image,並儲存在本地端。 |
docker pull |
從 Docker Registry 下載 Image 到本地端。 |
docker run |
使用 Image 建立並啟動 Container。若本地沒有 Image,預設會嘗試下載。 |
需要注意的是,這張圖省略了 Docker 底層真正執行 Container 的元件。
實際架構可以進一步展開:
Docker Client
     │
     │ Docker API
     ▼
Docker Daemon (dockerd)
     │
     ▼
containerd
     │
     ▼
containerd-shim
     │
     ▼
    runc
     │
     ▼
  Container
其中,Docker Daemon 是 Docker Engine 的管理核心,而 containerd 是高階 Container Runtime。
當我們執行 docker run 時,Docker Daemon 負責接收指令、協調 Image、Network 等資源,並透過 containerd 管理 Container 的生命週期。
containerd 再透過 containerd-shim 呼叫 runc,利用 Linux Kernel 提供的 Namespace、cgroups 等功能建立及啟動 Container。容器啟動後,runc 通常便會結束。
因此,Docker Daemon 並不是直接建立 Container 的底層執行工具,而是負責協調整個 Docker 系統。
最後記住:Docker CLI 負責發送指令、Docker Daemon 負責管理、containerd 負責容器生命週期,而 runc 負責實際建立及啟動 Container。
我們平常使用的 Docker,就是一套完整的容器開發與管理平台。透過 Docker,我們可以建置 Image、啟動 Container、設定網路及管理儲存空間。
了解 Docker 之後,Podman 就很容易理解了。
Podman 是一套開源的容器管理工具,定位與 Docker 相近,主要差別在於兩者的底層架構。
Podman 同樣可以建立 Image、啟動 Container、設定網路,而且許多指令與 Docker 十分相似。
例如:
docker run -d nginx
換成 Podman:
podman run -d nginx
兩者都能完成相同的容器操作,但內部的執行流程不同。
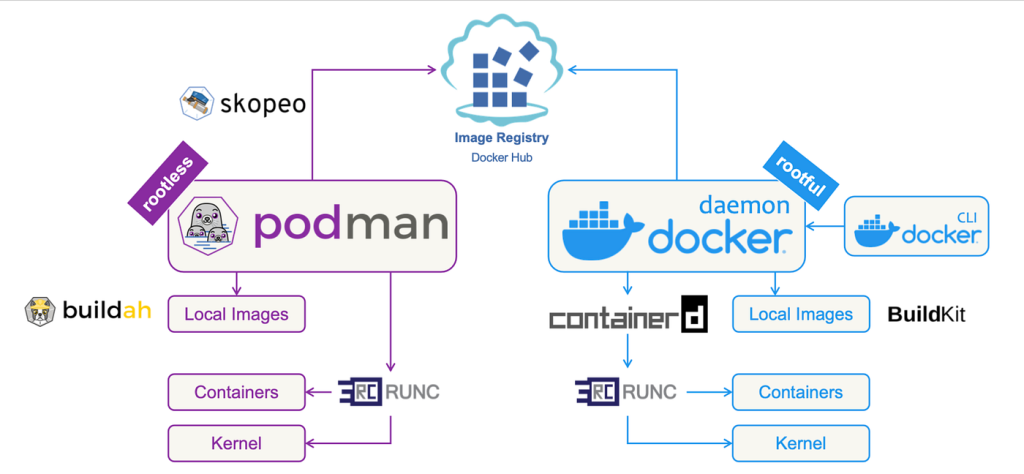
source: https://www.haikel-fazzani.eu.org/blog/post/podman-vs-docker
從圖片可以發現,Podman 與 Docker 最大的差異,就是 Podman 不需要 Docker Daemon,也不依賴 containerd。
Podman 採用 Daemonless Architecture(無中央常駐服務架構)。
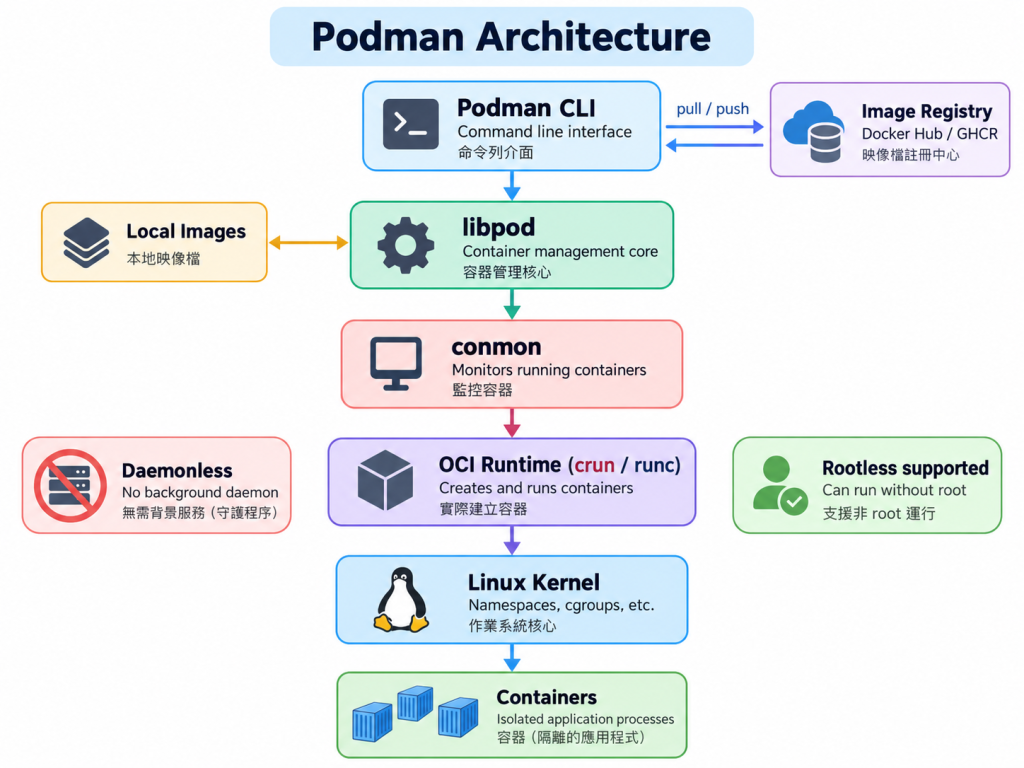
Podman CLI 可以直接透過內部的 libpod 函式庫管理容器,不需要另外啟動類似 dockerd 的中央背景服務。
其中,conmon 是負責監控 Container 的背景程序,例如管理容器的標準輸入輸出及結束狀態。真正建立 Container 的工作,則交給 crun 或 runc 等低階 Container Runtime。
這裡要特別注意:Daemonless 並不代表 Podman 完全沒有背景程序,而是它不需要像 Docker 一樣依賴中央 Docker Daemon。
| 比較項目 | Docker | Podman |
|---|---|---|
| 定位 | 完整的容器管理平台 | 完整的容器管理工具 |
| 核心架構 | Client-Server | Daemonless |
| 中央 Daemon | 需要 dockerd | 不需要 |
| 容器管理 | dockerd、containerd | libpod、conmon |
| 低階 Runtime | 通常使用 runc | 通常使用 crun 或 runc |
| Rootless | 支援 | 支援,且設計上特別重視 |
| Kubernetes CRI | 需要 cri-dockerd | 不直接支援 |
另外,圖片中出現的 Buildah 和 Skopeo,是與 Podman 經常搭配使用的獨立工具。
Buildah 專門負責建立 Container Images,而 Skopeo 則可以檢查、複製及傳輸 Images,不一定需要先下載到本地端。
不過,這不代表每次執行 podman build 都需要另外安裝 Buildah CLI,Podman 本身就具備 Image 建置能力。
最後,兩者雖然使用不同架構,但都能執行符合 OCI 標準的 Container Images,因此同一個 Nginx Image 通常可以同時使用 Docker 和 Podman 執行。
簡單記住:Docker 透過 dockerd 統一管理容器,Podman 則直接透過 libpod 管理容器;兩者最終都會使用 crun、runc 等低階 Runtime 建立 Container。
答案取決於我們討論的是哪個層級。
廣義來說,Docker Engine 和 Podman 都具備執行及管理 Container 的能力,因此可以被視為容器引擎或完整的容器執行管理工具。
但是,在 Kubernetes 的 CRI 架構中,Container Runtime 有更明確的技術要求:必須能夠透過 CRI 接收 kubelet 的指令。
例如:
              kubelet
                 │
                 │ CRI
                 ▼
        ┌────────┴────────┐
        │                 │
        ▼                 ▼
    containerd           CRI-O
        │                 │
        ▼                 ▼
       runc            crun/runc
        │                 │
        ▼                 ▼
    Container         Container
containerd 透過內建的 CRI Plugin 支援 Kubernetes,而 CRI-O 則是專門為 Kubernetes CRI 設計的 Container Runtime。
Docker Engine 本身沒有直接實作 CRI。如果希望 Kubernetes 使用 Docker Engine,就需要額外安裝 cri-dockerd 作為轉接元件。
至於 Podman,它沒有直接提供 Kubernetes 所需的 CRI 介面,不能直接取代 containerd。雖然 Podman 與 CRI-O 共用部分底層技術,但它們是兩個不同專案。
這也是為什麼 Kubernetes 從 v1.24 移除內建的 dockershim 後,仍然可以正常執行使用 Docker 建立的 Image。
因為 Kubernetes 並不依賴 Docker Engine 才能執行 Container。
記住:Docker 和 Podman 是完整的容器管理工具;containerd 和 CRI-O 則可以直接作為 Kubernetes 的 CRI Runtime;runc 和 crun 則負責更底層的容器建立與執行。
回到我們的 kind 環境,Mac 上的 Docker 負責建立 kind Node,而 Node 內部的 kubelet 則透過 CRI 與 containerd 溝通,兩者並不衝突。
因為我們目前使用 kind 建立 Kubernetes Cluster,所以實際上會有兩個層級。
Mac
 │
 ▼
Docker
 │
 ▼
kind Node(Docker Container)
 │
 ├── kubelet
 │      │
 │      │ CRI
 │      ▼
 └── containerd
        │
        ▼
       runc
        │
        ▼
    Pod Containers
Docker 負責在 Mac 上建立模擬 Kubernetes Node 的 Container,而 Node 內部則由 containerd 負責執行 Kubernetes 的 Pod Containers。
這也是為什麼我們之前需要執行:
kind load docker-image cka-api:v4 \
  --name cka-lab
因為 Mac 上 Docker 所持有的 Image,不會自動出現在 kind Node 內部的 containerd Image Store。
crictl 是透過 CRI 與 Container Runtime 溝通的命令列工具,適合用來觀察及排查 Node 上的容器問題。
首先進入 kind 的 Control Plane Node:
docker exec -it cka-lab-control-plane bash
接著執行:
crictl ps
這個指令會列出目前正在執行的 Container,例如:
kube-apiserver
kube-scheduler
kube-controller-manager
etcd
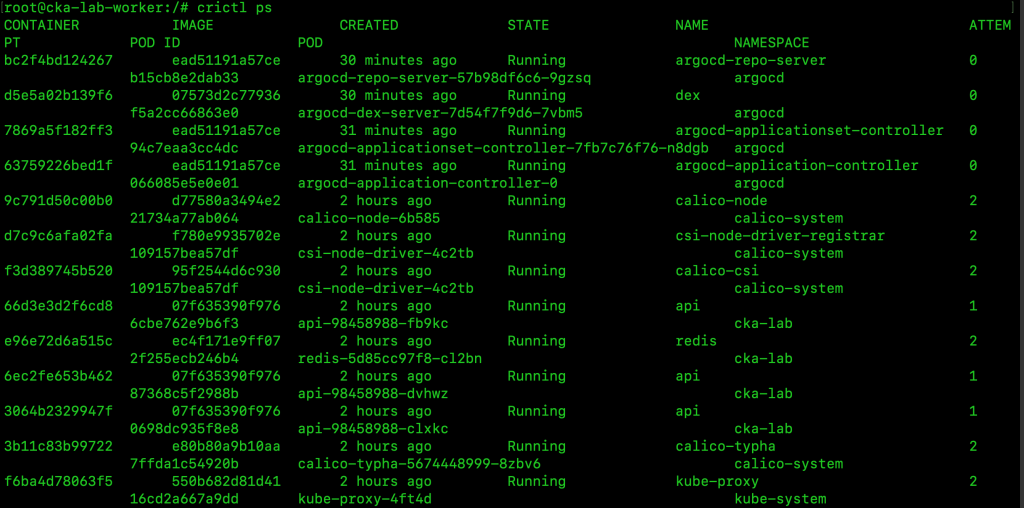
如果改成:
crictl pods
則會列出目前 Runtime 所管理的 Pod Sandbox。
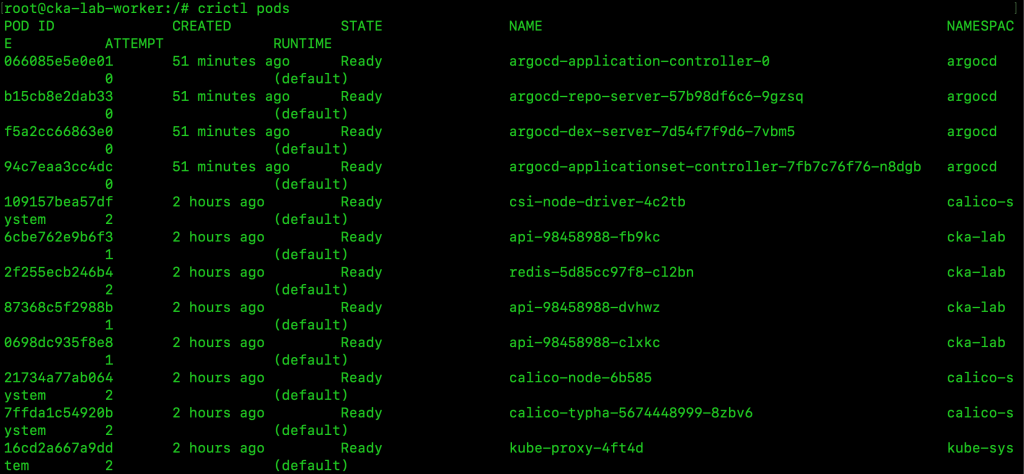
什麼是 Pod Sandbox?
Kubernetes 的一個 Pod 可以包含多個 Container,而這些 Container 通常需要共用相同的網路環境,例如 IP Address 和 Network Namespace。
Pod Sandbox 就是 Container Runtime 為 Pod 建立的底層執行環境。以常見的 Linux 實作來說,通常會透過一個特殊的 Pause Container 維持 Pod 的 Network Namespace。
Pod Sandbox
 │
 ├── Pause Container
 │
 ├── Application Container
 │
 └── Sidecar Container

共用相同的 Pod Network Namespace
因此,crictl pods 看到的是 Runtime 層級的 Pod Sandbox,而不是 Kubernetes API Server 中儲存的 Pod Object。
兩者雖然有對應關係,但管理層級不同。
記住:
kubectl 是透過 Kubernetes API 管理 Cluster 資源;crictl 則是透過 CRI 直接觀察及管理 Node 上的 Container Runtime。
平常我們很習慣:
kubectl get pods
kubectl describe pod
kubectl logs
但是這些指令都有一個共同前提:
API Server 要正常。
如果今天:
kube-apiserver 掛掉
你可能連:
kubectl get nodes
都無法使用。
但是 Node 本身還活著。
這時就可以直接進 Node:
crictl ps
看看 Container。
甚至:
crictl logs <container-id>
直接查看 Runtime 裡面的 Container Log。
所以 Troubleshooting 能力會從原本:
kubectl
再往下一層延伸成:
kubectl
↓
kubelet
↓
CRI
↓
containerd
↓
Container
這也是 CKA 很重要的思考方式。
目前整個:
cka-lab
是 kind 幫我們建立的。
所以很多 Cluster Bootstrap 細節都被自動處理掉了。
但是 CKA 還是需要理解:
kubeadm
kubeadm 可以簡單理解成:
官方提供的 Kubernetes Cluster Bootstrap 與 Lifecycle 管理工具。
如果我們真的準備兩台 Linux VM:
VM1
Control Plane

VM2
Worker
Control Plane 常會從:
kubeadm init
開始。
建立完之後,kubeadm 會提供類似:
kubeadm join <control-plane-ip>:6443 \
  --token ... \
  --discovery-token-ca-cert-hash ...
接著在 Worker Node 執行:
kubeadm join ...
Worker 就會加入 Cluster。
kubeadm init 並不是只建立一個 Pod。
它其實會處理一整套 Cluster Bootstrap 工作。
例如:
建立 Kubernetes PKI
建立 kubeconfig
建立 Control Plane Static Pod Manifest
設定 etcd
啟動 Control Plane
建立 Bootstrap Token
產生 Worker Join 資訊
其中跟今天最直接相關的就是:
/etc/kubernetes/manifests
因為 kubeadm 會建立:
kube-apiserver.yaml
kube-controller-manager.yaml
kube-scheduler.yaml
etcd.yaml
接著 kubelet 看到這些 Manifest:
kubelet
↓
Static Pod
↓
Control Plane 啟動
整條流程就串起來了。
這裡也要避免一個誤解。
kubeadm 並不是:
Deployment 管理工具
你不會用 kubeadm:
部署 FastAPI
更新 Redis
Scale Application
這些還是交給:
kubectl
Helm
Kustomize
GitOps
之類的工具。
kubeadm 主要處理的是:
Cluster Bootstrap
Cluster Upgrade
Certificate
Node Join
Cluster Lifecycle
也就是 Kubernetes Cluster 本身。
剛才提到 kubeadm 會建立:
PKI
PKI 全名:
Public Key Infrastructure
可以先把它理解成:
一套利用 Certificate 與 Private Key 建立身分驗證與加密通訊的機制。
Kubernetes Control Plane 不是讓:
API Server
etcd
kubelet
彼此隨便連線。
大量通訊都會使用:
TLS
進行加密與身分驗證。
進 Control Plane:
docker exec \
  -it \
  cka-lab-control-plane \
  bash
查看:
ls /etc/kubernetes/pki
會看到很多:
.crt
.key
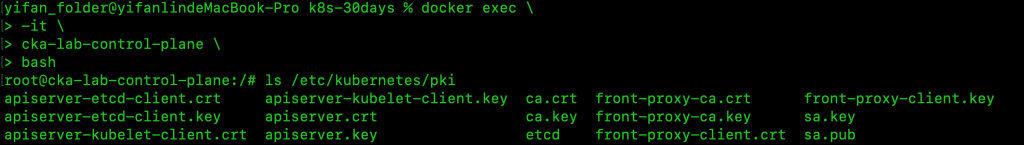
其中:
.crt
通常是 Certificate。
.key
則是 Private Key。
Kubernetes Certificate 不是永遠有效。
如果是 kubeadm 管理的 Certificate,可以使用:
kubeadm certs check-expiration
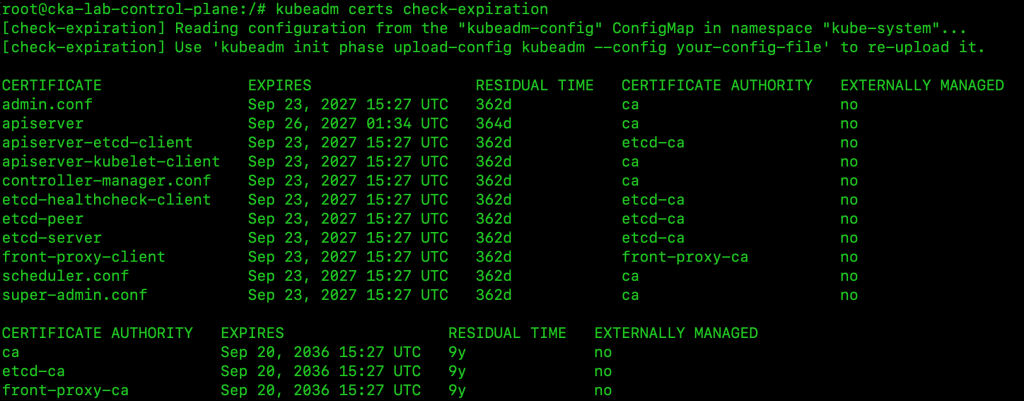
查看到期時間。
也可以直接使用:
openssl x509 \
  -in /etc/kubernetes/pki/apiserver.crt \
  -noout \
  -subject \
  -issuer \
  -dates
你會看到:
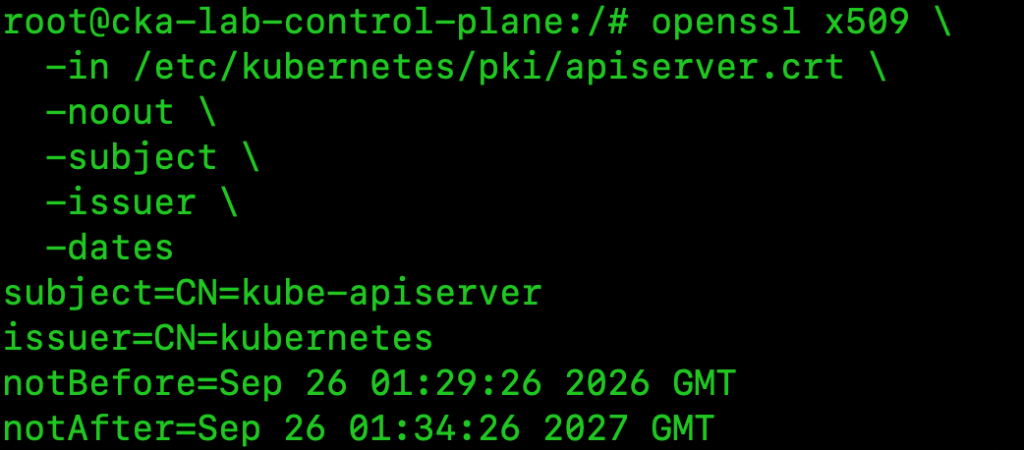
其中:
subject
代表這張 Certificate 的身分。
issuer
代表誰簽發它。
notBefore
代表開始有效時間。
notAfter
代表到期時間。
在 Production Cluster 裡,如果 Certificate 過期,可能直接造成 Control Plane Component 無法正常互相信任,因此這不是單純的小問題。
前面我們其實已經學過:
cordon
drain
uncordon
當時可能覺得只是 Node Maintenance 指令。
現在可以把它放回完整的:
Cluster Lifecycle
來看。
例如真正 kubeadm Cluster Upgrade,大致會經歷:
升級 kubeadm
↓
kubeadm upgrade plan
↓
kubeadm upgrade
↓
升級 kubelet
↓
處理下一台 Node
處理 Worker Node 前通常還會:
kubectl cordon <node>
或:
kubectl drain <node>
升級完成後再:
kubectl uncordon <node>
所以以前學過的:
Node Maintenance
現在終於開始跟:
Cluster Upgrade
串在一起。
這裡要特別說清楚。
kind 非常適合我們現在這套 30 Days Lab。
拿來練:
Pod
Deployment
Service
Scheduling
CNI
NetworkPolicy
Storage
RBAC
Helm
Kustomize
Troubleshooting
都非常方便。
但是 kind 的 Node 本質上是:
Docker Container
所以它無法完整模擬真正 Linux Server 的所有管理情境。
如果真的要練:
安裝 containerd
關閉 swap
設定 kernel module
設定 sysctl
安裝 kubelet
安裝 kubeadm
kubeadm init
kubeadm join
systemctl
journalctl
OS package upgrade
最好另外準備至少:
2 台 Linux VM
例如:
VM1
Ubuntu
Control Plane

VM2
Ubuntu
Worker
完整從零做一次 kubeadm Cluster。
但平常練 Kubernetes Resource,還是繼續使用 kind 就好。
這樣最省資源,也最有效率。
今天其實做了一件很重要的事情:
我們第一次真正把 Kubernetes 黑盒子打開。
以前看到的是:
kubectl
↓
Kubernetes
現在開始知道底下其實還有很多層:
/etc/kubernetes/manifests
        │
        ▼
      kubelet
        │
        ▼
   Static Pods
        │
        ├── kube-apiserver
        ├── kube-scheduler
        ├── kube-controller-manager
        └── etcd
Worker Node 則可以理解成:
Node
 │
 ├── kubelet
 │      │
 │      ▼
 │     CRI
 │      │
 │      ▼
 └── containerd
        │
        ▼
     Containers
平常 Cluster 正常時,我們站在:
kubectl
這一層操作。
但如果:
API Server 掛掉
就要開始往下看:
Static Pod
kubelet
containerd
crictl
這才是真正的 Kubernetes Troubleshooting。
而 kubeadm 則把今天這些概念串到:
Cluster Bootstrap
Certificate
Node Join
Cluster Upgrade
Cluster Lifecycle
明天我們會再往 Kubernetes 最核心的地方深入一層:
etcd
因為 Application Pod 壞掉:
Deployment 可以重新補 Pod。
但如果:
etcd 裡面的 Cluster State 壞掉
問題就不是「某個 Pod 壞了」。
而是:
整個 Kubernetes Cluster 的狀態都可能受到影響。
所以接下來就要理解:
etcd 到底存了什麼?
Snapshot 是什麼?
Backup 怎麼做?
Restore 又怎麼做?
這會是 Cluster Administration 非常重要的一關。


 iThome鐵人賽
 看影片追技術