
我最初找 AI Gateway 的條件很直接:把不同 LLM Provider 收進同一個 OpenAI-compatible Endpoint,再補上 Routing、Fallback、Virtual Key、Budget 與管理介面。只看功能表,LiteLLM 幾乎每一格都打中需求。
把方案放進 Kubernetes 後,評估的問題開始改變。除了 Proxy,我們還要接手 PostgreSQL、Redis、Migration、Team/User State,以及為了配合 GitOps 補上的 API 與 Terraform Glue。這些元件都能運作,真正難回答的是「誰要長期維運這套平台」「Git 能不能重建狀態」「員工離職時要從哪裡撤權」。
LiteLLM 並沒有在評估途中突然少掉某項功能。當需求從統一 LLM Endpoint,擴大到 LLM、MCP 與 A2A 共用的 Policy 和 Telemetry Boundary,原本排在前面的 UI 與 Virtual Key,便不再是最重要的選型條件。真正讓決定翻轉的,是我們要長期經營哪一種平台。
LiteLLM 同時是一層多 Provider Translation/Routing Layer 與 LLM Gateway。應用程式只要更換 base_url,便能用相近的介面呼叫不同模型。真正的 Provider Key 留在 Proxy,Application Repository 不必各自保存一份。再加上 Virtual Key、Rate Limit、Budget、Spend Tracking、Fallback 和 UI,它很自然會成為共用模型入口的候選方案。
官方 Proxy Architecture 會在 Request Path 上處理 Virtual Key、Budget、Rate Limit、Router 與 Provider Translation,Response 回來後再更新 Spend 與 Logging Callback。PostgreSQL 保存 Key、Team 和 Spend,Redis 負責 Cache 與 Rate-limit Counter。這是一套完整的 LLM Management 架構,也意味著平台團隊接手的從來不只一個 Proxy Pod。
我評估 LiteLLM 時,後來的供應鏈事件還沒有發生。當時的 Kubernetes Snapshot 落在 1.80.x 世代,去掉內部網域、Registry 與 Credential 後,實際 Inventory 大致如下:
LiteLLM Proxy
├── provider routing / fallback
├── virtual key / team / budget
├── management UI
├── PostgreSQL
├── Redis
├── database migration job
└── API + Terraform management glue
最後一層 API + Terraform Glue 是我們自己補上的整合,用來讓 Team 與 User 管理符合既有交付方式。LiteLLM 當時已經能跑,選型卡住的是這些狀態日後要如何維運。
我們習慣在 Pull Request 裡 Review 變更,由 Git 保存 Diff,再讓 Controller 將宣告狀態收斂進 Kubernetes。LiteLLM 的 Model List 可以寫進設定檔,Team、User、Virtual Key 與部分管理狀態則主要透過 UI、API 和資料庫操作。為了把這些資料納入 IaC,我們曾用 Terraform 呼叫管理 API,建立前先查 Team ID,刪除時再找一次 ID,最後送出 Delete Request。
流程可以跑通,Terraform State 卻只知道自己呼叫過 API,不知道產品資料庫裡是否有人從 UI 改過值,也不會像 Kubernetes Controller 一樣持續 Reconcile。當 Resource ID 重建,或 UI 與 Git 出現 Drift,維運者面對的是一組腳本約定,不是能自動回到 Desired State 的 Control Plane。
Identity 也出現第二份 Mapping。企業 IdP 已經知道值班工程師屬於哪個 Team,Gateway 裡又建立了 Human → LiteLLM User → Team → Virtual Key。Virtual Key 很適合追 Usage 與 Budget,員工離職、轉調或換組時,平台仍要確保這份 Mapping 同步撤權。知道一把 Key 花了多少錢,和證明某次 Request 由哪位 Human 授權,是兩個不同問題。
高可用也不能只數 Proxy Replica。PostgreSQL、Redis、Migration、Connection Pool、Background Spend Write 與 UI State 都需要 Backup、Upgrade、Recovery 和 On-call Owner。這些不是 LiteLLM 的缺陷,而是選擇這種 Operating Model 後,團隊必須一起接下來的責任。
當時 UI 確實有些操作不太順手,但我不想把選型濃縮成「UI 不好用,所以換掉」。UI 會改版,功能也可能補齊。Source of Truth、Identity Lifecycle 和 On-call Responsibility 才是比較不會靠下一版自動消失的差異。
最早那種 Provider 數量 5 分、UI 4 分、效能 4 分 的評分方式看似客觀,實際上很容易等答案出來後再調權重。我們後來改用 AI Gateway 平台選型 Scorecard,每個決策面都先寫清楚產品外的 Owner,再標示依據來自實際操作、當時 Snapshot、官方文件或架構判斷。
正文只留下最影響這次結果的六列:
| 決策面 | Application Team 容易先看見 | Platform Team 還要回答 |
|---|---|---|
| Provider Routing | API 相容、Fallback、Retry | Provider Lifecycle、Quota 與例外由誰處理 |
| Consumer 管理 | Key、Budget、Rate Limit | Key 代表 Human 還是 Workload,離職時從哪裡撤權 |
| Protocol | LLM Request 能不能通 | MCP/A2A Action 能否進入同一個 Policy Boundary |
| Declarative Delivery | 有沒有 YAML/API | Git Review、Reconcile、Drift 與 Rollback |
| Runtime Dependencies | Helm 能不能安裝 | DB、Cache、Migration、Backup、Upgrade 與 On-call |
| Audit | 有沒有 Usage/Request Log | 誰代表誰、透過哪個 Workload、存取哪個 Resource |
若團隊只是想快速統一 Provider、收回 Provider Key、按專案限制 Budget,再提供一個方便操作的 UI,LiteLLM 很可能是更省時間的答案。我們把 Kubernetes Reconciliation、Identity-aware Policy 與跨 Protocol Traffic Boundary 放在較高權重,才得到不同結果。Scorecard 必須連同 Workload 與組織條件一起閱讀,不能拿去當通用排名。
agentgateway 的 Data Plane 能代理 HTTP、gRPC、LLM、MCP 與 A2A 流量,Kubernetes 模式則由 Controller Watch Gateway API 與相關 Resource,產生 Runtime Config,再透過 xDS 送到 Data Plane。Route、Backend、Policy 與 Gateway Lifecycle 都從 Kubernetes API 進場,變更能沿用原本的 Git Review 與 Reconciliation。
Git / Kubernetes API
        │
        ▼
controller / control plane
        │ xDS
        ▼
agentgateway data plane
        ├── LLM provider
        ├── MCP server
        └── A2A agent
我們實際轉向時使用的是 1.3.x 前後的 Snapshot,不會把後來文件中的全部能力倒寫成當時已驗證。能用第一人稱確認的是,kagent ModelConfig 發出的 LLM 流量、Remote MCP、JWT 與 Per-tool Policy 等特定路徑確實在 Kubernetes 串過。A2A、kagent 與 BYO Agent 的能力邊界,會在 Day 16–18 各自處理。
真正影響選型的不是「Rust 一定比 Python 好」,而是 LLM、Tool 與 Agent Traffic 可以經過共同的 Enforcement Point,Identity、Policy Decision 和 Telemetry 也比較有機會使用一致欄位。這個 Control Plane 與 Traffic Path 的組合,比單純多一個 Provider Adapter 更接近我們原有的平台工作方式。
Day 12 已讓 agentgateway 驗證 AWS Cognito 發出的 Human/M2M Token,並依 client_id、aud 與 Scope 分流。那只處理 Token 進入 Gateway 後的 Request。MCP Client 在登入前怎麼找到 Authorization Metadata、Client 要預先註冊還是使用 Client Metadata,以及 AWS Cognito 缺少的 Provider Adapter 由誰維護,仍需要另外指定 Owner。
登入與取 Token
MCP client → authorization metadata → registration → AWS Cognito

帶 Token 呼叫
MCP client → agentgateway → JWT / Tool policy → MCP server
第一段屬於 IdP、Client Registration Process 與必要的 Adapter,第二段才進入 agentgateway 的 Runtime Traffic Path。公開 Lab 不會為了看起來接近企業環境,就把 LiteLLM 和 agentgateway 串成兩層 Proxy。多一層不會自動補齊 Discovery,反而新增 Timeout、Streaming、Header、Retry、Authentication 與 Audit Attribution 的責任。
下圖把原始選型與事後事件分成兩條時間線。上半部是當時真正影響決定的 Operating Model 與 Identity Mapping,下半部則是轉向 agentgateway 後才發生的 LiteLLM 供應鏈事件,以及後續改善。
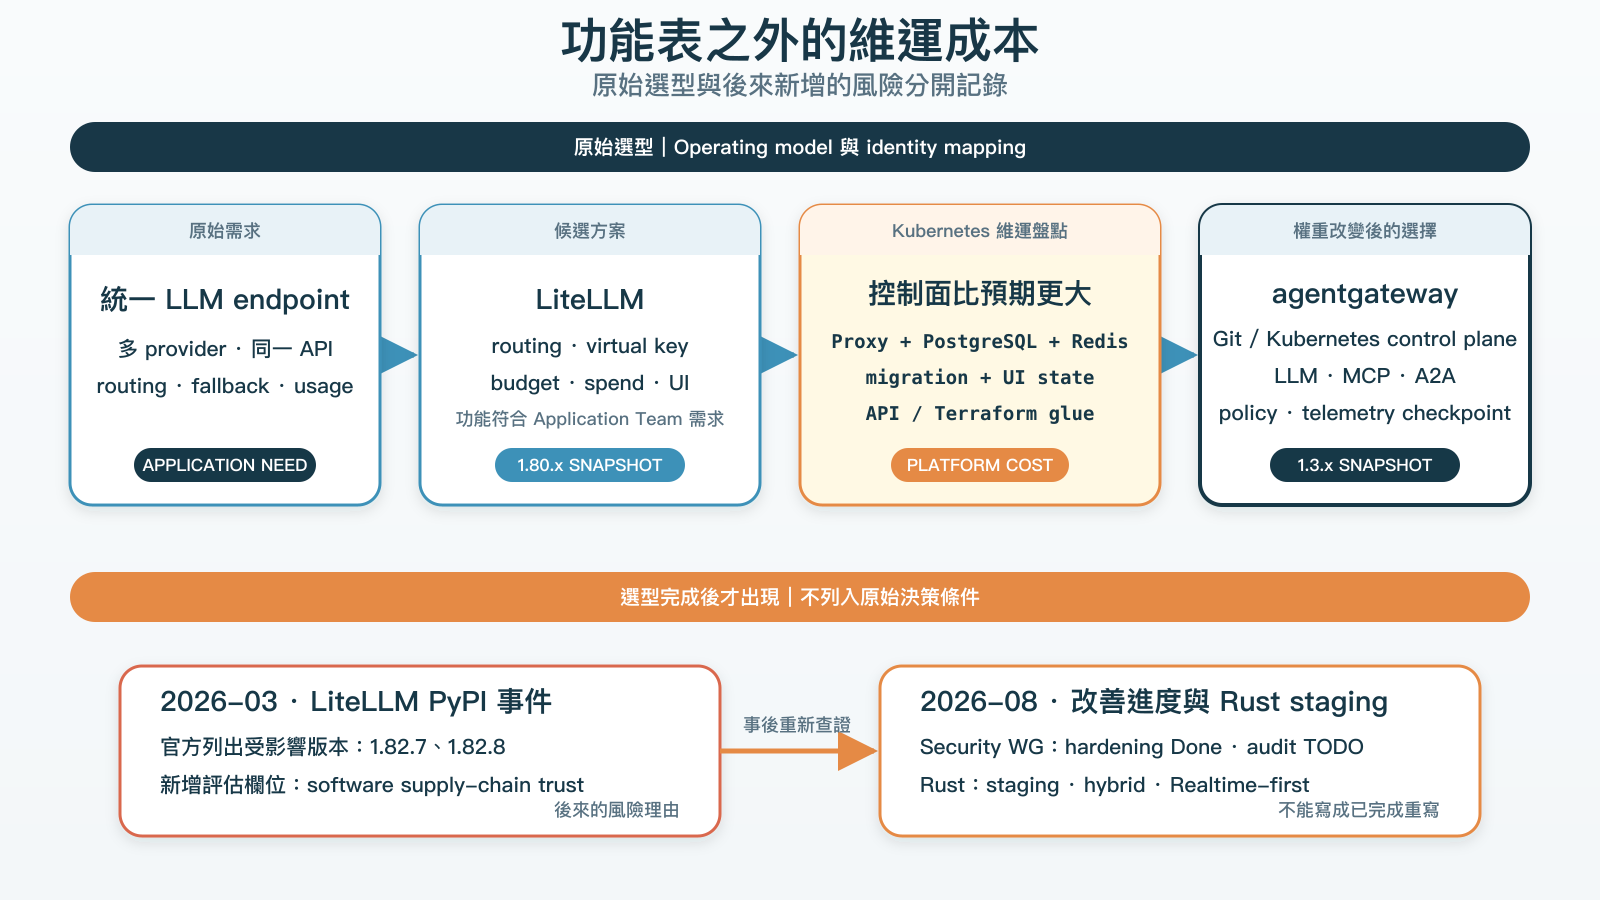
官方事件 Issue 列出 PyPI 1.82.7 與 1.82.8 遭植入惡意程式,可能蒐集並外傳 Credential。維護團隊移除受影響套件、輪替 Maintainer 帳號,並在調查期間暫停 Release。Issue 也說明,當時使用 Proxy Docker Image 的人不在公告列出的影響範圍。
這次事件發生時,我們已經完成轉向。當初的決定仍是維運與身分模型的取捨。事件讓往後的評估多了一組固定問題:Image 和套件從哪裡來、出事後誰能確認影響範圍,以及平台要花多久取得修補版本。Signature、SBOM 與 Release Provenance 因此進入後續選型,不會改寫當時的時間線。
2026 年 8 月重新查證時,LiteLLM Security Working Group 已列出完成與尚待處理的 Hardening 項目,Release 也提供 Image Verification。LiteLLM 同時有一個 Rust Gateway Staging Project,目前公開內容仍偏向 Realtime Hot Path 與 Python Bridge,不能直接解讀成整套 Proxy 已重寫。這些改善值得記錄,卻尚未回答 Team/User State、Identity Mapping 與 GitOps Reconciliation。它們是不同層次的問題。
我們最後把 agentgateway 放在 LLM、MCP 與 A2A Runtime Traffic 的共同 Policy/Telemetry Checkpoint,因為它的 Kubernetes Control Plane 比較符合既有 GitOps 工作方式。Identity Provider、Client Registration、Agent Runtime、Tool Ownership、Delegation Context 與 Telemetry Backend 仍由不同系統負責,沒有因為選了一個 Gateway 就全部消失。
LiteLLM 的 Routing、Virtual Key、Budget、Spend 與 UI 依然很實用。當初真正用錯的是讓 Virtual Key 同時承擔 Consumer Isolation、用量歸屬與 Human Identity,結果一把 Key 扛了太多語意。
下一篇會把這筆帳拆開。Human Virtual Key、Workload Consumer Key 與 JWT Principal 都能讓 Request 通過,Rotation、Offboarding、Delegation 與 Audit 留下來的答案卻完全不同。


 iThome鐵人賽
 看影片追技術