
assert,心理上很難受,但那是回歸防護的前提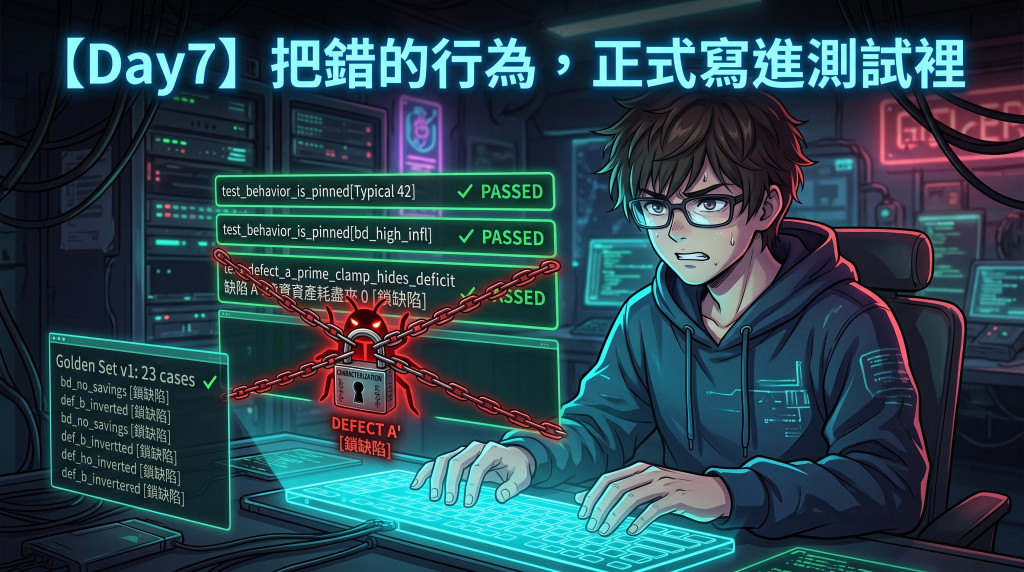
昨天的差分測試證明了兩份實作一致。今天要做的是把「一致」變成「固定」。
(Characterization test:不評斷程式對錯,只忠實記錄它現在的行為,當作往後改動的基準線。Michael Feathers 在處理沒有測試的老系統時提出的做法。這個定義我照書上的意思寫,但那本書我還沒讀完,第二幕之前會補。)
四個缺陷我都找到了,機制都清楚,改起來最多一小時。
但如果現在就改,我會失去唯一一次「知道它原本怎麼動」的機會。
Day 30 我要部署修復版。那天我需要回答一個問題:改完之後,哪些行為變了? 目標金額變了——那是修好的。可是累積期的數字也跟著動了一點——那是修好的,還是我順手改壞了別的?
沒有一份釘死現況的紀錄,這兩者長得一模一樣。
所以順序是:先固化,再修復。 而且固化的內容必須包含錯的部分。
23 組,五類:
| 類別 | 組數 | 內容 |
|---|---|---|
| 典型軌跡 | 4 | 25 歲起步、42 歲(去年那組)、55 歲晚起步、50 歲提早退休 |
| 邊界 | 6 | 報酬率 0%、通膨 0%、退休後只有一年、零本金零月存、報酬率 15%、通膨 6% |
| 收入 | 4 | 勞保 65 起、勞保晚領 70 起、勞保+勞退、收入大於支出 |
| 大筆支出 | 4 | 75 歲一筆、退休當年、壽命當年、三筆並存 |
| 缺陷現況 | 5 | 壽命倒掛、壽命=退休年齡、95 歲幽靈支出、100 歲幽靈支出、資產耗盡夾 0 |
每一組記下五個數字:累積資產、目標金額、缺口、最後一年的真實餘額、最後一年圖表上的餘額。
最後兩個要分開記,是因為缺陷 A'——它們在資產耗盡的情境下不一樣,而那個不一樣正是缺陷本身。
bd_no_savings 這組:零本金、零月存、月支出 3 萬。
它記下來的期望值是這樣的:
"final_balance_raw": -21232803.177890684,
"final_balance_charted": 0.0
真實餘額負兩千一百萬,圖表上是 0。
而我把這兩個數字都寫進了 assert。也就是說,從今天開始,如果有人「修好」了那行 Math.max(0, ...),讓圖表誠實顯示負值——我的測試會變紅。
這件事在心理上很難接受。測試理應是品質的防線,而我剛剛用它把一個已知缺陷焊死了。
但這正是 characterization test 的意思:它記錄的是真實,不是期望。 這一版的「真實」就是有一塊遮羞布。
真正的保護在於,那條斷言變紅的時候我會知道有人動了那行。到時候如果是 Day 30 的我在修,紅燈是預期中的;如果是別人不小心改到的,紅燈就攔住了他。
至於「不要讓錯的東西看起來像對的」——那件事得靠標記。
專門鎖缺陷的那四條測試好辦,它們放在一個叫「以下四條鎖的是缺陷本身。它們現在『通過』,代表缺陷還在。」的區塊裡,每一條的 docstring 都寫著它在鎖什麼:
def test_defect_a_prime_clamp_hides_deficit():
    """缺陷 A':真實餘額為負時,圖表資料被夾成 0。"""
    ...
    assert r.balances_raw[-1] < 0
    assert r.balances_charted[-1] == 0.0
讀到這段的人不會誤會它是正確行為。
麻煩的是 golden set 這 23 組。它們全部跑同一條參數化測試,docstring 只有一句「每一組的輸出必須與 golden set 記錄的完全一致」——bd_no_savings 那個負兩千一百萬混在裡面,看不出跟其他 22 組有什麼不同。
所以我在 golden set 裡多加了一個 locks_defect 欄位,寫明這組鎖的是哪個缺陷、機制是什麼。加完之後數了一下,23 組裡有 8 組帶著這個欄位。
不是 5 組。
我原本以為只有「缺陷現況」那一類的 5 組。實際多出來的三組是 bd_zero_return、bd_no_savings、bd_high_infl——它們都在「邊界」類,是為了測報酬率 0%、零本金、通膨 6% 而寫的,但那些極端輸入剛好會把資產耗光,於是順帶把 A' 的夾 0 也一起鎖了進去。
分類是我給的,缺陷不看分類。 我照著自己畫的格子放案例,缺陷從格子邊上滲進來三格。如果沒有真的去標,這三組會一直以「正常邊界案例」的身分待在檔案裡。
標完之後我把這個欄位接到測試名稱上,跑起來會是這樣:
test_behavior_is_pinned[bd_no_savings[鎖缺陷]] PASSED
test_behavior_is_pinned[bd_zero_infl] PASSED
標記寫在 JSON 裡只有翻檔案的人看得到,寫在測試輸出裡才擋得住那個正要「順手修好」的人。
除了 23 組快照,我另外寫了四條專門鎖缺陷的測試。它們比快照更精準——快照鎖的是「數字是多少」,這四條鎖的是「機制還在不在」。
缺陷B  target_fund==0 且 gap<0            : True
缺陷C  計入目標但圖上無痕跡                : True
缺陷A' 真實 -21,232,803 → 圖表 0          : True
缺陷A  期初/期末 = 1.0400000000            : True
差別在哪?我把通膨的處理方式弄壞了一次——膨脹指數少算一年——然後看誰會紅。
23 組快照紅了 18 組,四條機制斷言紅了一條。
沒紅的 5 組快照裡,只有 bd_zero_infl 是理所當然的,它的通膨本來就設 0%。另外四組(def_b_inverted、def_b_equal、inc_over、inc_both)的目標金額記錄的都是 0.00,跟昨天那 12 組 JS 端算出 0 的隨機案例,是同一行 Math.max(0, ...)。一個把值壓成 0 的動作,就在那裡挖出一塊測不到的區域。
紅掉的那條機制斷言是缺陷 A,比值變成 1.0608,也就是 1.04 × 1.02。原因是它為了算出「正確的期初值」,自己也寫了一遍通膨公式;我改了 calc.py 沒改它,兩邊就對不上。它把實作偷偷綁進了斷言裡,而我寫的時候並不知道。
快照抓「有沒有變」,機制斷言抓「變在哪」——但前提是斷言自己沒有跟著實作一起變。
七天,做完的事:
(1+r) 的閉式推導,以及那筆赤字的閉式解這些東西都放上來了:https://github.com/eyelash500/2026_ironman_test_ai/tree/day07
裡面有受測物本身的凍結快照(連同那個四缺陷全零的對照組)、抽取出來的 oracle、Python 影子模型、兩支測試、golden set,以及一份 decisions.md,記著每一個閘門當時是怎麼裁的、代價是什麼。
那個連結指到 day07 這個 tag,看到的會是今天當下的樣子。主分支會一路長到 Day 30,但這個網址不會被之後的進度蓋掉——寫在文章裡的東西,讀者應該還找得到。
要先講清楚:repo 裡那支受測物是有缺陷的版本,而且我刻意沒修。 它在那裡是為了被測,不是為了被用——想算自己的退休金,等 Day 30。
聽起來像很多,但它們全部只回答了同一個問題:它現在怎麼動。
沒有一項回答「它應該怎麼動」。
(1+r) 那個推導是唯一觸及「對錯」的——但它靠的是我對財務數學的認知,不是任何一份文件而那個認知,去年也曾經很有把握地認為這個工具沒問題。
明天開始問一個更根本的問題:這支工具到底該做什麼?
它上線一年,沒有 PRD、沒有需求文件、沒有任何一句話寫過「退休當年算不算支出」「錢該在年初還是年底離開帳戶」。
Day 2 引過一句話:程式執行器可以是完美的驗證者,前提是問題描述清楚指明了預期的執行行為。
那個前提,這支工具從來沒有滿足過。
寫那四條缺陷測試的時候,我改了三次命名。
一開始叫 test_bug_b。看起來很正常,但跑起來會是 test_bug_b PASSED——「bug B 通過了」。
改成 test_bug_b_still_exists,好一點,但斷言內容還是在講數字。
最後定成 test_defect_b_inverted_lifespan_yields_zero_target,長得要命,但它把機制寫在名字裡:壽命倒掛 → 目標金額為零。跑起來是這樣:
test_defect_b_inverted_lifespan_yields_zero_target PASSED
還是有點怪,但至少讀的人知道通過的是什麼。
在一個測試名稱上花二十分鐘,寫的時候覺得有點蠢。但這份檔案要活到 Day 30,那天我會在一堆綠燈裡找哪些該變紅——到時候能救我的不是斷言,是名字。
只帶走一件事
我花了七天證明它現在就是這樣動的,而這七天沒有任何一刻證明它動得對。


 iThome鐵人賽
 看影片追技術